11月15日、Robert Krzaczyńskiが「Anthropic Outlines Its AI-Powered Code Review Process for Claude Code」と題した記事を公開した。AnthropicがClaude Codeのコードベースに対してAIエージェントを活用したコードレビュープロセスを構築・運用している実態を詳述している。AIがコードを書く時代に、そのコードを誰がどうレビューするのか——Anthropicはその答えを実際の開発プロセスで試している。
PRが倍増しても、リバートは40%減
Claude.devのブログでAddy Osmani、Morgan Westlee Lunt、Qing Wangが明かしたところによると、Claude Codeのリポジトリへのマージ済みPRは6月から9月の間に2倍以上に増加した。AIエージェントがコードを大量に生成するようになった直接の結果だ。なお、claude.devはAnthropicが運営するClaude Code関連の公式ドメインである。
にもかかわらず、リバートが必要になった変更の割合は40%以上減少した。これが今回のプロセス見直しの核心にある数字である。
なぜAIエージェントによるPRがここまで急増したのか
背景として押さえておきたいのは、GitHub CopilotやCursor、そしてAnthropicの Claude Code自体に代表されるAIコーディングツールの急速な普及だ。開発者一人当たりのコード生成速度が大幅に向上した結果、PRの絶対数が人間のレビュー処理能力を超える速度で増加するという構造的な問題が業界全体で顕在化しつつある。Anthropicはその問題を自社の開発プロセスで真っ先に経験し、解決策を実装した事例として今回の内容を公開した格好だ。
レビューの構造:リスクに応じた多層チェック
Anthropicが採用したアプローチは、「人間が一行一行コードを読む」従来のレビューからの脱却だ。検証の多くをPR作成前に前倒しする設計になっている。
PR作成前の段階で、Claudeがテスト・ビルド・リンターを実行する。さらに別のエージェントが新鮮なコンテキストで変更をレビューする。
PR作成後は複数の自動チェックが走る。Claude搭載のレビュアーが潜在的なバグを検出し、複数のエージェントが独立して調査した上で、別のグループがその結果を検証する。セキュリティレビューも存在し、未解決の問題があればマージをブロックできる。
人間のレビューはリスクに応じて段階化されている:
- 低リスク(ドキュメント更新、フィーチャーフラグ配下の内部機能):人間の承認不要
- 中リスク:1名の承認が必要
- 高リスク:2名の承認が必要
- CIワークフローなど特に機密性の高い領域:常に人間の監視が必要
「コードレビューはテストと同義になったのか」
このアプローチはソフトウェアエンジニアリング、テスト、QAの境界線に関する問いも呼び起こしている。Xでは以下のような反応が見られた:
So code review is officially synonymous with testing now? Should the code review mechanism be owned by QA team? Is there still a QA team?
— @jaysonambrose
AIがコードを書き、AIがレビューし、自動テストが検証する。その構造の中で「QAチームとは何か」「コードレビューとは何か」という問いが改めて浮上している。なお、上記の投稿はURLのみの引用であり、スクリーンショットによる一次確認はできていないため、参照の際はリンク先で内容を確認されたい。
フィードバックの無限ループを防ぐ工夫
自動レビューが際限なくフィードバックを生成し続けることを防ぐ仕組みも設けられている。レビューサイクルは最大3ラウンドに制限され、それを超えると実装自体を再検討するよう著者に促される。また、後続のレビューはPR全体を繰り返し精査するのではなく、新しい差分にのみ焦点を当てる。
この調整の効果は数字に表れている。1回のレビューと修正でPRが通過する割合は65%から78%に上昇し、5ラウンド以上を要するPRの割合は8.9%から1.5%に低下した。
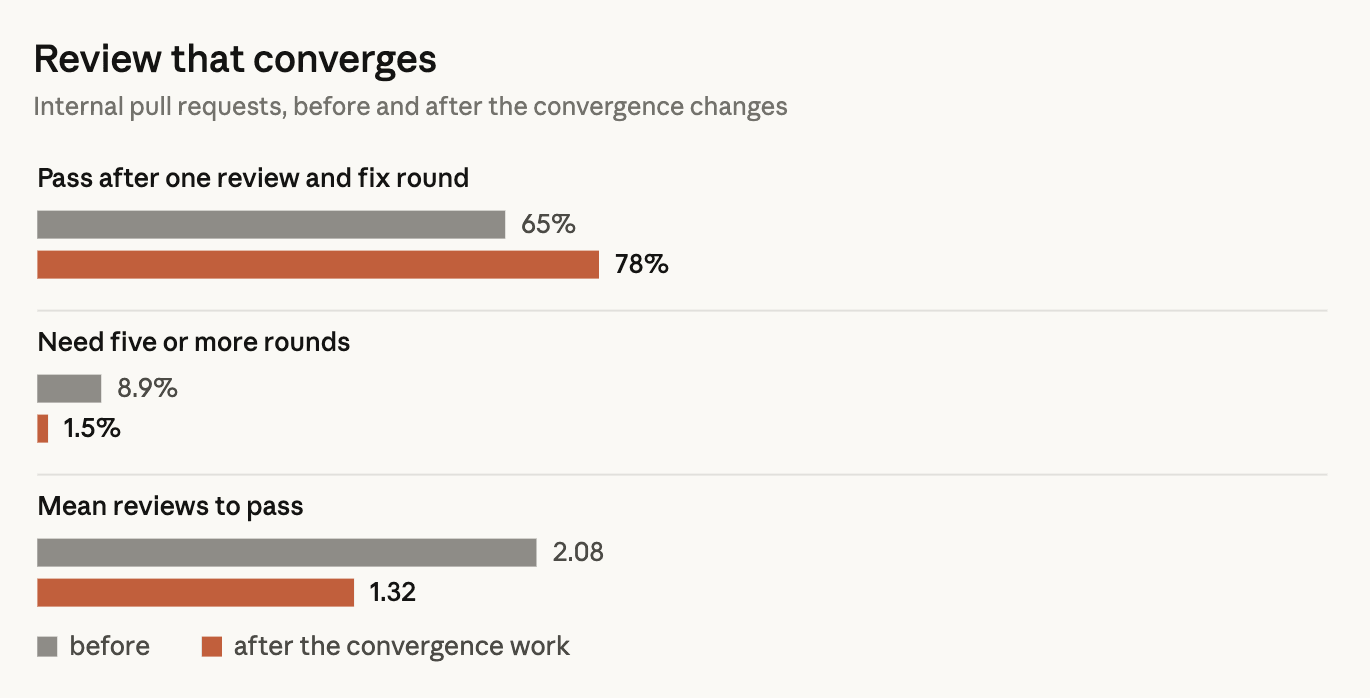
出典: Claude.dev
人間の役割は「何を承認するか」から「何に責任を持つか」へ
Anthropicは人間のレビュアーが依然として責任を持つ領域を明確にしている。アーキテクチャの意思決定、プロダクトの方向性、高リスクな変更、そして最終的なアウトカムだ。AIエージェントに指示を出す人間が、そのエージェントが生成したコードに対して責任を負うという立場も明示されている。
マージ後の変更はフィーチャーフラグ配下でリリースされ、社内でテストしてから段階的にロールアウトされる。インシデントやリバートされた変更は評価データセットに蓄積され、自動レビュアーの改善に使われる。
Anthropicが示したのは「人間が読んだコード量」ではなく「変更が持つリスク」を軸にコードレビューを再設計するという考え方だ。AI生成コードが増える中で、自動検証と人間の監視のバランスをどこに置くかは、多くのエンジニアリングチームが直面する問いになっていくだろう。
詳細はAnthropic Outlines Its AI-Powered Code Review Process for Claude Codeを参照していただきたい。
