11月4日、Sebastian Raschkaが「Open October LLM Architecture Roundup」と題した記事を公開した。わずか1ヶ月のあいだに1兆パラメータ級を含む10本のオープンウェイトモデルが立て続けにリリースされ、GQA・SWA・MoE・MLAといった多様なアーキテクチャが入り乱れる──Raschkaがこの10月を「Open October」と呼ぶほど異例の密度だった。
1ヶ月で10モデル──"Open October"と呼ぶべき10月
Raschkaはこの10月を「Open October」と表現した。わずか1ヶ月の間に、GQA・SWA・MoE・MLAといった多様なアーキテクチャを採用したオープンウェイトモデルが10本リリースされたためだ。以下にその全モデルをまとめる。
注目アーキテクチャを押さえる
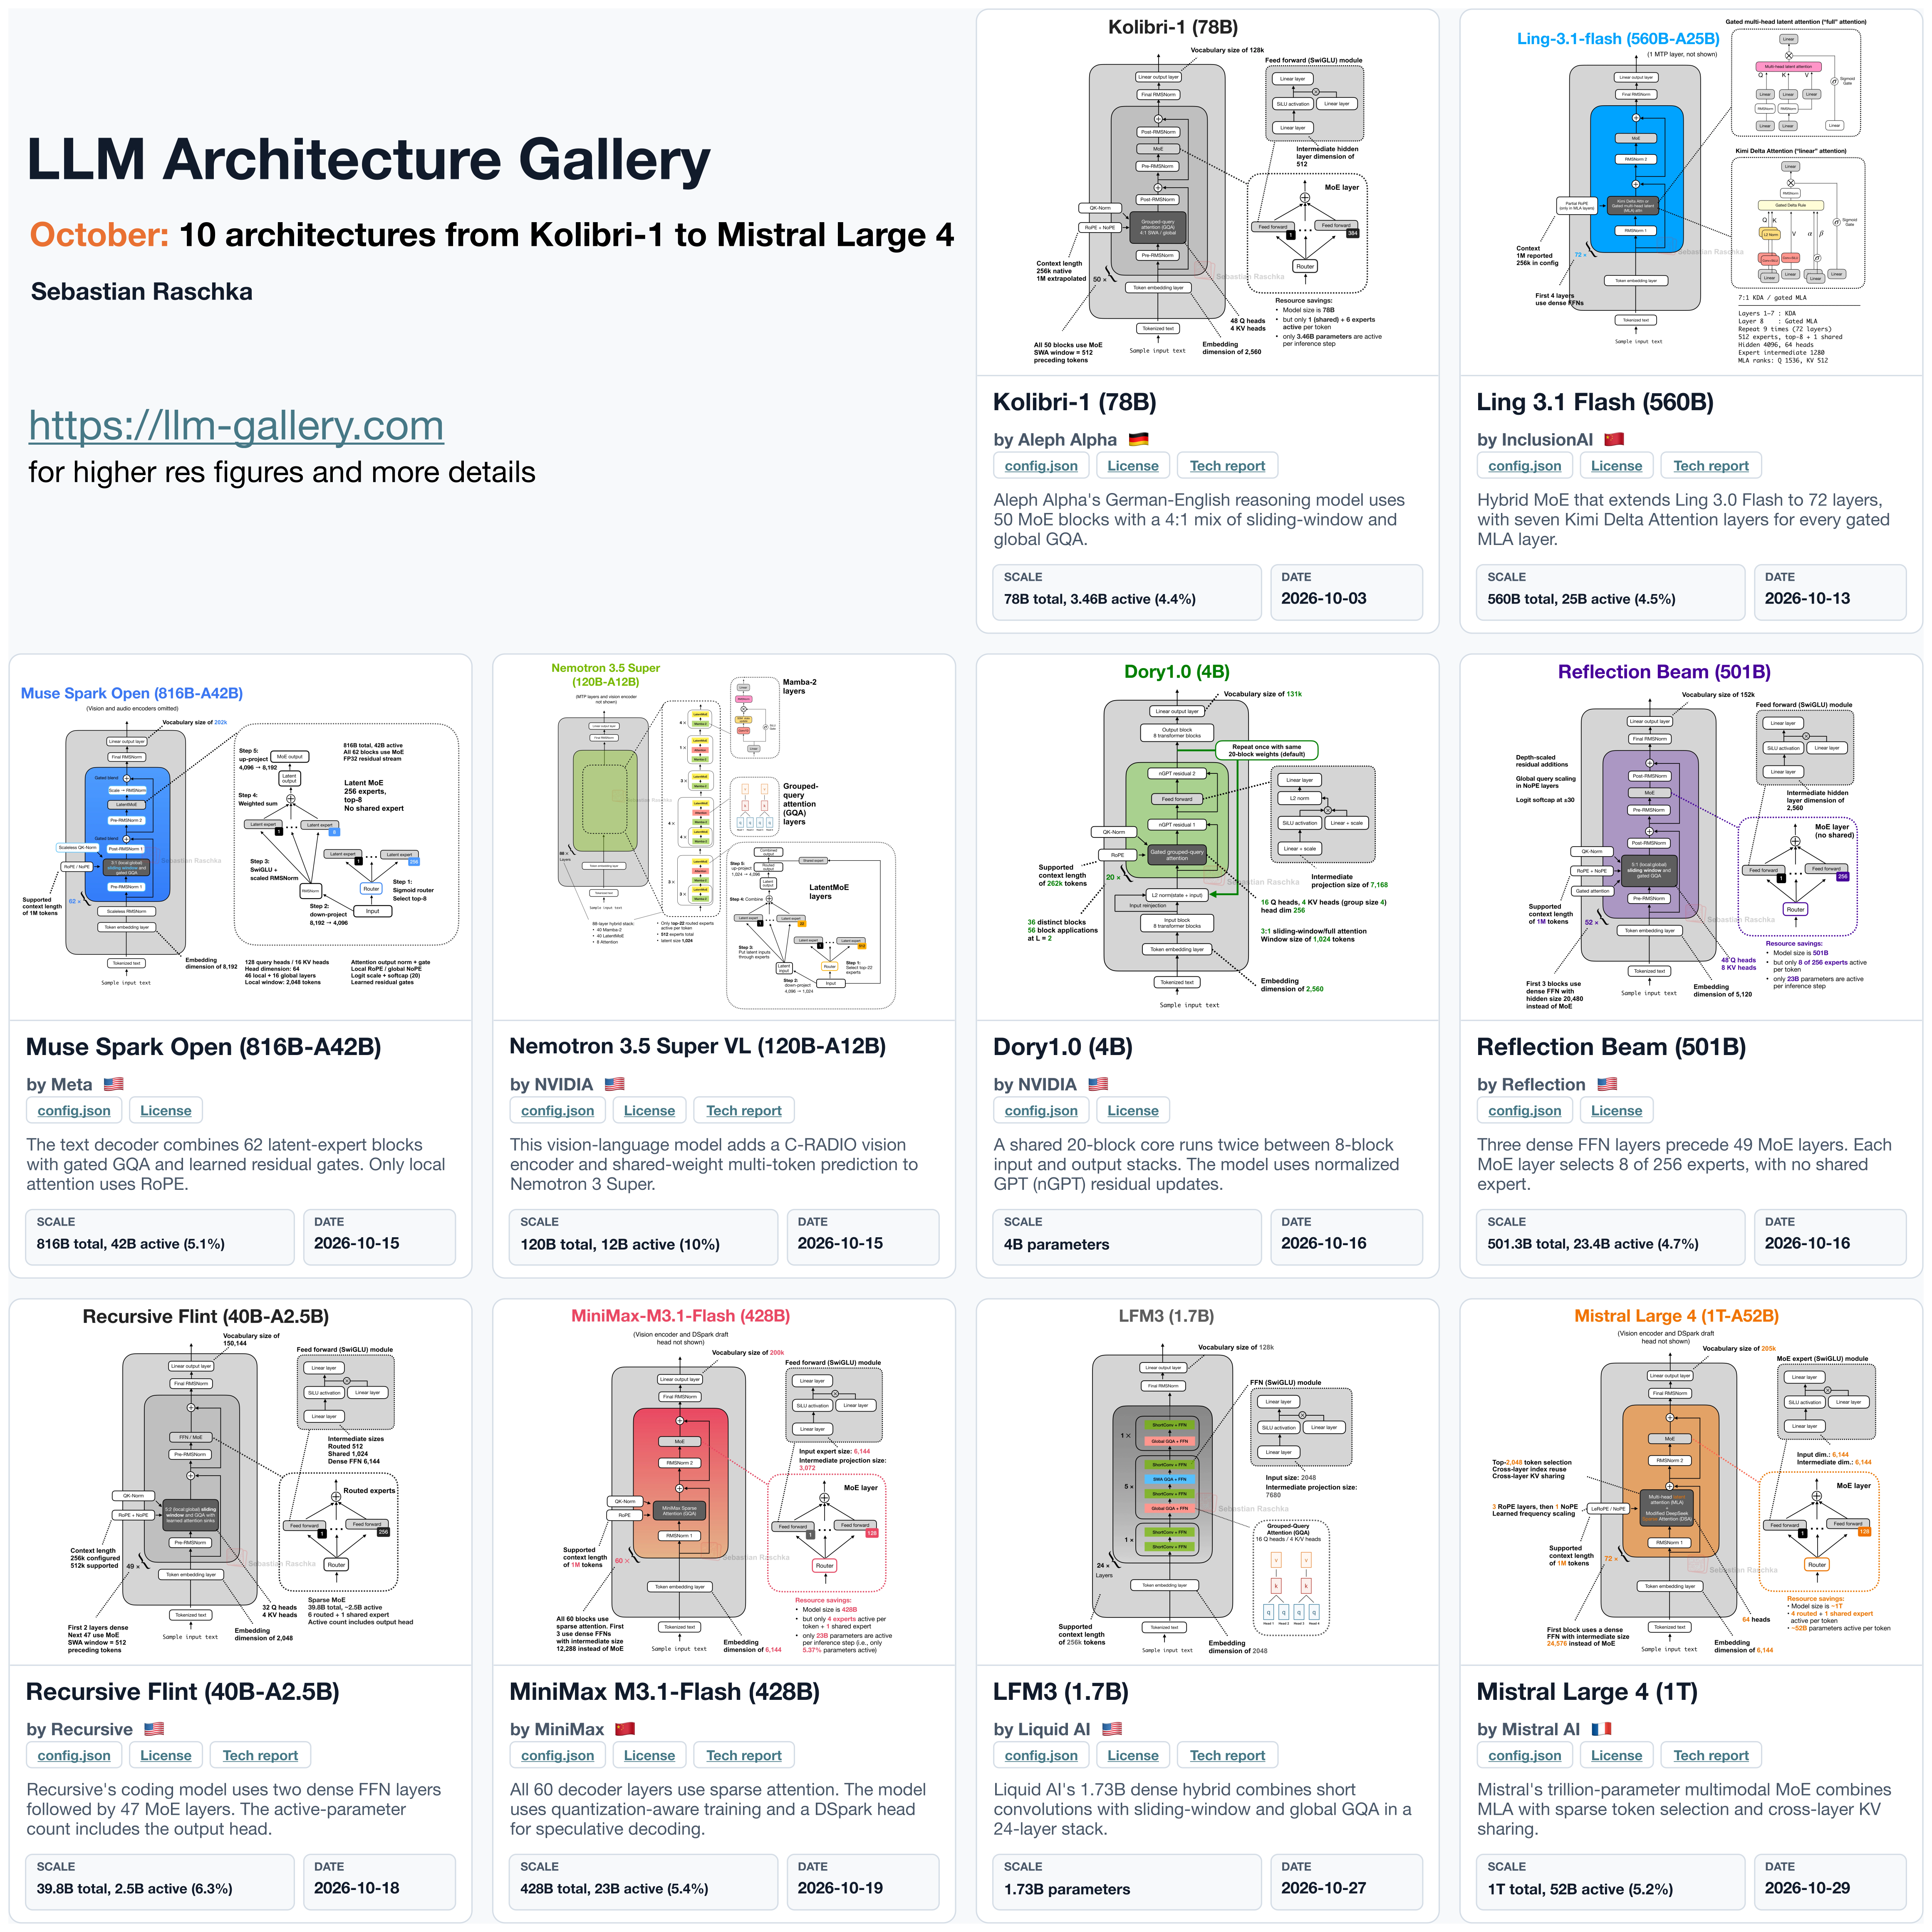
10モデルのアーキテクチャ図とファクトシート。クリックで高解像度版を表示。出典:LLM Architecture Gallery
最も目を引く2モデル
Mistral Large 4(1兆パラメータ)はこの10本の中で規模が最大だ。DeepSeekが開発したMulti-head Latent Attention(MLA)とスパースアテンションを組み合わせている。MLAはKVキャッシュを低ランク行列に圧縮してメモリ効率を上げる手法で、DeepSeek-V2以降に広まった技術だ。1Tという規模でこの組み合わせが採用されたことは、MLAが大規模モデルでも実用的であることを示している。
Nemotron 3.5 Super VL(120B)は異なるアプローチをとる。Mamba-2レイヤーとわずか8層のアテンション層を組み合わせたハイブリッド構成だ。さらにLatentMoE(潜在空間でのMixture of Experts)も採用している。Mamba-2は選択的状態空間モデル(SSM)の一種で、長いシーケンスを線形コストで処理できるのが特徴だ。アテンション層を絞り込みつつLatentMoEを加えるという設計は、推論コストの削減を強く意識した構成と見て取れる。
残り8モデルの概要
| モデル | パラメータ | アーキテクチャの特徴 |
|---|---|---|
| Kolibri-1 | 78B | GQA + SWA。ドイツ発 |
| Ling 3.1 Flash | 560B | Kimi Delta AttentionとDeepSeek由来のgated MLA |
| Muse Spark Open | 816B | GQA + SWA + LatentMoE(元記事がオープンウェイトの主要リリースとして紹介) |
| Dory 1.0 | 4B | ループ型トランスフォーマー設計 |
| Reflection Beam | 501B | GQA + SWA |
| Recursive Flint | 40B | 標準的なMoE + GQA + SWA("Recursive"は企業名) |
| MiniMax M3.1-Flash | 428B | 独自のMiniMax Sparse Attentionモジュール |
| LFM3 | 1.7B | 短い畳み込みとアテンションのハイブリッド |
アーキテクチャのトレンドを読む
10モデルを横断すると、いくつかの傾向が見える。
- GQA(Grouped Query Attention)+ SWA(Sliding Window Attention) の組み合わせが多数派だ。GQAはクエリをグループ化してKVヘッド数を削減しメモリ効率を高める手法、SWAはアテンションをトークンウィンドウ内に限定して長文処理のコストを抑える手法で、Kolibri-1・Muse Spark Open・Reflection Beam・Recursive Flintの4モデルがこの組み合わせを採用している。現時点でのベースライン的な選択肢になりつつあると言える。
- MLA系の広がり:DeepSeek由来のMLAがLing 3.1 FlashとMistral Large 4に採用されており、単一ラボの技術を超えてエコシステム全体への浸透が進んでいる。
- LatentMoE:Muse Spark OpenとNemotron 3.5 Super VLが採用。MoEの専門家選択を潜在空間で行う設計で、通常のトークン空間でのルーティングとは異なるアプローチだ。活性化パラメータを抑えながら表現力を維持することを狙った構成と考えられる。
- 非Transformerの混在:LFM3の短い畳み込み、Nemotron 3.5のMamba-2、Dory 1.0のループ型設計など、純粋なTransformerから外れた構成も複数ある。SSMやループ型設計がオープンウェイトモデルの選択肢として現実的になってきたことを示す動きだ。
全体を俯瞰すると、GQA+SWAという「標準構成」が定着する一方で、MLA・LatentMoE・SSMハイブリッドといった多様な試みが同時並行で進んでいる状況だ。1ヶ月で1兆パラメータ超のモデルが複数登場するペースは、2024〜2025年と比べても明らかに加速しており、オープンウェイト領域における競争の質・量ともに変化している。
Raschkaは今後のSubstack記事で各モデルのより詳細な解説を行う予定としている。
詳細はOpen October LLM Architecture Roundupを参照していただきたい。
