10月27日、StorageReviewが「NVIDIA Minerva Brings AIOps to AI Factories Through Dell, Lenovo, and Supermicro」と題した記事を公開した。この記事では、NVIDIAがGTC Berlinで発表したAIOpsプラットフォーム「Minerva」が、Dell・Lenovo・Supermicroを通じてAIファクトリー向けに展開される動きについて詳しく紹介されている。なお、Minervaは現時点で発表段階の製品であり、価格・一般提供開始日・OEM各社のパッケージング詳細はいずれも未公表となっている。
大規模GPUクラスターの「一部の不調が全体を引きずる」問題
大規模なGPUクラスターを運用するエンジニアなら身に覚えのある問題がある。数千基のGPUが高速ファブリックで接続され、事実上「1台のマシン」として動作する環境では、1つのコンポーネントが規格外の挙動を始めるだけでトレーニングジョブ全体が遅延する。
NVIDIAが挙げる具体例は「隣接GPUより高温で動作しているGPU」と「負荷下でパフォーマンスが劣化しているNVMeドライブ」だ。これらの異常データは現状、ネットワークツール・コンピュートツール・MLチームのダッシュボードにそれぞれ分散しており、同一クラスターを別々の視点でしか見られない。Minervaはこの分断を解消することを狙っている。
Minervaの仕組み:動的知識グラフ+機械学習
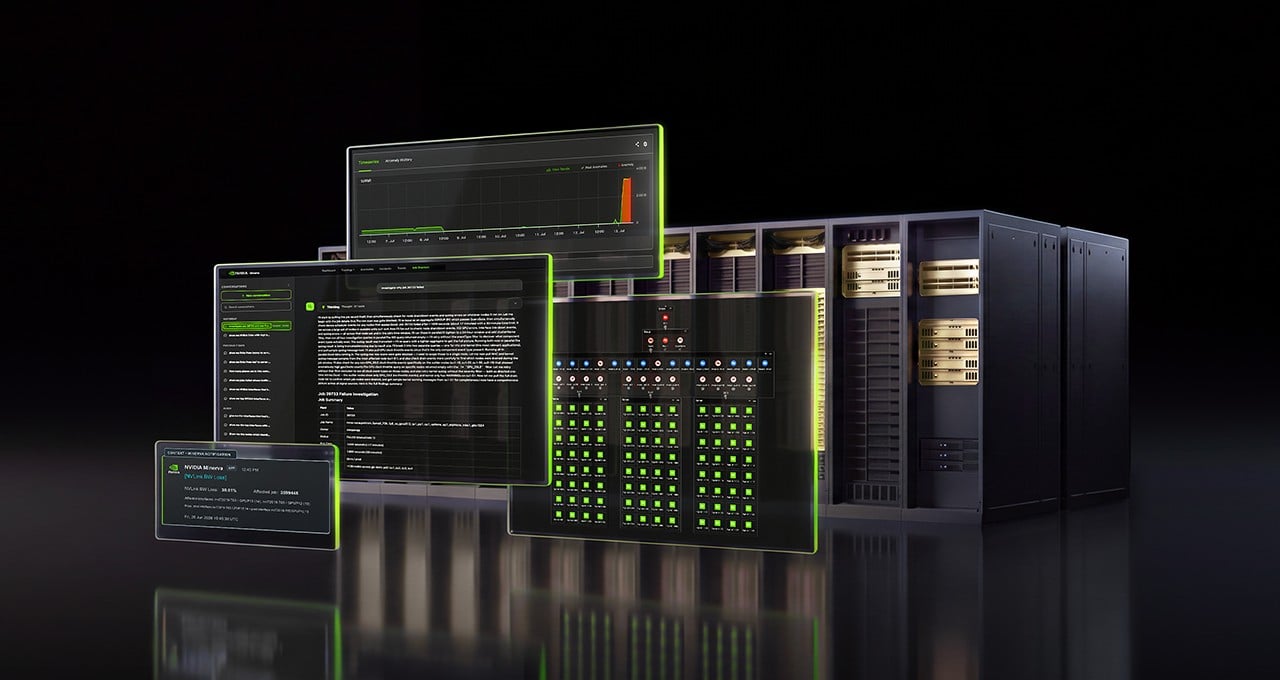
MinervaはGPU・SuperNIC・スイッチ・ケーブル・スケジューラー上のジョブをマッピングする動的知識グラフを構築する。これに対し、教師あり・教師なし両方の機械学習を適用し、1時間あたり数十億のデータポイントを分析する。
具体的には以下を行う。
- ファクトリー固有の「正常な挙動」を学習
- 未知の異常をフラグ立て
- 発展しつつある障害を予測
- トポロジー情報を使って関連イベントを相関付け
出力は「インシデント」単位にまとめられ、関連イベントを1件に集約した上で推定根本原因が付与される。アラートの洪水を1つのアクション可能な項目に置き換えるのがコンセプトだ。
自然言語でライブテレメトリに質問できるアシスタントも内蔵されており、修正案を提示する。修正の適用は「人間が判断して実行」か「インフラAPIや外部システム経由でMinervaが自動実行」かをオペレーターが選択できる。
NVIDIAが掲げる成果指標は有効GPU稼働時間(goodput)・クラスター稼働率・トークン生成量だが、平均修復時間(MTTR)や稼働率の具体的な数字はまだ公開されていない。
Metaの事例が示す「超大規模の現実」
この問題の規模感を把握するのに参考になるのが、Metaが公開したPrometheusクラスターに関するレポートだ(StorageReviewが「先週公開」と言及しているが、元記事に直接リンクはなく出典の特定は現時点では困難なため、詳細はMetaの公式リソースを合わせて参照いただきたい)。
MetaはDGX GB200 NVL72(1ドメインあたり72基のGPUを搭載するNVIDIAのラックスケールシステム)を採用しつつ、1ドメインあたり64GPUを実運用に充て、残り8基をラック内スペアとして確保するという構成をとっている。全ラックの約2%をリザーブし、修理済みシステムはバリデーション通過まで隔離する運用だ。NVIDIAのエンジニアと1年かけて根本原因分析を行った結果、割り込み発生を99%削減し、割り込みなしで継続稼働できる平均的な有効GPU稼働時間(goodput)を54,000時間超まで延伸することに成功した。目標は100,000時間だという。
これはハイパースケーラーが専用テレメトリパイプラインとNVIDIA合同トリアージチームを組んで実現した数字だ。StorageReviewはMinervaをこの取り組みをパッケージ化したものと位置づけている。エンタープライズやネオクラウドが同水準の可視性をOEM経由で調達できる選択肢、という見立てだ。
スタック上の位置づけ:Mission ControlやDSX OSとの関係は?
NVIDIAはすでにリファレンス設計向けの運用ソフトウェアを提供している。Mission Control(2025年3月発表)はBase Command ManagerによるプロビジョニングとRun:aiによるワークロード管理、テレメトリ、DGX SuperPOD向け自律ジョブリカバリを担う。同じタイミングでDSX OSの3コンポーネント(Config Manager・Rack Management Service・Cluster Readiness Engine)もデベロッパープレビューに入った。
ただし、MinervaとMission Control・DSX OSの関係性はまだ明示されていない。ソフトウェア提供なのか、アプライアンスなのか、ホステッドサービスなのかも未公表で、Dell・Lenovo・Supermicroそれぞれのパッケージング詳細も不明だ。製品ドキュメントページはNVIDIAのアカウントチームへの問い合わせを促すにとどまる。価格と一般提供開始日も未定。
現在の導入実績として挙げられているのはIRENのみで、同社CTOのDenis Skrinnikoff氏が「ネットワーク・GPU・ジョブを1つのビューで把握でき、チームの作業がプロアクティブなメンテナンスにシフトした」とコメントしている。IBM・Jio・Lambda・Quake AI・Tesla・Aolani・Bitdeer AIも導入予定としてリストされている。
ストレージ観点での注目点
StorageReviewが特に関心を示しているのがストレージテレメトリの深さだ。NVMeドライブのパフォーマンス劣化はチェックポイントやデータローディングのフェーズまでGPU使用率に表れにくい。それをGPU・ファブリックのテレメトリと並列で入力に取り込む設計は理にかなっているが、どのOEM・アレイプラットフォームがフィードを提供できるのかは今後の詳細待ちとなっている。
詳細はNVIDIA Minerva Brings AIOps to AI Factories Through Dell, Lenovo, and Supermicroを参照していただきたい。
