10月26日、Daniel Lemireが「Billion-query-per-second lookup tables in C++」と題した記事を公開した。コンパイル時に確定しているキーに対して完全ハッシュ関数(Perfect Hash Function)を用いることで、std::unordered_mapの13倍以上の速度でルックアップを実現するC++ライブラリについて、アルゴリズムの詳細から実測値まで詳しく紹介されている。
「キーが変わらないのに、なぜ実行時にコストを払うのか」
Webサーバー、URLパーサー、コンパイラ――こうしたソフトウェアは常に文字列をバリューにマッピングする処理を行っている。HTTPメソッド(GET、POSTなど)、ヘッダ名、プロトコル識別子、予約語。これらのキーはコードを書く時点で確定している。にもかかわらず、一般的なC++コードではstd::unordered_mapが使われ、実行時に「文字列全体のハッシュ計算→バケット探索→ポインタ追跡→比較→場合によってはチェーン探索」というコストを毎回払い続ける。
この問題への答えが完全ハッシュ関数だ。
完全ハッシュとは何か
ハッシュ関数は、複数のキーが同じスロットに入る「衝突」が起きると、その解決のために複雑な処理が必要になる。しかし、すべてのキーをあらかじめ知っているなら、衝突が一切起きないハッシュ関数を設計できる。それが完全ハッシュ関数だ。
1989年からGNUのgperfツールが同様のアプローチを採っているが、外部ツールの実行とコード生成ステップが必要だった。今回紹介するConstexprCore/perfect_hashは、C++23で強化されたconstexpr評価機能だけでコンパイル時にこれを完結させる単一ヘッダライブラリだ。C++20でもconstexprは使えたが、C++23ではconstexpr内での動的メモリ確保やアルゴリズム呼び出しの制約がさらに緩和され、コンパイル時にグリーディ探索を走らせるのが現実的になった。
スロットの計算式はシンプルだ。
slot = (length + asso[key[i]] + asso[key[j]] + ...) % table_size
キーの長さに、選ばれたいくつかの位置の文字から引いた連想テーブル(asso)の値を足すだけ。テーブルサイズは2の冪乗なので、モジュロ演算はビット単位のANDで済む。
具体例としてGET、PUT、POST、DELETEの4つを考える。最初の文字だけを使い、asso['G'] = 0、asso['P'] = 1、asso['D'] = 0と設定すると:
GET→ スロット 3+0=3PUT→ スロット 3+1=4POST→ スロット 4+1=5DELETE→ スロット 6+0=6
衝突ゼロ。PUTを検索する場合、スロット4を計算してそこに格納された1つのキーと比較するだけ——ハッシュ1回、比較1回で終わる。連想値の探索はグリーディアルゴリズムで行い、コンパイル時の制約内に収まるよう処理量を制限している。
C++23で書くとこうなる
#include <ConstexprCore/perfect_hash.h>
using namespace ConstexprCore;

enum class Method { GET, POST, PUT, DELETE, PATCH };

constexpr auto methods = make_perfect_map<
    kv<"GET",    Method::GET>,
    kv<"POST",   Method::POST>,
    kv<"PUT",    Method::PUT>,
    kv<"DELETE", Method::DELETE>,
    kv<"PATCH",  Method::PATCH>
>();
マップはコンパイル時定数として生成される。実行時のハッシュ計算は最小4命令——「キーの1バイトをロード」「連想テーブルの1バイトをロード」「長さを加算」「マスクを適用」——で完結する。外部ツールの実行もコード生成ステップも不要で、既存のビルドシステムにそのまま組み込める。
文字列比較の最適化:SIMDで一発
ハッシュ計算が安くなっても、スロットに格納されたキーとの文字列比較が遅ければ意味がない。素朴な実装ではバイトごとのループと分岐が発生し、数十命令・数回の分岐予測ミスが生じる。
このライブラリはARMとx64どちらでも使える16バイトベクタレジスタを活用する。たとえキーが3バイトしかなくても無条件に16バイトをロードし、ARM NEONのtbl命令でキーの末尾以降をゼロにする。格納側のキーはコンパイル時にゼロパディング済みなので、ベクタ比較1回でキー全体の照合が完了する。約40命令・8分岐が、5命令・分岐なしになる。
「3バイトのキーに16バイトを読んで大丈夫か?」という疑問は当然だ。メモリページ(最小4KB)をまたがなければ安全なので、アドレスがページ末尾から16バイト以内かどうかをチェックし、そうであれば低速パスを取る。予測困難な分岐を多数持つより、ほぼ常に同じ方向に分岐する1本に集約した方が実効的に速い。
実測値:Apple M3 Maxで毎秒何クエリか
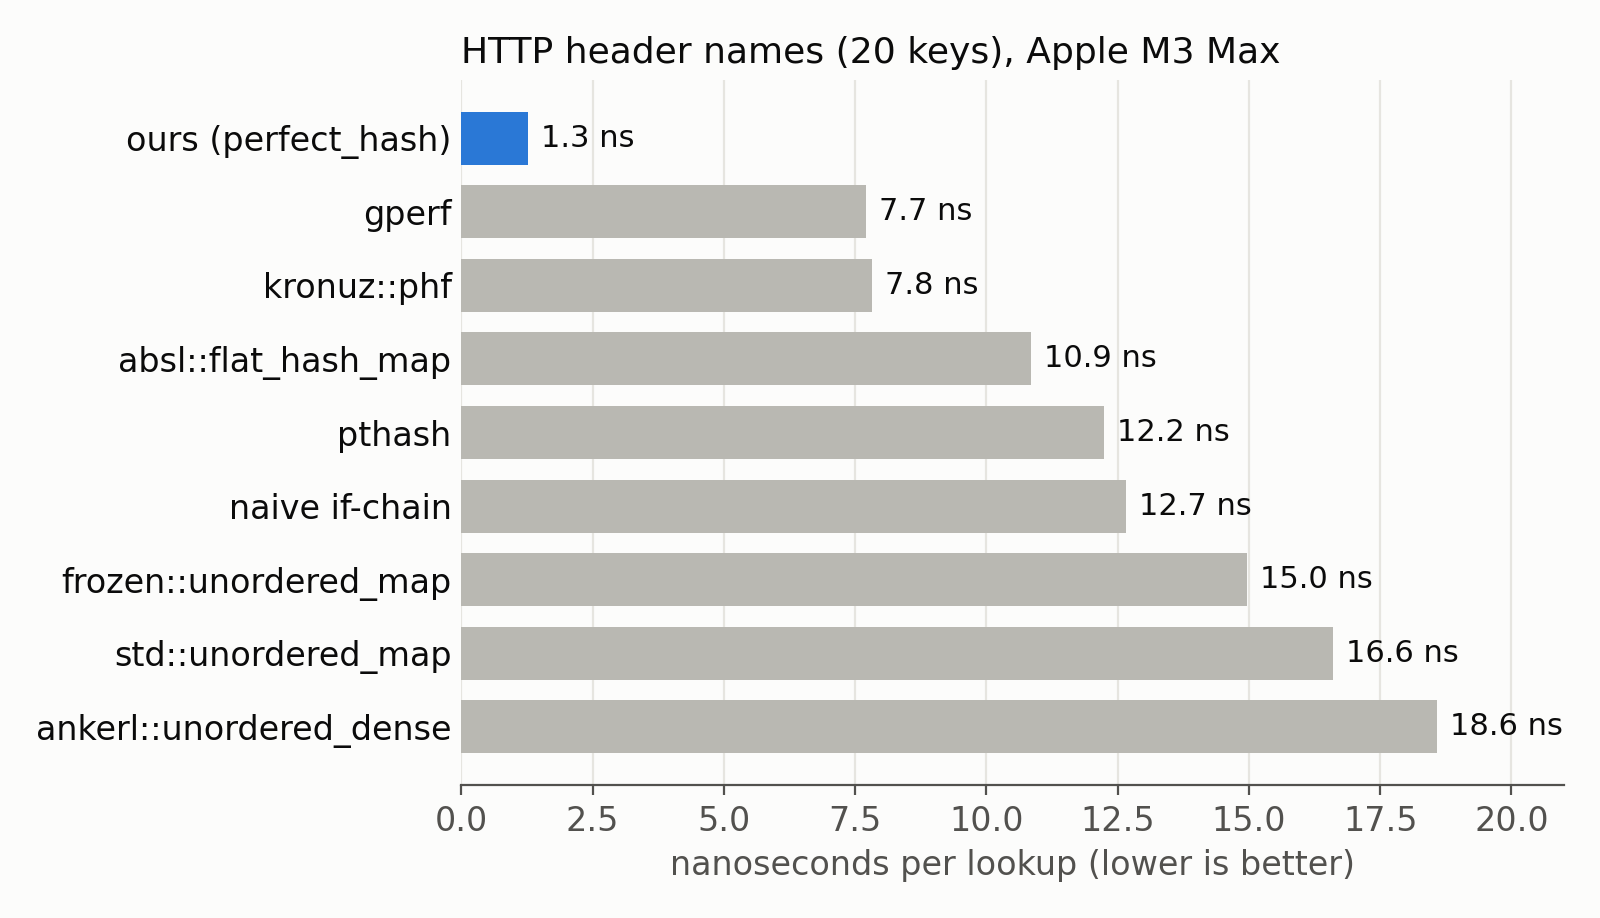
ベンチマークはApple M3 Max、AppleClang 15で実施。20個の標準HTTPヘッダ名でのルックアップ時間の比較:
| 実装 | レイテンシ |
|---|---|
| このライブラリ | 1.3 ns(約5サイクル) |
| gperf | 7.7 ns |
Abseil flat_hash_map |
10.9 ns |
std::unordered_map |
16.6 ns |
標準ライブラリの13倍速い。URLプロトコル6種からS&P 100の100銘柄ティッカーまで、7種類のキーセットでも1.2〜2 nsの範囲に収まる。JavaScriptの予約語ではgperf比で17倍の差がついた。
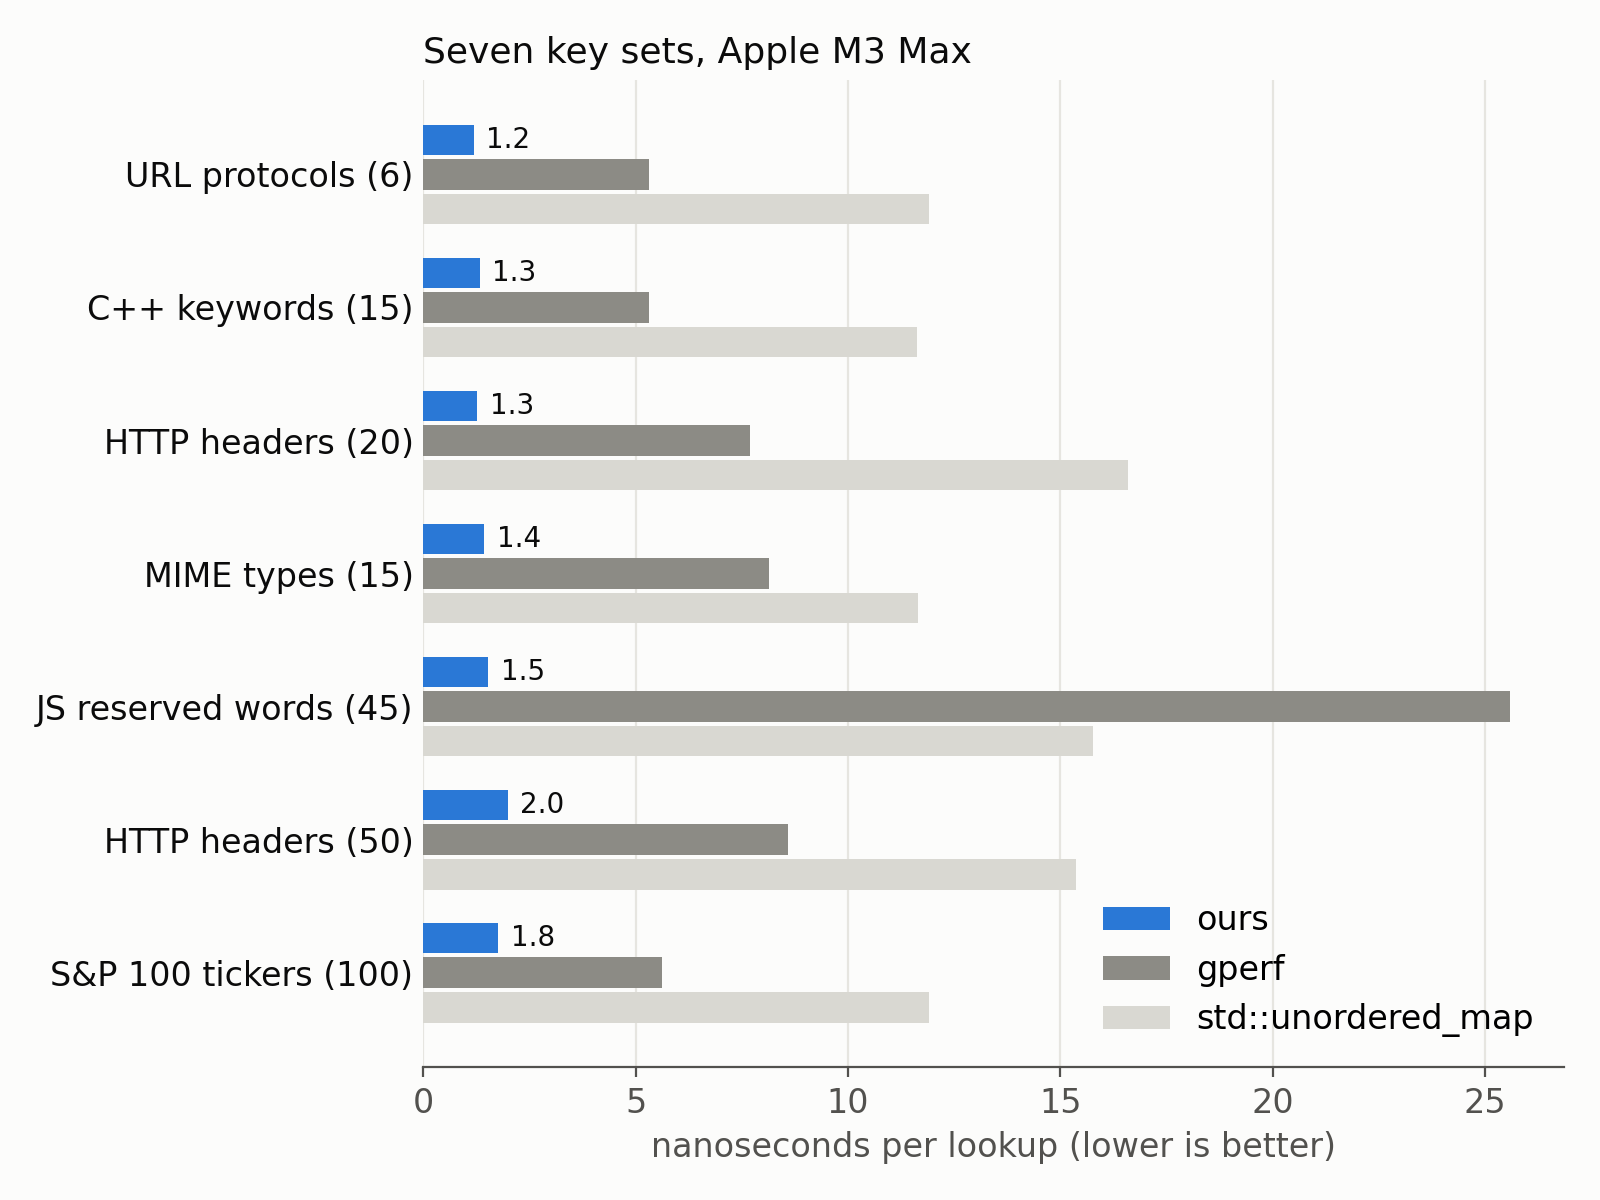
std::unordered_mapが遅い構造的な理由は明確だ。C++標準がチェーンハッシュテーブルを事実上要求しているため、ヒープ上のノードへのポインタ追跡が不可避になる。このライブラリのコードはApple M3 Maxで1サイクルあたり8.6命令以上を退役させており、チップの性能限界に近い動作をしている。Apple M4では、URLプロトコルの検索において毎秒10億クエリ超えを達成した。
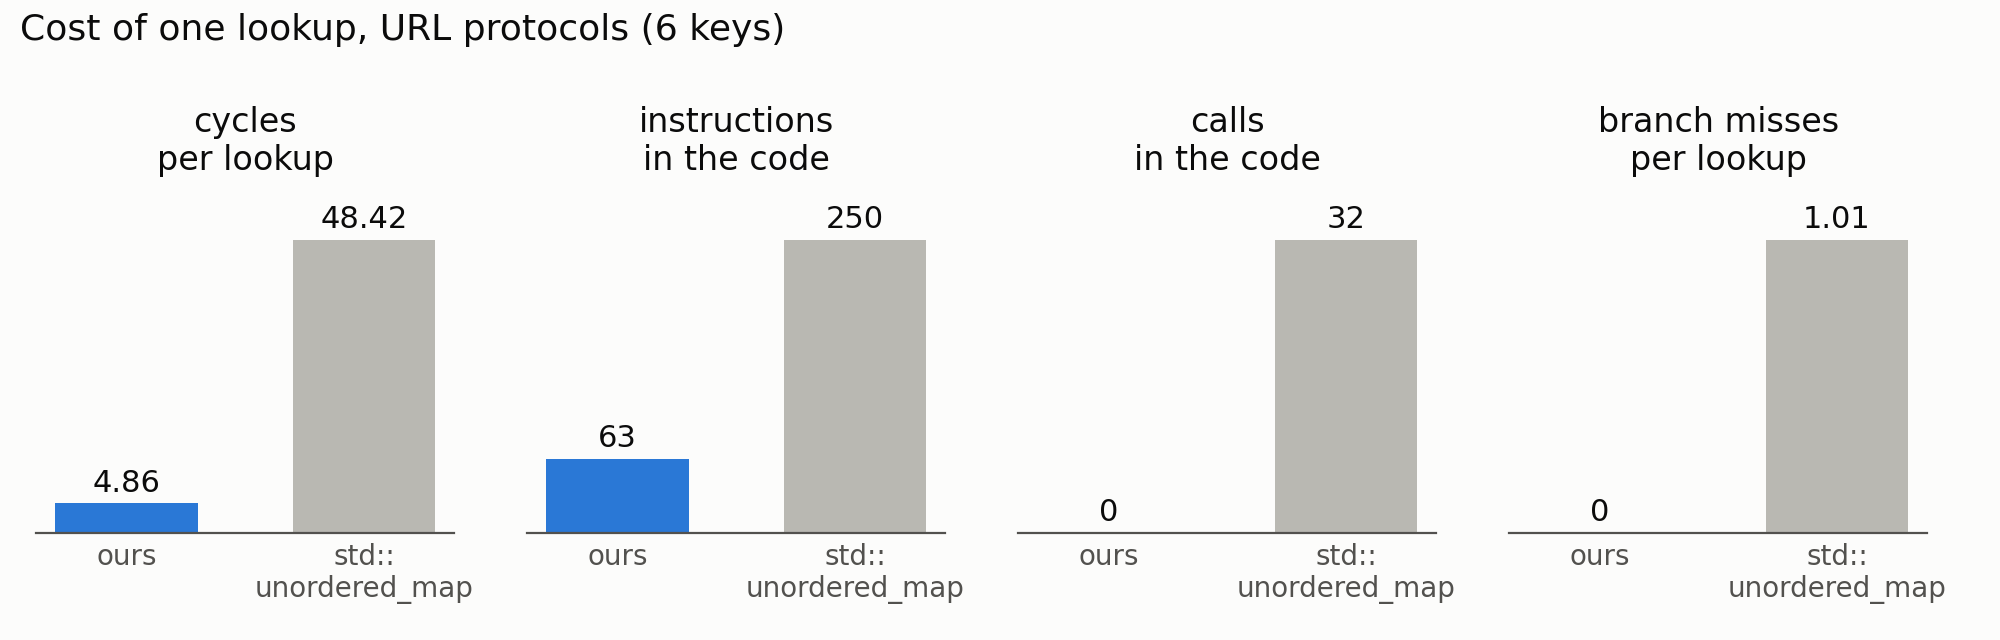
本成果はMicrosoftのFrancisco Geiman Thiesenとの共同研究で、P99 CONF 2026(高性能・低レイテンシシステムに特化した年次カンファレンス)で発表された。発表の動画はYouTubeで視聴可能で、ベンチマークコードと描画スクリプトもGitHubで公開されている。
詳細はBillion-query-per-second lookup tables in C++を参照していただきたい。
