10月20日、Neo4jが「Agentic GraphRAG: How does an AI agent use a knowledge graph?」と題した記事を公開した。AIエージェントが知識グラフを自律的にナビゲートして回答を生成する「Agentic GraphRAG」のアーキテクチャと実装パターンを詳しく解説した内容で、固定の検索パスでは対応しきれない複雑なクエリをどう捌くかという、RAG設計の核心に踏み込んでいる。
なぜ「Agentic」が必要なのか
RAG(検索拡張生成)の基本構成は、あらかじめ決めた固定の検索パスに依存する。質問がそのパスにフィットしない場合、精度は頭打ちになる。GraphRAGはこの問題を部分的に解決する。孤立したテキストチャンクではなくグラフ上の関係を辿ることで、類似度検索だけに頼らない回答が可能になる。
Agentic GraphRAGはその先にある。AIエージェントがグラフの探索起点・使う検索ツール・関係を辿る深さ・回答に十分なコンテキストが揃っているかの判断、さらにグラフへの書き込みまでを自律的にコントロールする。
ReActループによる動的検索:ここが一番の肝
Agentic GraphRAGのアーキテクチャで中心的な役割を担うのが、ReAct(Reason, Act, Observe)ループを使った多段階検索の仕組みだ。RAGに馴染みのある読者であれば「検索→生成」という1ショットの流れが頭にあるかもしれないが、ReActループはその概念を大きく拡張する。
エージェントはグラフスキーマを確認し、クエリを発行し、結果を観察し、「もっと情報が必要か」を判断して次のステップを決める。この繰り返しが、1クエリでは答えられない質問を解決する。
記事では具体例としてサポートチケットシステムが示されている。「同じエラーで影響を受けた他の顧客は誰か?」という質問への対処がわかりやすい。なお、以下のCypherクエリはいずれも元記事に掲載されている例示である。
Step 1: ベクトル検索でチケットを特定する
CALL db.index.vector.queryNodes('ticketEmbeddings', 1, $descriptionEmbedding)
YIELD node AS t, score
RETURN t.id AS ticketId
Step 2: そのチケットが報告しているエラーを取得する
MATCH (t:Ticket {id: $ticketId})-[:REPORTS]->(e:Error)
RETURN e
Step 3: 同じエラーを報告した他の顧客を取得する
MATCH (e:Error {id: $errorId})<-[:REPORTS]-(:Ticket)<-[:FILED]-(other:Customer)
RETURN other

3ステップそれぞれが直前のステップの結果を受けて実行される。各ステップはツール呼び出しとして記録されるため、エージェントがどうやって答えにたどり着いたかを後からトレースできる点も実用上の強みだ。
固定パスで答えられる単純なクエリ(「この顧客のプランは?」)ではReActループをそこで止める。複雑さに応じてステップ数が変わる設計が、固定検索との本質的な違いである。
グラフの構築・更新もエージェントが担う
Agentic GraphRAGのもう一つの側面が、エージェント自身がグラフを拡張する機能だ。GraphRAG Pythonパッケージを使い、自然言語からエンティティと関係を抽出してNeo4jに書き込む。
例として、既存グラフに「製品コンポーネントのサプライヤー」が未登録の場合、エージェントは以下のような処理を行う:
- ドキュメントや記録からエンティティ・関係の候補を抽出
- 既存スキーマと照合してどこに属するかを判断
- 重複エンティティの名寄せ(エンティティ解決)
- 信頼度の低い追加や矛盾する事実を検出してレビューに回す
- 承認されたノード・関係・プロパティをグラフへ書き戻す
記事では検索パスとグラフ更新パスを分離することを推奨している。読み取りツールはエージェントが参照権限を持つコンテキストだけを見る。グラフを変更するアクションは狭い権限・スキーマチェック・信頼度閾値・人間の承認の下で動かす、という設計だ。
コンテキストグラフ:過去の意思決定を再利用する
記事ではさらに、コンテキストグラフという概念が紹介されている。
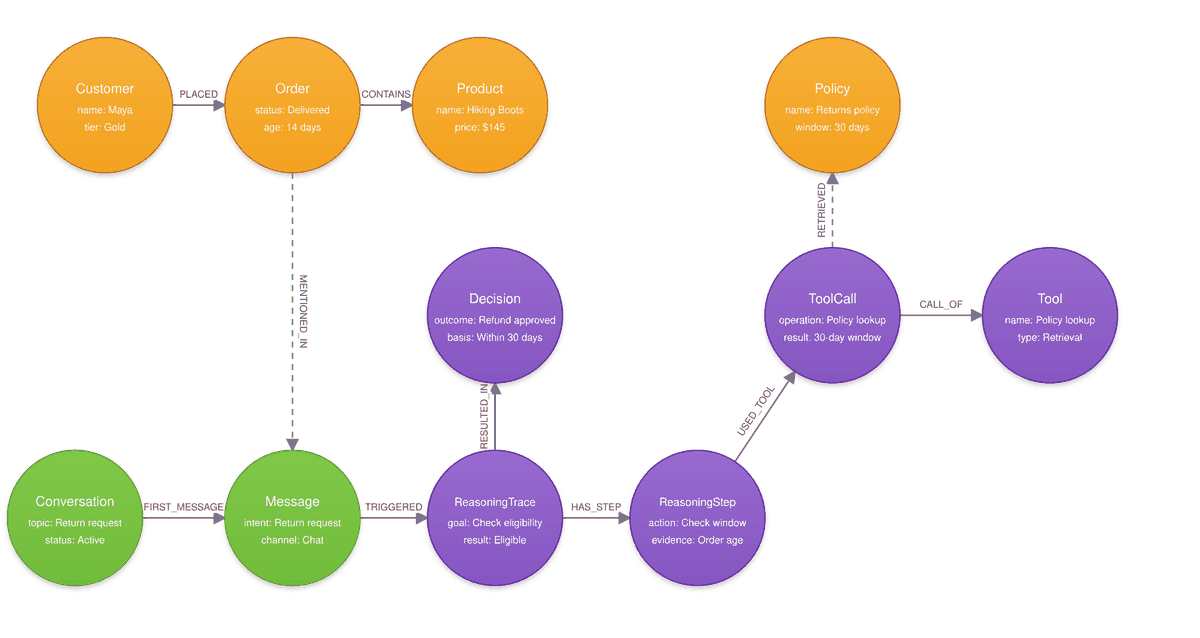
通常の知識グラフがドメインの事実と関係を格納するのに対し、コンテキストグラフはそこにエージェント自身の操作履歴——会話、ツール呼び出し、意思決定、その結果——を重ね合わせたグラフ構造だ。知識グラフが「世界の状態」を表すとすれば、コンテキストグラフは「エージェントがその世界とどう関わってきたか」の記録でもある。
| 知識グラフ | コンテキストグラフ | |
|---|---|---|
| 格納するもの | ドメインの事実と関係 | ドメインの事実+エージェントの操作履歴 |
| 例 | 顧客、チケット、エラー、製品 | 知識グラフの内容+会話、ツール呼び出し、意思決定、結果 |
| 使うとき | ドメインの事実と関係が必要なとき | 過去のやり取りや意思決定も必要なとき |
返金リクエストを例にすると、コンテキストグラフでは現在のリクエストを注文・返金ポリシー・過去の事例・最終的な判断結果と接続できる。次回の類似リクエスト到着時に、エージェントは過去の文脈を参照して判断できる。
どんな場合に導入を検討するか
記事は、Agentic GraphRAGの複雑さが正当化されるケースを3つに整理している。
- 質問によって検索パスが変わる場合 ── セマンティック検索だけで済むもの、グラフトラバーサルが必要なもの、その組み合わせが必要なものが混在する場合。固定パスが合う質問にはそちらを使い続け、合わない質問だけエージェントに委ねるハイブリッド設計が現実的だ。
- ドメインに新しい概念や関係が継続的に追加される場合 ── 顧客レコードの追加ではなく、新しい製品タイプ・規制ルール・サプライヤー関係のようにグラフ構造そのものが変わる変化が対象。
- 過去の意思決定を将来に活用する必要がある場合 ── 過去の返金例外や調査結果・承認判断を再利用したいならコンテキストグラフを追加する。
記事は「最適なバランスは事前に決まらない。アーキテクチャを試し、品質・精度・レイテンシのトレードオフを評価して調整する」と述べている。固定GraphRAGで足りる場合はそれで十分であり、複雑さは必要に応じて段階的に加えるという現実的なスタンスだ。
詳細はAgentic GraphRAG: How does an AI agent use a knowledge graph?を参照していただきたい。
