10月19日、Help Net Securityが「Half the AI bot traffic hammering your website comes from Meta」と題した記事を公開した。セキュリティ企業DataDomeの最新調査によると、ウェブサイトへのAIボットトラフィックの約半数をMetaが単独で占めており、しかも四半期ごとに41.5%増というペースで急増している。従来のbot対策の前提が崩れつつある現状を、同社の「AI Traffic Report Q3 2026」のデータをもとに詳しく見ていく。
DataDomeが公開した「AI Traffic Report Q3 2026」によると、同社ネットワーク上のAIエージェントトラフィックは2026年Q3に前四半期比41.5%増となり、リクエスト総数は約250億件に達した。2026年1〜9月における全AIエージェントトラフィックのうち、約半数がQ3に集中しており、前四半期の実績に基づいたキャパシティ計画やボット管理ポリシーは既に陳腐化しているという。
MetaのAIボットがトラフィックの半数近くを占める
最も衝撃的な数字は、Meta-ExternalAgentとMeta-WebIndexerの合計リクエスト数が124億件にのぼり、AIエージェントトラフィック全体の**49.7%**を占めているという点だ。Q3の月次推移を見ると、9月にはMeta-WebIndexerがMeta-ExternalAgentを逆転した。DataDomeはこれを、MetaがAI回答生成への投資を続けているサインと解釈している。
ランキング全体の上位をあわせて確認しておくと、1位のMeta-ExternalAgent、2位のMeta-WebIndexerに続き、3位はGPTBot(OpenAI)、そして4位にClaudeBotがランクインしてGPTBotを上回った形だ。
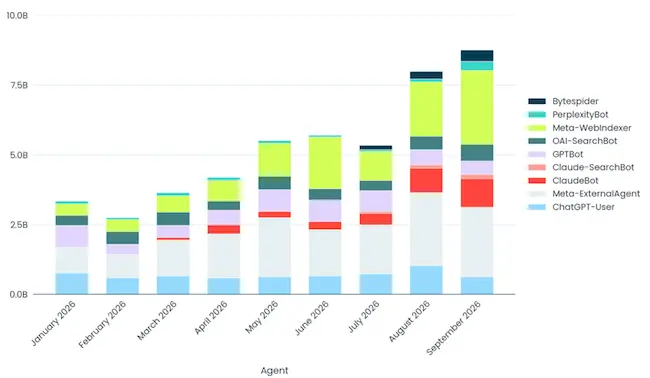
月次AIエージェントトラフィック上位(出典:DataDome)
OpenAI・Anthropic・Amazonはそれぞれ、学習データ収集・AI検索向けインデックス・ユーザーからの質問に応じたページ取得の3用途に対して、個別のボットを使い分けている。各ボットには固有の名前が付いており、ウェブサイト運営者は用途ごとにアクセス許可・拒否を設定できる。これにより、学習データへの利用は断りつつ、AI検索やアンサーサービスへのアクセスは許容するという運用が可能になる。
ただし、これらの制御は通常のブラウザを使ってbot名を名乗らずに閲覧するAIエージェントには効かない点に注意が必要だ。また、各ボットがrobots.txtをどう扱うかについて、企業が事前に明示していないケースもある。robots.txtとは、ウェブサイト運営者が自動アクセスのルールを記述するためのファイルであり、クローラーへのアクセス制御の基本手段として長く使われてきた。しかしその遵守はあくまで各ボット開発者の自主的な判断に委ねられており、強制力を持たないという根本的な限界がある。
MetaのMuse:初登場12日間で2,910万リクエスト
今回の報告で特に注目されているのが、MetaのパーソナルAIエージェント「Muse」だ。9月22日の正式公開から10月3日までのわずか12日間で2,910万リクエストを記録した。サンプルデータでは、そのリクエストの99.3%がクラウドおよびCDNのインフラ由来だった。
Museは専用のクラウド仮想マシン上のブラウザから動作するため、トラフィックはほぼすべてデータセンター発となる。これは「居住系IPを信頼する」という従来の防御設計とは相性が悪く、送信元IPだけでの判断が通用しない典型例だ。DataDomeはMuseを「エージェント型ブラウザ」カテゴリに分類しており、エージェント型ブラウザトラフィック全体は8月の1,250万リクエストから9月には5,820万リクエストへと約4.7倍に急増した。
さらに問題なのは、Museのトラフィックの8.9%がログイン・決済・アカウント作成・カート・フォームといった機密性の高いエンドポイントに到達している点だ。そのうちフォームページへのリクエストが81%を占め、ログインページの約8倍のリクエストを受けた。これはMuseがユーザーの指示に従ってフォーム操作を自動化しようとする設計に由来すると考えられるが、サービス提供者側からすれば、意図しない自動操作が機密フローに入り込むリスクを意味する。現時点でMuseがこれらのエンドポイントで何を行っているかの詳細は公表されておらず、動作の透明性確保が今後の課題となる。
DataDome VP of Threat ResearchのJerome Segura氏は次のように述べている。
「Museは、エージェント型トラフィックが向かう方向を示す最初の大衆向け事例だ。独自のクラウド仮想マシンから動作するため、リクエストのほぼすべてがデータセンタートラフィックに見え、一定割合がフォームやチェックアウトフローに到達する。居住系IPやISP系トラフィックを信頼するポリシーでは、このようなエージェントを捕捉できない。組織はエージェントのアイデンティティを検証し、意図を理解し、どのエージェントに何を許可するかを意図的に決定する必要がある。」
エンジニアが今すぐ考えるべきこと
※以下はDataDomeのレポートに基づく実務上の示唆を編集部がまとめたものである。
このレポートが示す実務上の含意は明確だ。
- ボット管理ポリシーを四半期ごとに見直す:41.5%という急成長を前提に、前四半期のデータに基づいた設定は既に機能しない可能性がある。
- 送信元IPだけでの判断は通用しない:Museのように99%がクラウドIPからくるエージェントを、居住系IP信頼ポリシーでは弾けない。
- 用途別ボットの個別制御を整備する:OpenAI・Anthropic・Amazonは用途ごとにbot名を分けているため、
robots.txtや許可設定を用途単位で設計できる。ただしrobots.txtの遵守は強制できないため、これだけに依存しない多層的な対策が求められる。
AIエージェントが人間に代わってウェブを閲覧する動きは加速しており、従来のbot対策の前提が崩れつつある。
詳細はHalf the AI bot traffic hammering your website comes from Metaを参照していただきたい。
