10月12日、Daniel Lemireが「Parsing JSON at tens of gigabytes per second… in Python」と題した記事を公開した。Python 3.14のフリースレッドモード(GILなし)とfastsimdjsonを組み合わせることで、単一Pythonプロセス内でJSONを65.7 GB/秒でパースできることを実測で示した内容だ。
「Pythonは遅い」という前提を覆す数字
65.7 GB/秒。これがPython 3.14のフリースレッドモードとfastsimdjsonの組み合わせで達成したJSONパース速度だ。標準ライブラリのjsonモジュールがシングルコアで0.18 GB/秒であることを考えると、その差は約365倍になる。
この結果を支える鍵は、Python 3.14で正式導入されたGILなしビルド(python3.14t)だ。GIL(グローバルインタープリタロック)はPythonインタープリタが同時に1スレッドしかPythonコードを実行できないよう制限する仕組みで、CPUバウンドな処理でのマルチスレッド並列化を長年妨げてきた。この制約はPEP 703で撤廃が提案され、Python 3.13で実験的オプションとして導入、Python 3.14で十分に実用的な段階に到達した。GILが取り除かれたことで、複数スレッドが真に並列でPythonコードを実行できるようになった。なお、既存の拡張ライブラリとの互換性は引き続き確認が必要な場面もあるため、本番導入の際には事前の検証を推奨する。
もう一方の主役であるfastsimdjsonは、Geoff Langdale・Daniel Lemire両氏が開発したsimdjson(SIMD命令を活用してJSONを高速にパースするC++ライブラリ)のPythonバインディングだ(パッケージ名はfastsimdjson、リポジトリ上の名称はfastpysimdjson)。なお、後述するlazy viewのアプローチはTyler Kennedyが別のsimdjsonバインディングpysimdjsonで最初に開発したものだ。
ベンチマークの設定
題材として、GH Archiveのデータを使用した。GitHub上のパブリックリポジトリで発生したイベント(プッシュ、Issue、Pull Requestなど)をNDJSON形式で記録したもので、2024年3月13日の8時間分、解凍後7.6 GB、220万イベントを対象にした。
タスクは「Pull Requestが最も多く開かれたプログラミング言語を集計する」というもの。各イベントは平均3.4 KBのJSONオブジェクトで、実際に必要なフィールドはごく一部だ。計測環境はIntel Xeon Gold 6548N×2(64コア)のサーバー、Python 3.14.6。
lazy viewが効く理由
fastsimdjsonのmap_many関数は、lazy=Trueオプションを指定すると辞書オブジェクトを生成せずにイベントの「遅延ビュー」を渡す。アクセスしたフィールドだけをPythonオブジェクトに変換し、残りは無視する仕組みだ。
import collections, threading
import fastsimdjson

local = threading.local()
parts = []  # 各スレッドが初回イベント時に自身のカウンターを追加する

def one_event(e):
    acc = getattr(local, "acc", None)
    if acc is None:  # このスレッドが最初のイベントを処理するとき
        acc = local.acc = (collections.Counter(), collections.Counter())
        parts.append(acc)
    t = e["type"]
    acc[0][t] += 1
    if t == "PullRequestEvent":
        p = e["payload"]
        if p["action"] == "opened":
            acc[1][p["pull_request"]["base"]["repo"]["language"]] += 1

data = open("events.json", "rb").read()
fastsimdjson.map_many(one_event, data, format="lines", threads=64, lazy=True)

types, languages = collections.Counter(), collections.Counter()
for t, lang in parts:
    types.update(t)
    languages.update(lang)
各スレッドはthreading.local()で独立したカウンターを持つため、スレッド間の競合が発生しない。map_manyが返った後、メインスレッドがスレッドごとのカウンターをまとめる。イベントタイプは数十種、言語は約100種なので、このマージはほぼコストゼロだ。
json、orjson、lazyなしfastsimdjsonがいずれも遅い共通の理由は、「使わないPythonオブジェクトを生成するコスト」が支配的になっている点だ。lazyモードはこのオブジェクト生成を最小化することで、速度の上限をパース処理そのものに近づける。
シングルコア vs 64コアの比較
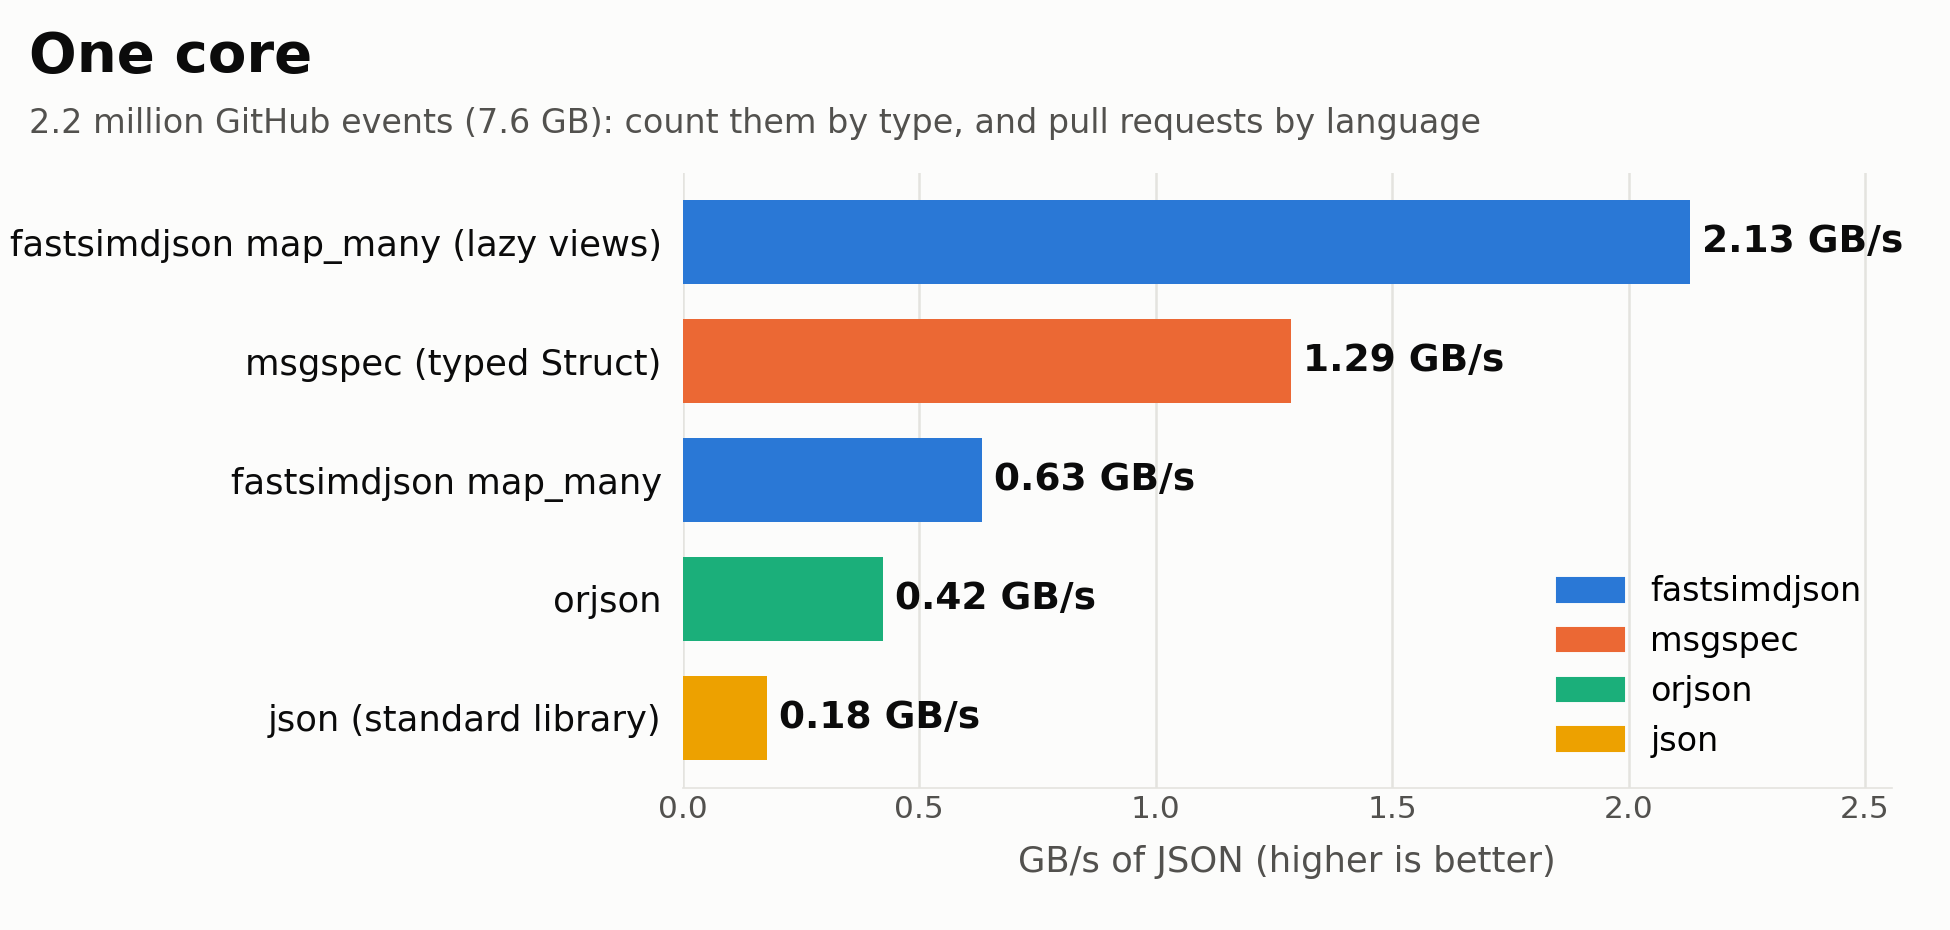
シングルコア:
| 手法 | GB/秒 |
|---|---|
| json(標準ライブラリ) | 0.18 |
| orjson | 0.42 |
| fastsimdjson map_many | 0.63 |
| msgspec(型付き構造体) | 1.29 |
| fastsimdjson map_many(lazy) | 2.13 |
標準ライブラリでは処理に42秒かかるのに対し、fastsimdjsonのlazyモードでは3.6秒で完了する。
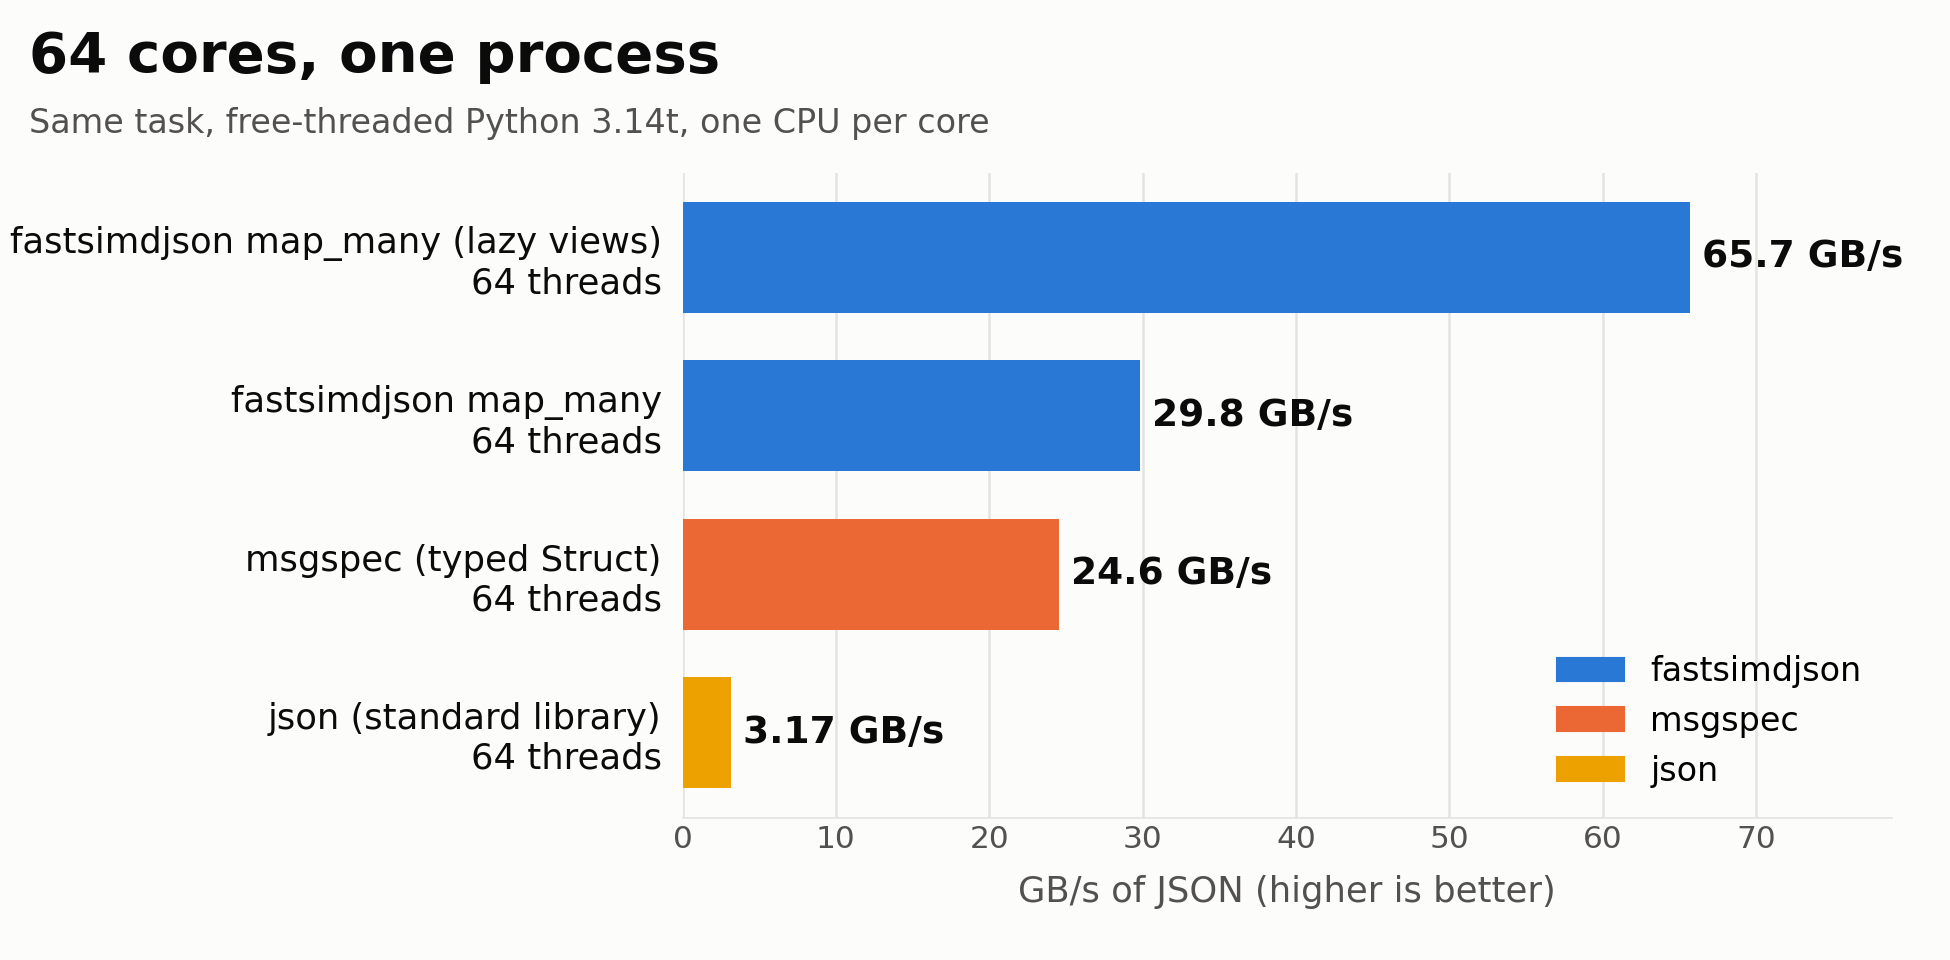
64コア(フリースレッドPython):
| 手法 | GB/秒 |
|---|---|
| json(標準ライブラリ)、64スレッド | 3.17 |
| msgspec、64スレッド | 24.6 |
| fastsimdjson map_many、64スレッド | 29.8 |
| fastsimdjson map_many(lazy)、64スレッド | 65.7 |
64コアでは7.6 GBのJSONを約0.12秒で処理する。シングルコアlazyと比べて31倍の高速化だ。msgspecの64スレッド(24.6 GB/秒)と比較しても、fastsimdjsonのlazyモードは明確に上回っている。
実用上の意味と限界
65.7 GB/秒という数字は、サーバーのメモリ帯域幅(最新世代で200〜400 GB/秒程度)から見ても現実的なレンジに入っており、「CPUがボトルネック」という状況をほぼ解消できることを示している。実際のパイプラインでは、ディスクIOやネットワーク転送が次のボトルネックになるケースがほとんどだろう。
fastsimdjson 0.6.0はPyPIで公開されており、ベンチマークのコードはLemireのGitHubリポジトリで確認できる。
詳細はParsing JSON at tens of gigabytes per second… in Pythonを参照していただきたい。
