10月9日、Callstackが「How to Measure AI's Business Impact Across the SDLC」と題した記事を公開した。AI開発投資のROIをSDLC全体で正しく測定するための方法論について、実際のゲームプラットフォームの事例を交えながら詳しく論じている。
「AIを導入したらPR数が増えた」「コードレビューが速くなった」。それだけで成果と言えるか、という問いがこの記事の核心だ。
「内側のループ」を測っても意味がない
ソフトウェア開発には2つのループがある。
インナー開発者ループ(Inner Developer Loop)は、編集・ビルド・テストのサイクルだ。AIの生産性計測の多くはここに集中している。生成された行数、PRのマージ速度、レビュー完了時間——数字は取りやすいが、ビジネスが何かを得たかは分からない。
アウタービジネスループ(Outer Business Loop)は、デプロイ後の観測を経て、そのデプロイが自社のビジネス指標に何をしたかが言えるまで続くループだ。Callstackはこちらを測れと主張する。
この主張を裏付ける実例が記事には登場する。
月間1億MAUのゲームプラットフォームで起きたこと
2021年、あるゲームプラットフォームでの話だ(AIは一切関係ない)。1GB RAM搭載のKindle Fire 7を使う約98万人のプレイヤーが、月に約50万回のクラッシュに見舞われていた。メモリ不足が原因だった。
別のPrincipal Engineerは「どうせこの層のプレイヤーは課金しない」と修正に反対した。記事の著者は規模の論理で押し切った——月間100万近いユーザーがいれば、修正コストは十分回収できると読んだのだ。
修正後の数字は明快だった。
| 技術的改善 | ユーザー体験の変化 | ビジネスインパクト |
|---|---|---|
| 月間クラッシュ数:約50万→10万未満 | マルチプレイヤーゲームへの参加成功率:0.01%→70% | 14日間リテンションがデバイス全体で統計的有意に改善、対象デバイス新規プレイヤーの収益化が1,000倍に |
修正前、このデバイスのプレイヤーがマルチプレイヤーロビーに参加できたのはわずか0.01%だった。修正後は70%が1セッション中にゲームに参加できた。その結果として14日間リテンションはデバイス全体で統計的有意な改善を示し、元記事の表現を借りれば対象デバイスの新規プレイヤーの収益化は「1,000倍(1000x)」になった——これはCallstackが記事中で明示している数字であり、Principal Engineerの年間総報酬分のコストを回収するのに十分な成果だったと著者は述べている。
そして著者は重要な点を強調する。「クラッシュが減った」という段階では上長に成果報告しなかった。14日間リテンションが統計的有意に上がるまで待った。アウタービジネスループが閉じるまで「成果」とは呼ばなかった、という姿勢がこの記事の論拠の根幹にある。
測定の落とし穴:信号がないことは中立の証明ではない
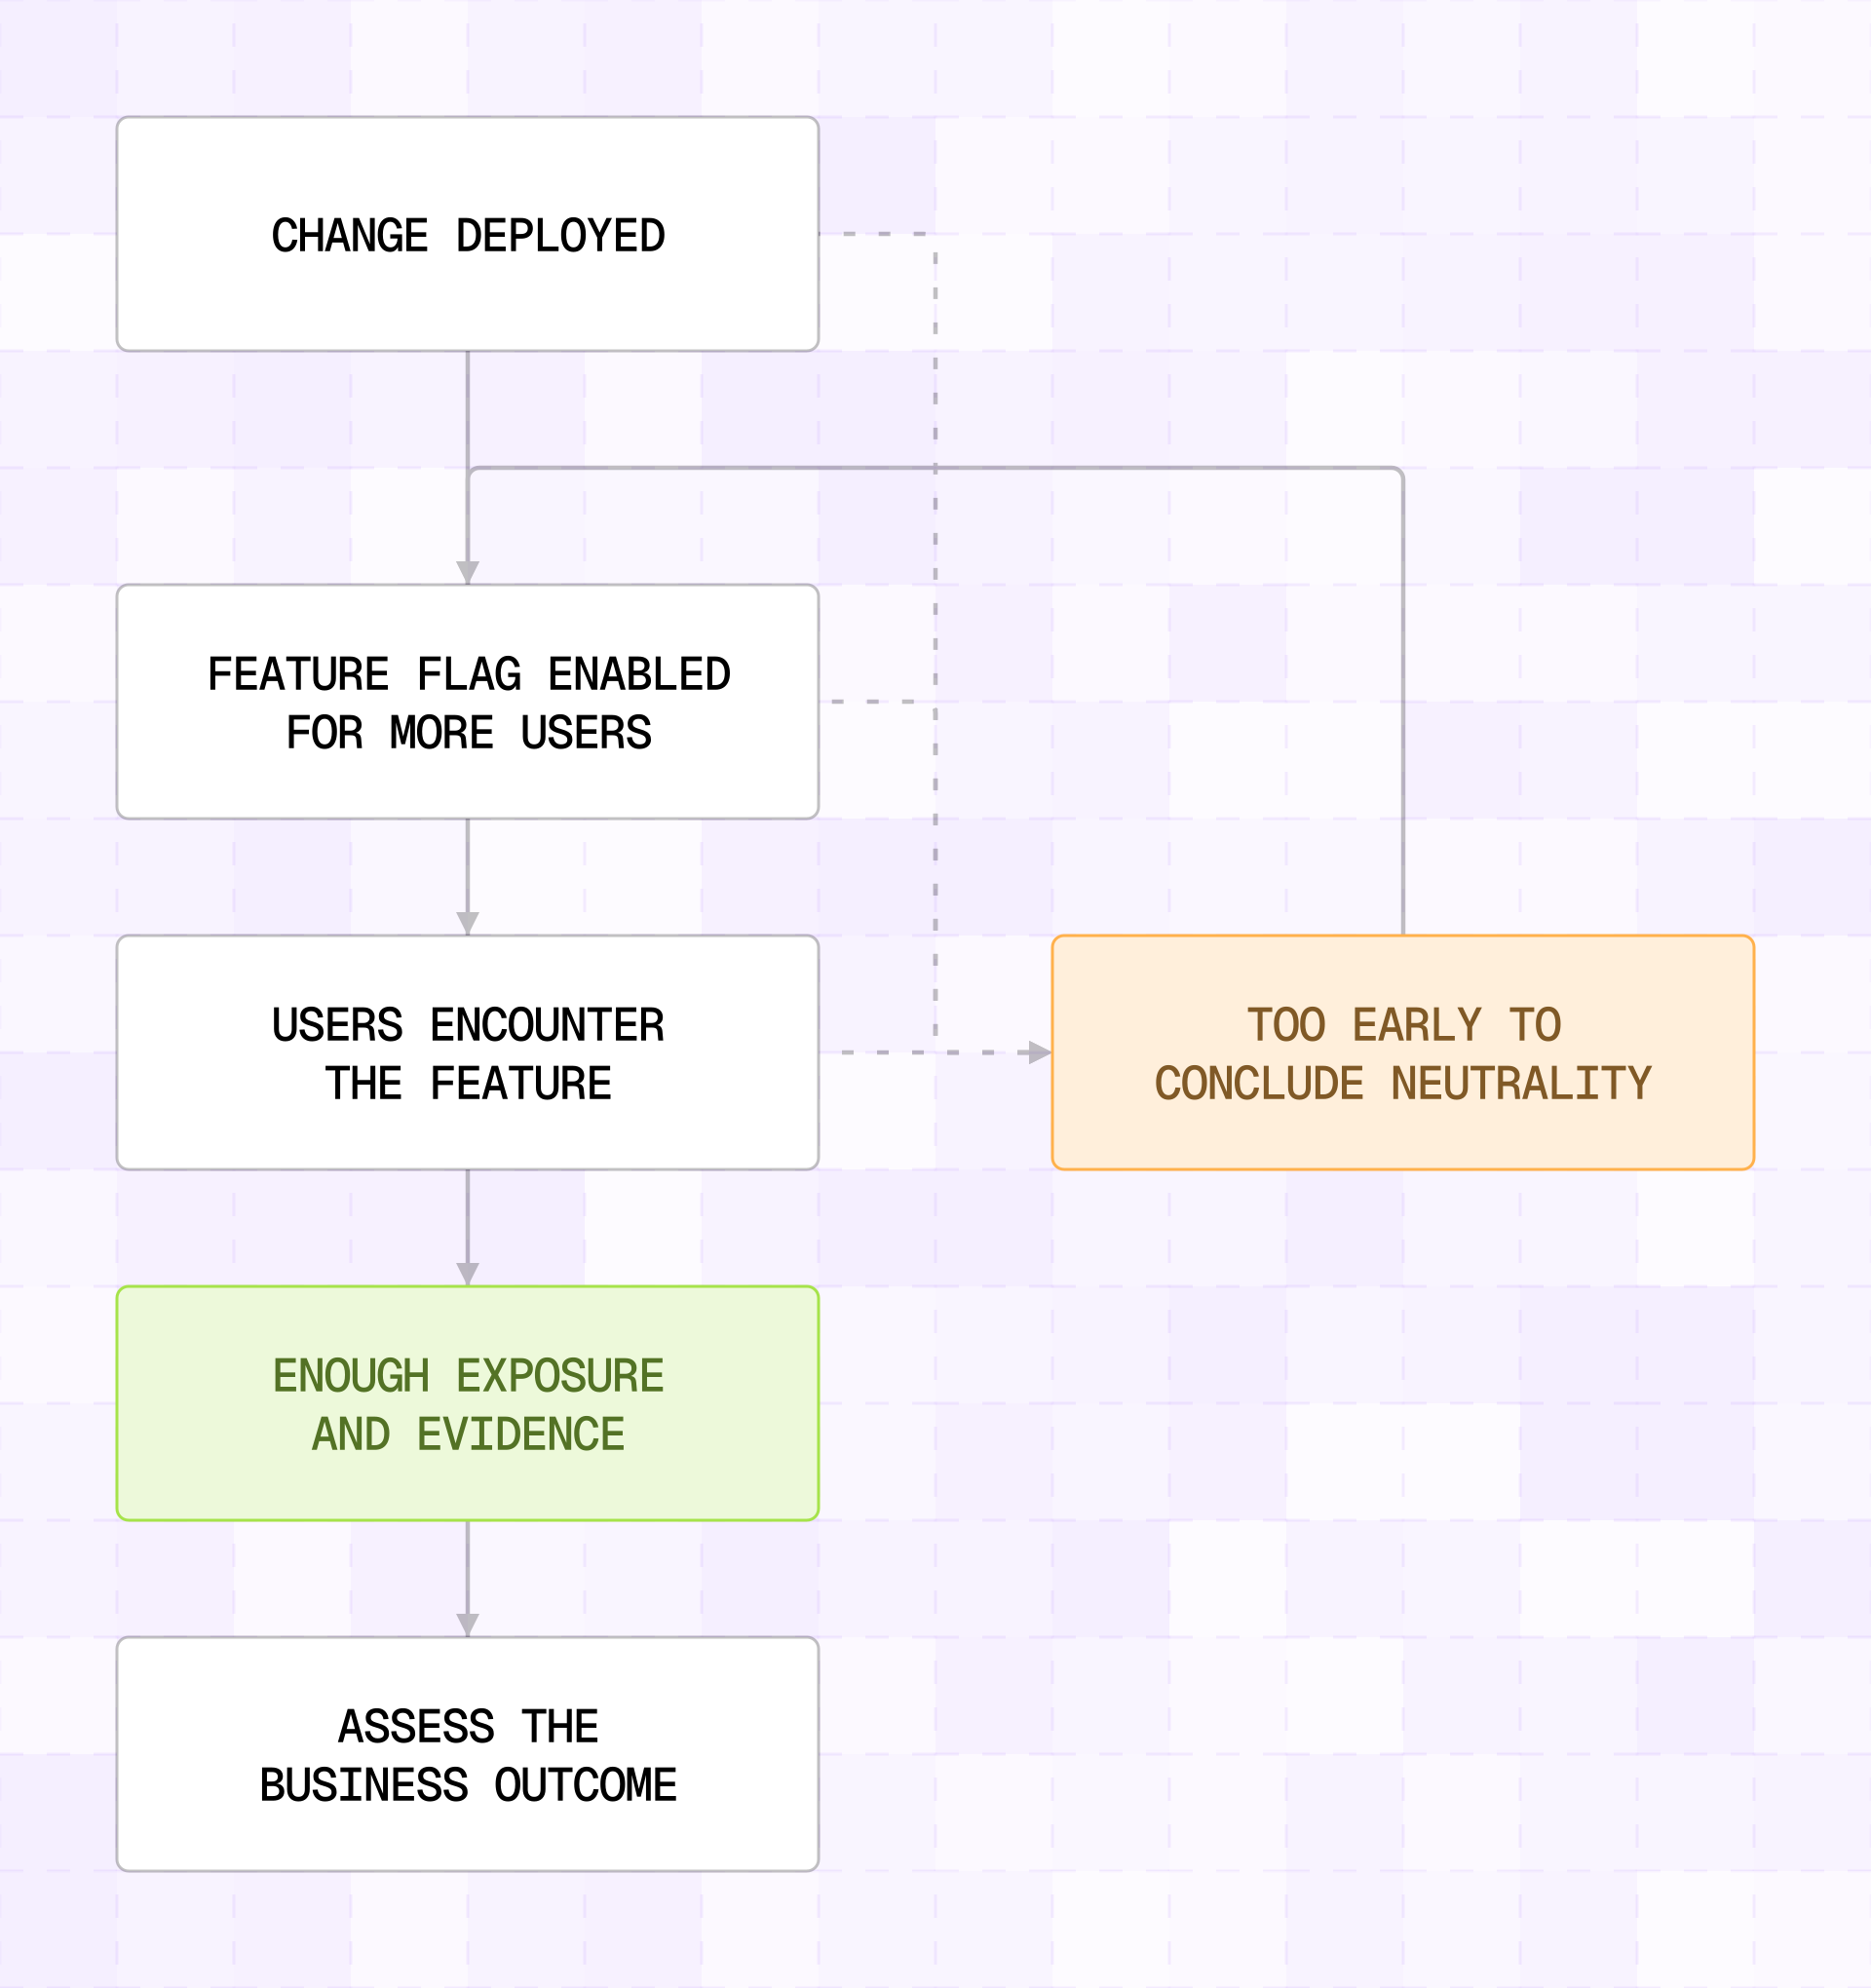
記事が特に強調するのは、「成果なし=中立」という誤解だ。
フィーチャーフラグやA/Bテストの背後に機能を隠している場合、ユーザーが実際にそのコードパスに到達していなければ、何の判断も下せない。「エンカウントした」とは、ユーザーがアプリ内でそのフラグやテストが動くページまで実際に辿り着いたことを意味する。それが確認できるまで、変更が中立かどうかは不明だ。
「クラッシュが増えなかった」も同様だ。それだけでは、コードベースにゴミを積み上げただけかもしれない。記事ではあるAIモデルプロバイダーの事例として、専門家によるリファクタリングなしに数ヶ月間AIに変更を加え続けた結果、古典的アンチパターン「Blob Class」が発生し、50万トークンのコンテキストウィンドウでも対処困難なほど肥大化したケースが紹介されている。
Blob Classとは、責務が無秩序に集中した神クラス的な構造を指すアンチパターンで、1998年に出版されたAntiPatterns: Refactoring Software, Architectures, and Projects in Crisis(William J. Brown ほか著、Wiley刊)で体系化・命名された概念だ。AIが短期的にコンパイルを通すコードを生成し続けても、設計品質の劣化は数値に現れにくい——この事例はその危険性を端的に示している。
AIコスト換算:トークンあたりの「防御可能な貢献」
AIを使う場合はさらに一段階加わる。消費トークン数、トークン単価、所要時間、誤ったコマンドや失敗ビルドの回数——これらを北極星指標(North Star Metric)の改善幅と突き合わせる。
記事が使う言葉が「defensible contribution(防御可能な貢献)」だ。統計的有意な北極星指標の改善であり、変更を実際に経験したユーザー集団から得られたものであり、他の要因では説明がつかない改善——それだけが「防御可能」だ。
AIデプロイのチェックリスト
記事はこれらをまとめた実践的なチェックリストを提示している。単なる確認項目の羅列ではなく、各問いが「アウタービジネスループを閉じるために何が揃っているか」を構造的に問うものになっている点が重要だ。
- 仮説:この変更はどの北極星指標を、なぜ改善するか? ——測定の出発点であり、これが曖昧なままでは後続の評価がすべて無効になる。
- エクスポージャー:フラグや実験が、十分に多様かつ大規模なユーザー集団に実際に届いたか? ——「信号なし=中立」という誤解を防ぐための前提確認だ。
- 結果:北極星指標が統計的有意に改善したか?混在する場合、原因を追えるか?
- フロア:何か悪化したものはないか?最悪でも正味中立か? ——改善の裏で別の指標が犠牲になっていないかを見る。
- クラフト:中立でフェーズドパッチスタックの一部でもない場合、後で何を削除する必要があるか? ——技術的負債の予防的把握だ。
- コード:北極星指標の改善1ポイントあたり、何行の慣用的・十分テスト済みのコードで済んだか?
- コスト:何トークン、単価いくら、何時間、誤コマンド・失敗ビルド・リトライは何回か?
- 収支:防御可能な貢献1件あたり、トークンで何ドル使ったか?
このチェックリストを100回繰り返したとき、ユーザー・運用・プロダクトリーダー・開発者の全員が以前より良い状態にあるか——それが問いの最終形だ。開発速度の指標は「内側」でいくらでも積み上げられる。だが上長やステークホルダーに対して「防御可能」な成果として提示できるのは、このチェックリストを通過したものだけだ、というのがCallstackの主張だ。
詳細はHow to Measure AI's Business Impact Across the SDLCを参照していただきたい。
