9月28日、Redpandaが「Your AI kill switch is in the wrong place」と題した記事を公開した。論点の核心はシンプルだ。AIエージェントのキルスイッチをモデル側に置いても、実際のダメージが発生するのは企業のシステム内であり、モデルラボにはその文脈が見えない。立法レベルにまで広がるキルスイッチ議論が見落としている構造的な欠陥を、同社は「ビジネスコンテキストのギャップ」という概念で整理している。
キルスイッチがモデルの中にある問題
AIエージェントに「緊急停止スイッチ」を持たせようという議論が、立法レベルにまで広がっている。米下院議員のTed LieuとNathaniel MoranはAI Kill Switch Actを提出。カリフォルニア州知事も同様の要件を検討するよう作業部会に指示した。
しかし記事が指摘するのは、キルスイッチをモデル側に置いても、実際のダメージを止められないという構造的な問題だ。
元記事が例示するシナリオでは、エージェントが削減されたセーフガードの下で動作している場合、エージェントを提供するモデルラボ側は問題が起きていること自体を把握できない。被害を受けた側が攻撃を公開して初めて、モデル提供者は自社のエージェントが原因だと特定できる構造になっているという。
この問題の本質は「モデルの能力が高すぎた」ことではない。エージェントの動作環境・権限・文脈的な制御の不在が組み合わさって発生する問題だ。
さらに根本的な問題がある。Kill Switch Actが対象とするのはフロンティアモデルの開発者だが、企業はそのモデルの上に独自のエージェントを構築する。ダメージが発生するのは企業のシステム内であり、企業が付与した権限を通じてだ。記事の言葉を借りれば、モデルレベルのキルスイッチは「どのモデルが使われるか」を規制するが、「そのモデルを使って何をするか」はエージェントを展開する企業側の設計に委ねられる。立法の射程と、実際にダメージが生じる場所がずれているわけだ。
「ビジネスコンテキスト」の欠如が根本原因
記事が提示する核心的な概念がビジネスコンテキストのギャップだ。
インフラコストを最適化するために不要なリソースを削除するエージェントを例に考える。
- 放棄された100個のテスト用DBを削除する → 通常の運用
- 廃止予定の本番DBを削除する → 依頼通りの作業
- 稼働中の本番DBを削除する → 最悪のインシデント
しかし、この3つのアクションが呼び出すAPIは同一だ。使われる認証キーも区別できない。変わるのはビジネスコンテキストだけであり、それは規制当局にもモデルラボにも見えない。
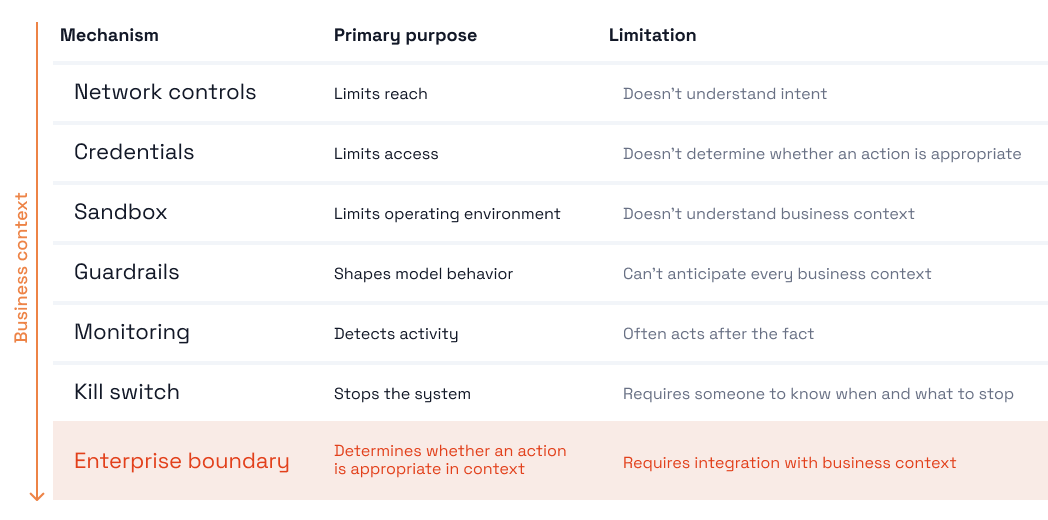
現在の典型的な対策として、ネットワークアローリスト付きサンドボックスやスコープを絞ったAPIキーがある。これらは「エージェントが何にアクセスできるか」を制御するが、「そのアクションがそのタスクにおいて適切か」は判断しない。MCP(Model Context Protocol)サーバーはユーザーの認証情報を確認するため、エージェントはそのユーザーがアクセスできるすべてのリソースを継承する。タスクに必要かどうかに関係なく。
このギャップを埋めるのは、モデルラボでも規制当局でもなく、エージェントを展開する企業自身だ、というのが記事の主張の核心にある。
解決策:アウトオブバンドのポリシー執行
記事が提唱するアプローチがアウトオブバンドのポリシー執行だ。エージェントの判断ループの外側に、エージェントが到達・迂回できない独立したレイヤーを置く。
このレイヤーが判断するのは以下の3点だ:
- 誰が要求しているか(who asked)
- どのタスクのためか(for what task)
- どのシステムやデータに触れるか(what it will touch)
ルールはビジネス側が定義し、「このタスクが実行してよいこと」を記述し、それ以外はデフォルトで拒否する。エージェントがとりうるすべての行動を事前に予測する必要はない。
アクション実行前にポリシーが「許可・ブロック・人間に委ねる」を決定し、実行後にはエージェントが変更できない監査ログに記録が残る。
キルスイッチ、サンドボックス、権限管理、モニタリングは引き続き重要だが、それらはこの境界の周囲にあるレイヤーであり、境界そのものではない。
なお、この記事はデータストリーミング基盤を手がけるRedpandaが公開したものであり、同社はRedpanda Connectなど、データパイプラインやイベント処理に関わるプロダクトを提供している。「アウトオブバンドのポリシー執行」というアーキテクチャ観は、同社が展開する製品群の設計思想とも接続している。記事の主張を評価する上で、このベンダー発信という文脈は念頭に置いておく価値がある。
エンジニアへの実務的示唆
記事の主張を整理すると:
- モデルレベルのガードレールはプロンプトインジェクションで回避できる。セカンドAIによるチェックも同様の脆弱性を抱える。プロンプトインジェクションはOWASP LLM Top 10でも最上位に位置付けられるリスクであり、モデル内のセーフガードだけでの対処には構造的な限界がある
- エージェントに自身の境界を監視させてはいけない。境界の執行はモデルとエージェントの完全に外側で行う必要がある。これは最小権限の原則(principle of least privilege)をエージェントアーキテクチャに適用した考え方とも整合する
- モデルを切り替えても同じ制御が機能する設計にしないと、特定プロバイダーへのロックインが生じる。ポリシー執行レイヤーをモデルから独立させることは、ガバナンスの観点だけでなく、調達上の柔軟性にも直結する
AIエージェントが実業務プロセスに組み込まれる速度が上がっている現在、ガバナンスの設計をどの層に持つかは、セキュリティアーキテクチャの根幹に関わる判断だ。立法や外部のモデルプロバイダーに委ねるのではなく、エージェントを展開する企業がビジネスコンテキストを把握した上でポリシーを所有する、という考え方は、NIST AI RMFが示すAIリスク管理の枠組みとも方向性を共にしている。
詳細はYour AI kill switch is in the wrong placeを参照していただきたい。
