9月17日、Mozilla.aiが「Benchmarking llama.cpp vs llamafile vs LM Studio vs Ollama: What Moved Throughput」と題した記事を公開した。この記事では、ローカルLLMサーバー4種(llama.cpp、llamafile、LM Studio、Ollama)をMac・Linux・Steam Deckの3環境でベンチマーク比較し、スループットに最も影響した要因について詳しく紹介されている。
Mozilla.aiは、Mozillaが支援するAI研究組織で、オープンで信頼できるAIエコシステムの構築を目的としている。今回の比較対象のひとつであるllamafileはMozilla.aiが開発・メンテナンスするプロジェクトであり、LLMを単一の実行可能ファイルとして配布できる形式だ。自らが開発するツールを含めた横断的な比較を公開した点は、透明性という観点で注目に値する。
最大63%の差を生んだのは「エンジンの選択」ではなく「設定」だった
この検証で最も重要な発見は、4つのサーバーどれを選ぶかよりも、どのようにビルド・設定するかのほうがはるかに大きな性能差を生んだ点だ。
具体的に出た数字を挙げる:
- llamafileのCUDAバックエンドでCUDA graphsを有効化したところ、L40S環境でのデコード速度が0.8Bモデルで**+16.8%、9Bで+6.5%、27Bで+4.3%**向上した。それ以前のshippedビルドはCUDA graphsなしでコンパイルされていた。
- Steam Deck(Vulkan)のシェーダーコンパイラを更新(Ubuntu 24.04付属の shaderc 2023.8 → LunarG Vulkan SDK 2026.03)することで、同一コミットのllamafileでプロンプト処理速度が0.8Bモデルで**+25.9%、9Bモデルで+63.3%**改善した。
- Speculative decoding(投機的デコーディング)のドラフト長は、Metalでは2トークンが最適だが、CUDAでは4トークンが最大**+16%**優位になる。Metal環境でOllamaのデフォルト(ドラフト4)を使った場合、27Bモデルのデコードが投機デコードなし(23.4 tok/s)を下回り、約15 tok/sまで落ちた。
4つのサーバーはいずれも内部でllama.cppを使い、同じGGUF形式のモデルファイルを処理している。重みと環境を揃えると、プロンプト処理速度は互いに数%以内に収まる。差が出るのはビルドフラグ、シェーダーツールチェーン、デコード設定の組み合わせだ。
テスト環境と方法
| 環境 | ハードウェア | OS | テストモデル |
|---|---|---|---|
| Mac Studio | M4 Max、64GB統合メモリ | macOS Tahoe 26.6.2 | Qwen3.5 0.8B / 9B / 27B |
| Steam Deck | AMD Van Gogh APU、16GB共有メモリ | SteamOS 3.8.16 | Qwen3.5 0.8B / 9B |
| Linux L40S | Intel Xeon Gold 6338、NVIDIA L40S 48GB VRAM | Ubuntu 24.04.3 LTS | Qwen3.5 0.8B / 9B / 27B |
ソフトウェアは3台で統一:llama.cpp b10441、llamafile 0.10.6、Ollama 0.34.0、LM Studio runtime 2.28.2。
測定は各サーバーを再起動してKVキャッシュをコールドな状態からスタートし、15回実行(1回目はウォームアップ除外、最速2・最遅2を除いた中央10回の平均)。計測値はプロンプト処理速度(PP)とトークン生成速度(TG)の2種類。
環境別の結果
Linux / NVIDIA L40S
プロンプト処理は4サーバー間でほぼ差がない。差が出るのはトークン生成で、llama.cppとllamafileがリードし、OllamaはL40S環境の27Bで首位に立つ。
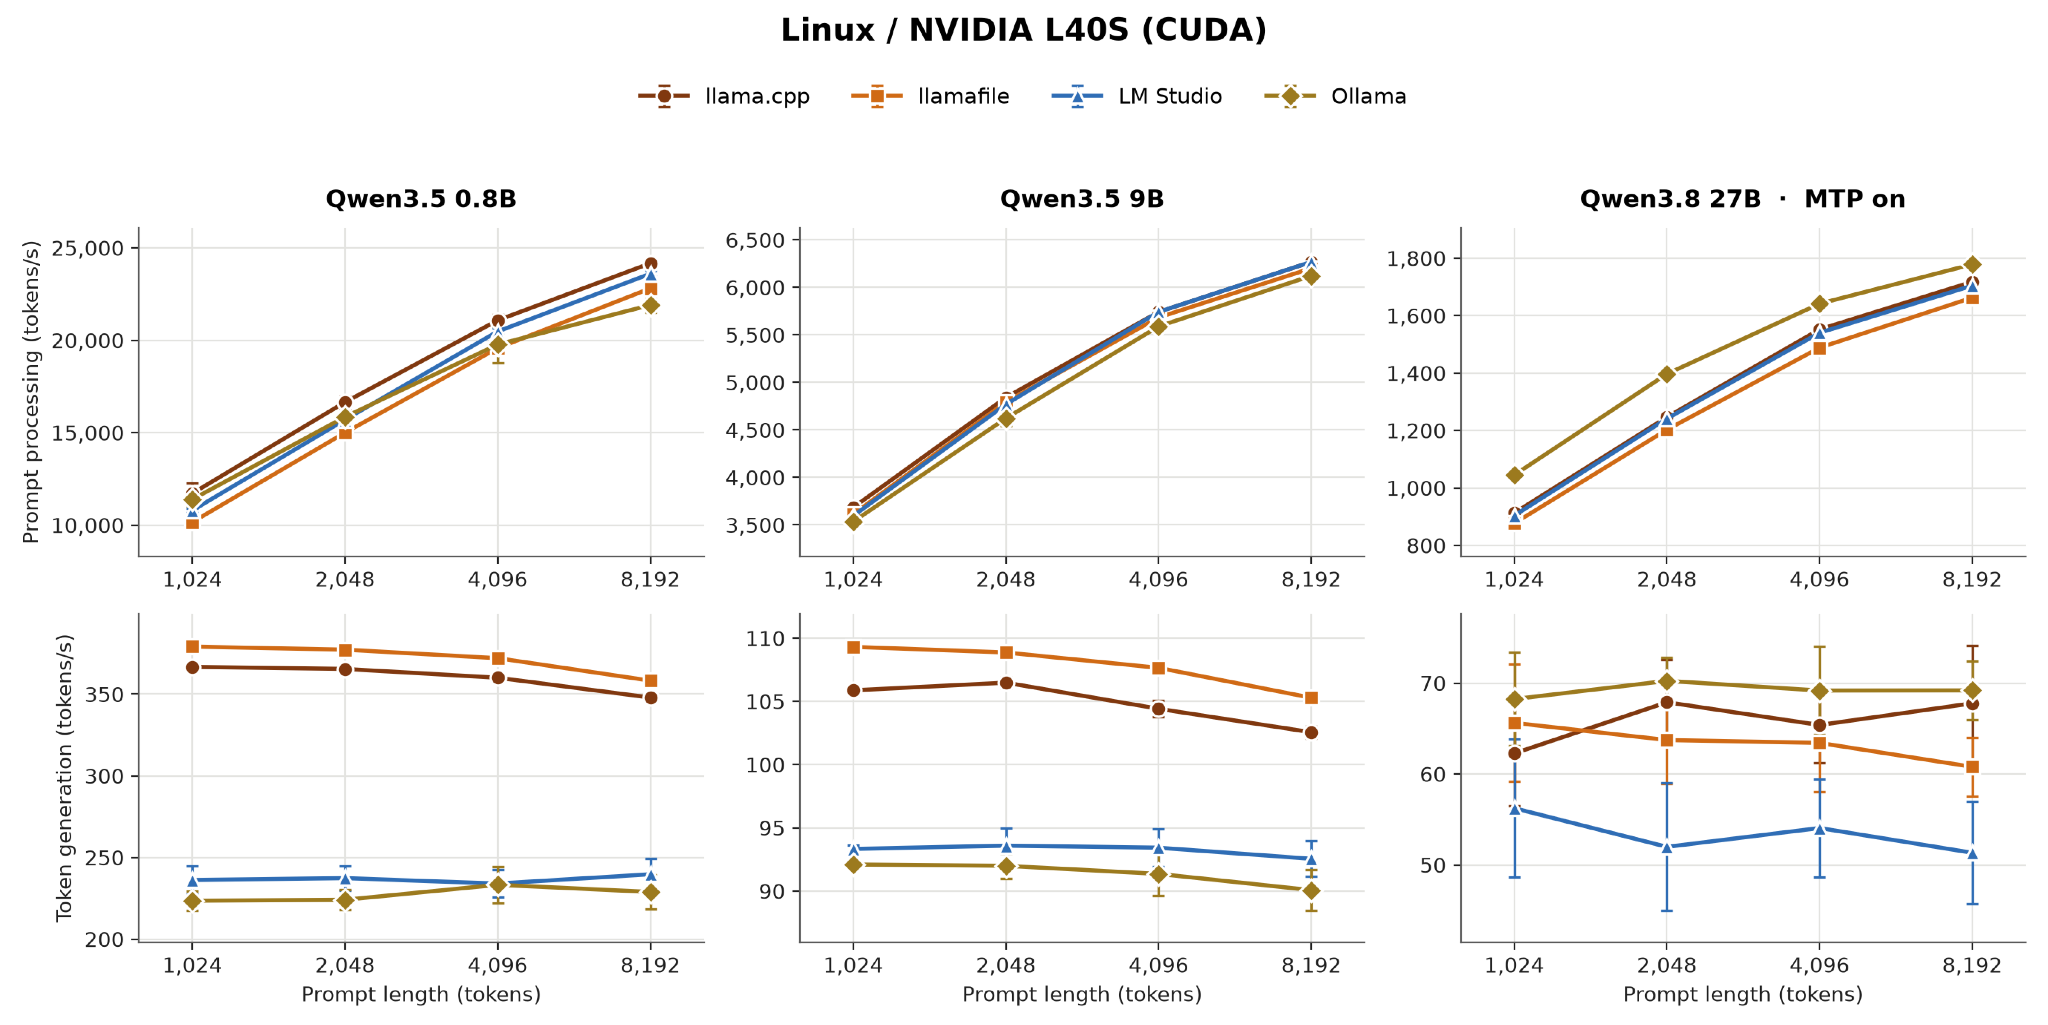
デコード速度の差の大半は、GPUの処理差ではなくホスト側の固定オーバーヘッド(トークンあたり約1.8ms)と推定されている。速いモデルでは67%差に見え、遅いモデルでは18%差に見えるが、絶対値はほぼ一定だ。
Mac Studio(Apple M4 Max / Metal)
プロンプト処理はllama.cpp・llamafile・Ollamaが±3%以内に収まる。LM Studioは小さいモデルで固定コストと思われる遅延がある。
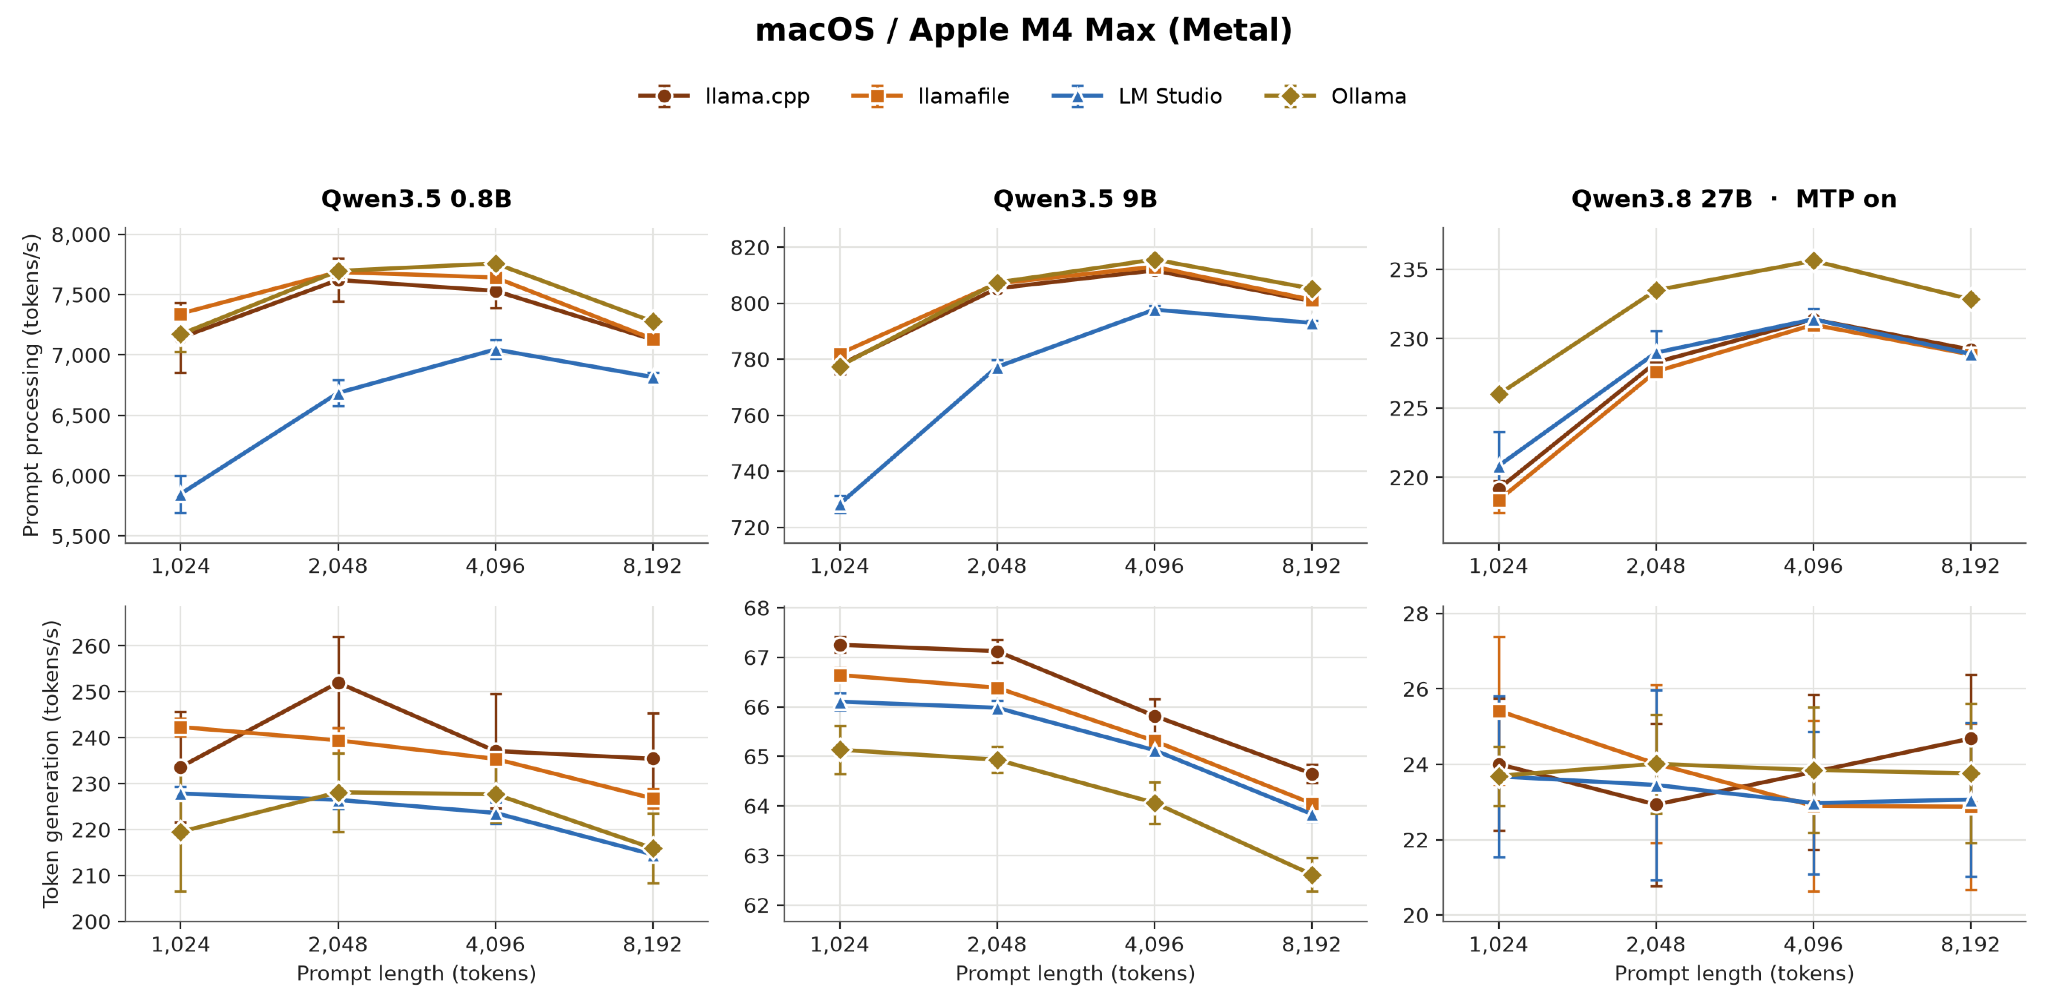
Apple SiliconではOllamaとLM StudioがGGUFではなく**MLX**をデフォルトで使う点にも触れている。MLXはAppleが開発したApple Silicon向けの機械学習フレームワークで、GGUFとは異なる独自の実行パスを持つ。27Bモデルで比較すると、MLXはGGUFに対してプロンプト処理で約10%高速。ただし、OllamaのMLXランナーは自動でSpeculative decodingを有効化し、LM StudioのMLXはしないため、両者のトークン生成速度は直接比較できない。なお、llama.cppとllamafileにはMLXパスがない。
Steam Deck(AMD Van Gogh APU / Vulkan)
最も大きな差が出た環境で、その原因はほぼシェーダーコンパイラのバージョン差だ。llama.cppとllamafileがリード、Ollamaがその下、LM Studioが最も遅く、特に9Bのトークン生成で差が顕著だった。
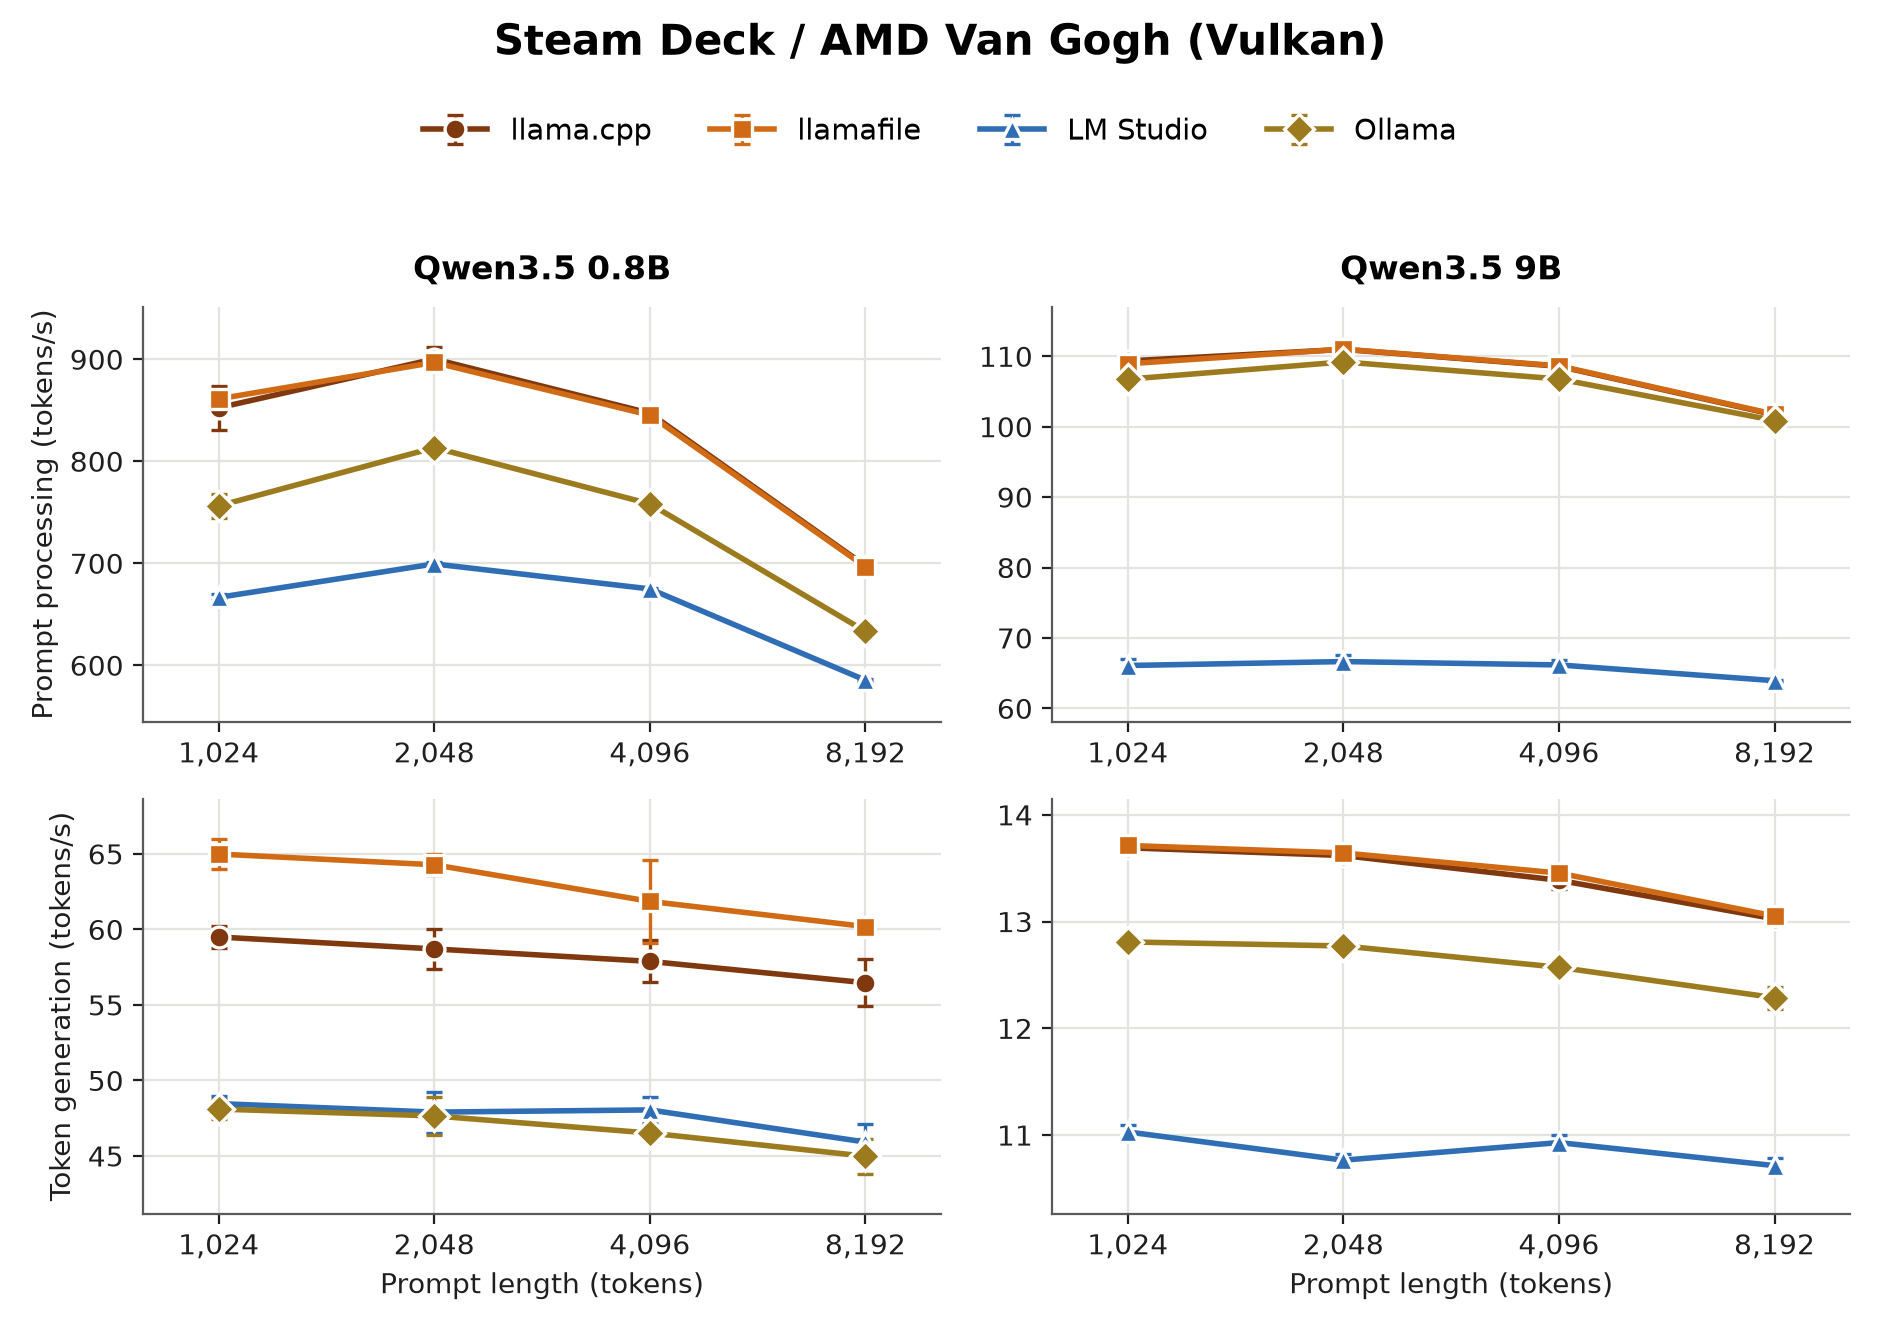
LM Studioの遅さはプリビルドで配布されるランタイムに起因しており、ユーザー側での修正ができない。
プロンプト処理速度カーブが環境で異なる理由
L40Sではプロンプトが長くなるほどスループットが上昇し、Macでは上昇後に下降、Steam Deckでは一貫して下降する。この違いは、Prefill時間を t(n) = c + a·n + b·n²(固定コスト+線形項+二次のAttentionコスト)でモデル化すると説明できる。
平易に言い換えると、「プロンプトが長くなるほどトークンあたりの処理時間が増える二次的なコスト(Attentionの計算量)がいつ支配的になるか」がハードウェアによって異なる、ということだ。スループットのピーク点 n* = √(c/b) がL40SではApproximately 27,000トークン(テスト範囲外)、Macでは約2,800トークン、Steam Deckでは約2,000トークンにある。つまりL40Sは非常に長いプロンプトでも速度が落ちにくく、Steam DeckはプロンプトがわずかでもAttentionコストの影響を受けやすい、という特性の違いとして読み取れる。
実践的なアドバイス
Mozilla.aiが記事内でまとめた実践的な指針は以下の通りだ:
- どのサーバーを使うかよりも、どのようにビルドされたかを確認する。 同じエンジンでも2通りのコンパイルでSteam Deckでは1.6倍の差が出た。
- Speculative decodingのドラフト長はプラットフォームに合わせる。 MetalとCUDAで最適値が逆転する。
- プロンプト処理とトークン生成を分けて評価する。 長文要約ではPPが支配的、チャットやコード補完ではTGが支配的になる。
- 実行中の他プロセスに注意する。 バックグラウンドの負荷が結果に影響する。
詳細はBenchmarking llama.cpp vs llamafile vs LM Studio vs Ollama: What Moved Throughputを参照していただきたい。
