11月21日、Salesforceが「How AI Agents Cut Production Change Reviews From 24 Hours to 12 Seconds」と題した記事を公開した。Salesforce社内で構築されたAIエージェント「ROAM」が、18製品にまたがる本番パッチレビューを24時間から12秒に短縮した実装事例だ。最大の設計上の特徴は「LLMに承認の最終判断を委ねない」という原則であり、550件超のレビューで誤承認件数はゼロを記録している。
24時間かかっていたレビューが、なぜ12秒になったのか
Salesforceのリリース運用チームは毎週、Revenue Cloudを含む18製品にまたがる15〜20件の本番パッチをレビューしていた。Slack、変更管理レコード、QA証跡、リリースカレンダーを行き来する作業はチームをボトルネックにし、申請者は進捗確認に追われ、クラウドリーダーはブロックされた変更の状況を把握できずにいた。
この課題を解決するために構築されたのが、ROAM(Release Operations Agentic Manager)だ。SalesforceのAIエージェントフレームワークAgentforceのパターンを適用し、変更レビューに必要な証跡を収集・解釈しながら、各承認ゲートの充足状況を判定する。
550件超のCAB(Change Advisory Board:本番変更の可否を審査する承認委員会)レビューを10週間にわたって処理した結果は以下のとおりだ。
- 誤承認件数:ゼロ
- 中央値レスポンスタイム:約12秒(Slackへの投稿から返信まで)
- 95パーセンタイル:45秒未満
この結果を受け、リリースエンジニアリングチームはROAMを18製品すべての本番パッチに対して必須とした。
最重要設計原則:「ゲートが決定し、LLMは説明する」
ROAMの設計で最も重要なのが、LLMに承認の最終判断を委ねないという原則だ。
記事の中でチームが挙げる「危険な振る舞い」は、未検証のサインオフを事実として扱うことだ。プロンプト改善だけではこのリスクを制御できない。そこでチームが採用した原則が明快に述べられている。
「ゲートが決定し、LLMは説明する(the gate decides, and the LLM narrates)」
具体的には、決定論的なコードが変更フィールド・テスト実行・プルリクエスト・承認履歴を読み取り、モデルはその結果を説明するだけだ。モデルの出力がコードによる判定と食い違った場合、モデルが負ける。
各承認ゲートの検証条件も厳格に定義されている。
- QA確認:対象リリースブランチでのテスト実行がリンクされ、パスしていること
- デュアルデベロッパーレビュー:プルリクエスト作成者を除く、リポジトリのコミット権限を持つ開発者2名の承認
- アーキテクトサインオフ:変更レコードに記載されたアーキテクト本人からの承認
- クラウドリーダー承認:バージョン管理されたリーダー名簿の現在のメンバーからの承認
いずれかのゲートを確認できない場合、ROAMはレビューを人間にルーティングする。**自動判定を行わないケースは全体の約8%**だ。自動化率より判定精度を優先するという設計判断が、チームの信頼を獲得した核心にある。
異なるスキーマをまたぐ統合の落とし穴
ROAMが直面した技術的難所は、3つの異なるスキーマの統合だ。
- Slack:非構造化の会話ログ
- GUS(Salesforce社内の変更管理データベース):変更フィールドとネストされたアクティビティフィード
- リリースカレンダー:デプロイウィンドウとクラウドオーナー情報
本番稼働直後、クライアントがネストされた返信の誤ったフィールド名を参照し、一部の承認がサイレントに欠落するバグが発生した。モデルは不完全な承認履歴を受け取ったまま処理を続けた。
これに対してチームが導入したのが、実際のライブペイロードを記録したAPIコントラクトテストだ。プルリクエストのたびにスキーマの一致を検証し、不一致があればビルドを失敗させる。「より良いプロンプトでは、モデルに届かなかった承認を取り戻せない」という教訓が、この設計の背景にある。
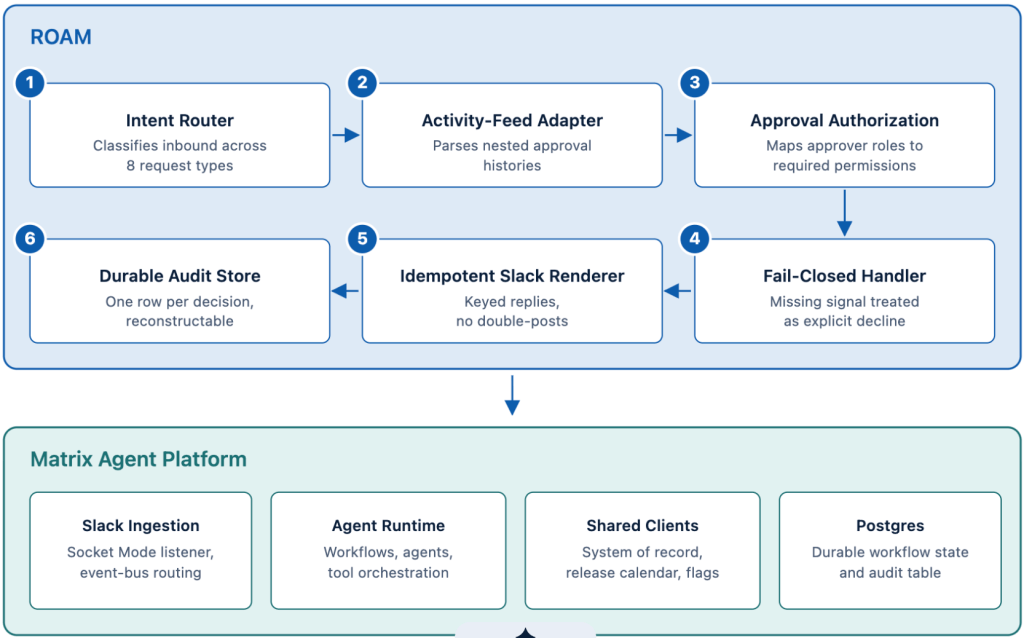
ROAMのシステム構成図。Slack・GUS・リリースカレンダーの3つのデータソースを統合し、決定論的なゲート判定とLLMによる説明生成を組み合わせた承認自動化パイプラインを示している
AI支援開発の落とし穴:グリーンのテストが嘘をつく
元記事によれば、ROAMのコードベースの「約70%はAgentforce支援のコーディングワークフローで生成・改善された」とされている。残りの30%——コアオーケストレーション、モデル分類器の配線、アクティビティフィードパーサーなど——はエンジニアが直接記述した。
AI生成コードで問題になったのがテストランナーのサイレント失敗だ。スイートをスキップしたままグリーンを報告するケースがあり、エージェント自身が「修正はパスした」と報告しても、それだけでは正しさの証明にならない。これに対してチームは、検証エージェントが影響を受けるスイートを再実行し、フィックスエージェントの自己報告とは独立してexit codeを確認する仕組みを導入した。
ユニットテストと機能テストのカバレッジは目標80%に対して90%台を達成。これらの検証体制を整えた上で、ROAMは約4週間で本番稼働に至った。
保留中CABの一覧をSlashコマンドで取得
個別レビューの改善に加え、リリースレポートも変わった。保留中のCABとブロッカーを調べる際に手動でDBクエリを実行していた作業が、1秒未満で返るSlashコマンドに置き換わった。Revenue CloudやHealth Cloudなど、クラウド固有のCABサマリーをSlack上でリクエストすることもできる。
詳細はHow AI Agents Cut Production Change Reviews From 24 Hours to 12 Secondsを参照していただきたい。
