11月21日、Nick Lewisが「I tried replacing Claude with a free local AI model for a week. The responses weren't the problem」と題した記事を公開した。Claude Sonnet 5.5のクラウドAIをローカルAI(Qwen3-4B)に1週間置き換えた体験を通じ、応答品質以外のボトルネックが実使用上の障壁になることを詳しくレポートしている。
ローカルAIは「回答の質」では意外と戦える
筆者はIntel Core i9-13900H・RAM 16GBのラップトップ上で、LM Studio(ローカルLLMをGUI操作で手軽に動かせるデスクトップアプリ)を使い、Qwen3-4B-Instruct-2507(Q4_K_M量子化、2.5GB)をローカル実行した。比較対象はClaude Sonnet 5.5(デフォルトのMedium effortモード)だ。ベンチマークではなく、実際の業務で使いそうなタスクで評価している点が本記事の読みどころである。
なお、Q4_K_Mとは量子化方式の一種で、モデルの重みを4ビット精度に圧縮しメモリ使用量を削減する手法だ。精度をわずかに犠牲にする代わりに、一般的なラップトップでも動作できるサイズに収める。
最初の印象は「想定より使える」だった。ExcelのLET関数の説明を求めたところ、構文・例ともに正確な回答が返ってきた。また、Microsoftの長文Windowsアナウンスをペーストして要約させたところ、主要な変更点を的確に抜き出せた。数日で実験を打ち切っていたら「ローカルAIで十分」と結論づけていたかもしれない、と筆者は書いている。
「判断」を求めると崩れ始める
問題が浮上したのは、情報を引き出す質問から判断や編集的な思考を求めるタスクに移ったときだ。
記事のアイデア出しや見出し案の生成を依頼すると、モデルは「USBポートがスマートフォンのバッテリーを徐々に劣化させる」という記事アイデアを提案し、テスト手法・発見・結論まで自分で作り上げた。まだ検証もしていない段階なのに、既に結論が存在するかのように振る舞ったのだ。
さらに顕著だったのが、実験そのものについて議論したときだ。「1週間ローカルAIをテストした体験に記事の価値はあるか?」と尋ねると、プロンプトには一切登場しない「デジタル主権」「クラウド非依存」「デジタルフリーダム」といった概念を唐突に持ち出してきた。指摘すると修正はするものの、同じプロセスが一週間繰り返された。モデルの推論を評価する時間が、モデルを使う時間と同じくらいかかったという。
同じプロンプトをClaude Sonnet 5.5に投げると、即座に筆者のフレーミング自体に疑問を呈し、「そもそもどのタスクがクラウドAIを必要とするのか、そちらの方が面白い記事になる」と返してきた。Claudeは会話に感じたが、ローカルモデルはバッチ処理に感じた、という表現が端的に違いを表している。
本当のコスト:ラップトップが会話の一部になる
記事で最も実用的な示唆を含むのがこのセクションだ。
前述のWindows要約タスクで、筆者はレスポンス完了まで約5分待った。その間、Windowsのタスクマネージャーはメモリ使用率**97%**を表示し、冷却ファンは「747が離陸準備をするような音」を立てた。Claude Sonnet 5.5は同じタスクを、時計を確認する前に終わらせていた。
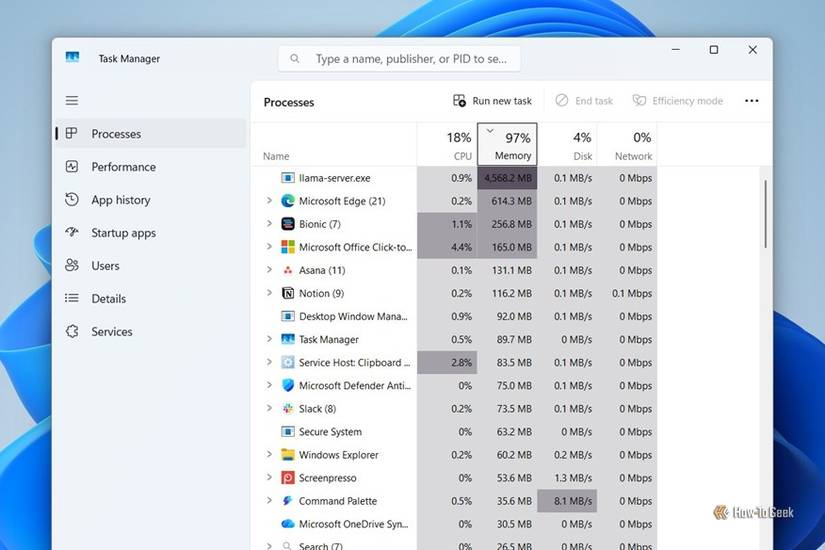
この体験が日常使いに与えた影響は小さくない。クラウドAIを使うときは会話だけを考えればよかったが、ローカルAIを使うときはハードウェアを意識し続けた。長いプロンプトを避けるようになり、RAMの残量を気にするようになり、「この質問は待つ価値があるか」を毎回判断するようになった。ローカルでAIを動かすことで、普段は見えないインフラが可視化された、というのが筆者の表現だ。
これはスペック不足の問題というより、CPU推論という構成上の制約でもある。クラウドAIはデータセンターの専用ハードウェア上でGPU推論を行うのに対し、今回の構成ではCPUがすべての計算を担うため、速度と発熱の両面で差が生じやすい。
ローカルAIが優位な領域は確かにある
とはいえ、筆者はローカルAIを全否定しているわけではない。プライバシーが重要な用途(社内の機密文書の処理など)、オフライン環境での利用、コスト削減が目的の場合は、ローカル実行に合理的な理由がある。「何のためにローカルで動かすのか」が明確であれば、Qwen3-4Bクラスのモデルは十分に実用的だ、というのが結論だ。
ローカルAIはデータが外部サーバーに送信されないため、機密性の高いドキュメントを扱うシーンでの優位性は明確だ。また、一度モデルをダウンロードしてしまえばランニングコストがかからない点も、大量のテキスト処理を繰り返すユースケースでは見逃せない。
ただし、今回の構成(CPU推論、RAM 16GB)ではレスポンス速度とハードウェア負荷が実使用上の制約になる。GPUを搭載したマシンや、より多くのRAMがあれば体験は大きく変わる可能性がある点は留保しておく必要がある。用途と環境を整理した上で選択するのが現実的な判断だろう。
詳細はI tried replacing Claude with a free local AI model for a week. The responses weren't the problemを参照していただきたい。
