11月19日、OpenAIが「How OpenAI's Performance Factory keeps ChatGPT fast」と題した記事を公開した。この記事では、AIエージェント(Codex)を活用してChatGPTのパフォーマンス低下を自動検出・修正する内部システム「Performance Factory」の設計と運用について詳しく紹介されている。わずか3ヶ月強で1,700件超の調査を追跡し、1日あたり17件のペースでリグレッションを自動検出・修正するというその規模は、エージェントワークフローの実用的な到達点として注目に値する。
AIがAIのパフォーマンス問題を自動修正する
ChatGPTのような大規模サービスでは、コードの変更や設定変更によるパフォーマンスリグレッション(性能劣化)が日常的に発生する。従来はエンジニアがメトリクスやログを手動で調査していたが、開発速度の加速とともにその手法は限界を迎えつつあった。
OpenAIはこの課題に対し、Codex(後述)を中核に据えた自律的なパフォーマンス管理システム「Performance Factory」を構築した。同システムはわずか3ヶ月強で1,700件以上の調査を追跡し、600件超のリグレッションの根本原因を特定した。これは1日あたり17件の自動調査に相当する。
※ Codexについて: ここで言う「Codex」は、かつてGitHub Copilotの基盤として知られた旧来のコード補完モデル(OpenAI Codex、2021年)とは別物である。本記事が指すのは、2024年以降OpenAIが開発・提供しているAIコーディングエージェントとしての新しいCodexであり、コードの読み書きだけでなく、ツール実行・調査・PR作成といった一連の開発タスクを自律的にこなす能力を持つ。
手作業から「エージェントファクトリー」への進化
記事では、チームの働き方がどのように変化したかを6段階で整理している。エンジニアリングチームがエージェントワークフローを採用する際の参考になる。
- Codex導入前: エンジニアがメトリクス・ログ・トレースを手動で調査。30以上のパフォーマンスツールを蓄積した。
- Codexをパートナーとして活用: エンジニアが「なぜ遅くなった?」と問いかけながらCodexと協働。ただし調査の舵取りは人間が担う。
- 再利用可能なスキル: 調査プロセスを
perf-forensics(※パフォーマンス上の問題を法医学的に掘り下げる社内共有スキル。アラートを渡すだけで診断が返ってくるよう設計されている)という共有スキルにまとめ、再利用可能な形に整備した。 - 人間がプロキシ化: アラートが発火するたびに、エンジニアがCodexへコピペして結果をSlackに貼り返すだけの作業になった。
- 自動調査: アラートをトリガーにクラウドでCodexが自動実行し、結果をSlackスレッドに投稿。ただし修正・検証は人間が担当。
- ファクトリー化: 調査→修正提案→レビュー→デプロイ後検証まで、一連のワークフローをエンドツーエンドで自動化。
Performance Factoryの構成
システムは4つのコンポーネントで成り立っている。
- タスクサービス: ワークフローの定義と状態管理。Markdownでプロンプトを記述するだけでワークフローを追加できる。
- ディスパッチループ: 次のステップが実行可能なタスクを定期的に確認し、Codexエージェントをアサイン。
- クラウド実行API: Codexをクラウド上のサービスアイデンティティ(※人間の個人アカウントではなく、サービスやシステムに紐づく専用の実行主体。権限管理・監査ログの観点から、自動化されたエージェント処理に適している)で動かし、コードリポジトリや社内の観測ツール(メトリクス、ログ、トレース、CPUプロファイル、メモリスナップショット)へのアクセスを付与。
- サブスクリプション: GitHubのPRレビューコメントやCI失敗など、外部イベントをトリガーにエージェントを再起動する仕組み。
エンジニアのラップトップが開いていることに依存せず、並列で複数タスクをこなせる点が大きな利点である。
最初のワークフロー:アラートから復旧まで
Regression Workflowと呼ばれる最初のワークフローは、パフォーマンスアラートの発火から自動的に動き出す。タスクは以下のステージを順に進む:
検出 → 根本原因の特定(エージェント)→ 修正提案(エージェント)→ レビュー・デプロイ(エンジニア)→ 復旧確認(エージェント)→ 完了
敵対的レビューで診断精度を上げる
初期段階では、エージェントが最初に見つけた「もっともらしい説明」で調査を止めてしまい、誤診になるケースがあった。これを防ぐため、別のCodexセッションが提案された診断を反証しようと試みる「敵対的レビュー」を導入した。
具体例として、あるケースではエージェントが「画像ダウンロードのエラーが原因」と特定した。しかし敵対的レビューを担当したCodexが、ファイル位置を管理する内部サービスがすでに回復しているにもかかわらず画像リクエストが失敗し続けていることを発見し、調査を差し戻した。
100件の根本原因提案を人手でレビューした結果、70%が正確、30%は追加の精査が必要だった。チェックアンドバランスの仕組みが精度向上に寄与している。
修正の自動生成は「難しい方」
根本原因の特定よりも、修正コードの生成の方が難易度が高いとOpenAIは率直に述べている。エージェントが提案する変更が必要以上に複雑だったり、新たな問題を引き込んだりするケースが見られた。修正提案にも同様の敵対的レビューを導入し、根本原因への対処と副作用の有無を確認している。
また、キャッシュの追加といった変更は性能改善につながる一方でデータの鮮度に影響する可能性があり、サービスのトレードオフを知るエンジニアの判断が必要な場面も残る。今後は合成パフォーマンステストを使ってエージェントが修正効果を事前計測し、低リスクな変更についてはエンジニアのレビューなしに直接デプロイすることも検討中だ。
実運用から得た知見
記事後半ではいくつかの教訓が紹介されている。
- エンジニアの注意力を守る: Codexが出力する生テキストは量が多く、読み解くのに時間がかかる。エンジニアが「調査の再現」ではなく「意思決定」に集中できるよう、タスクレポートを自動生成し、メトリクスのグラフやCPUフレームグラフを埋め込んで設計している。
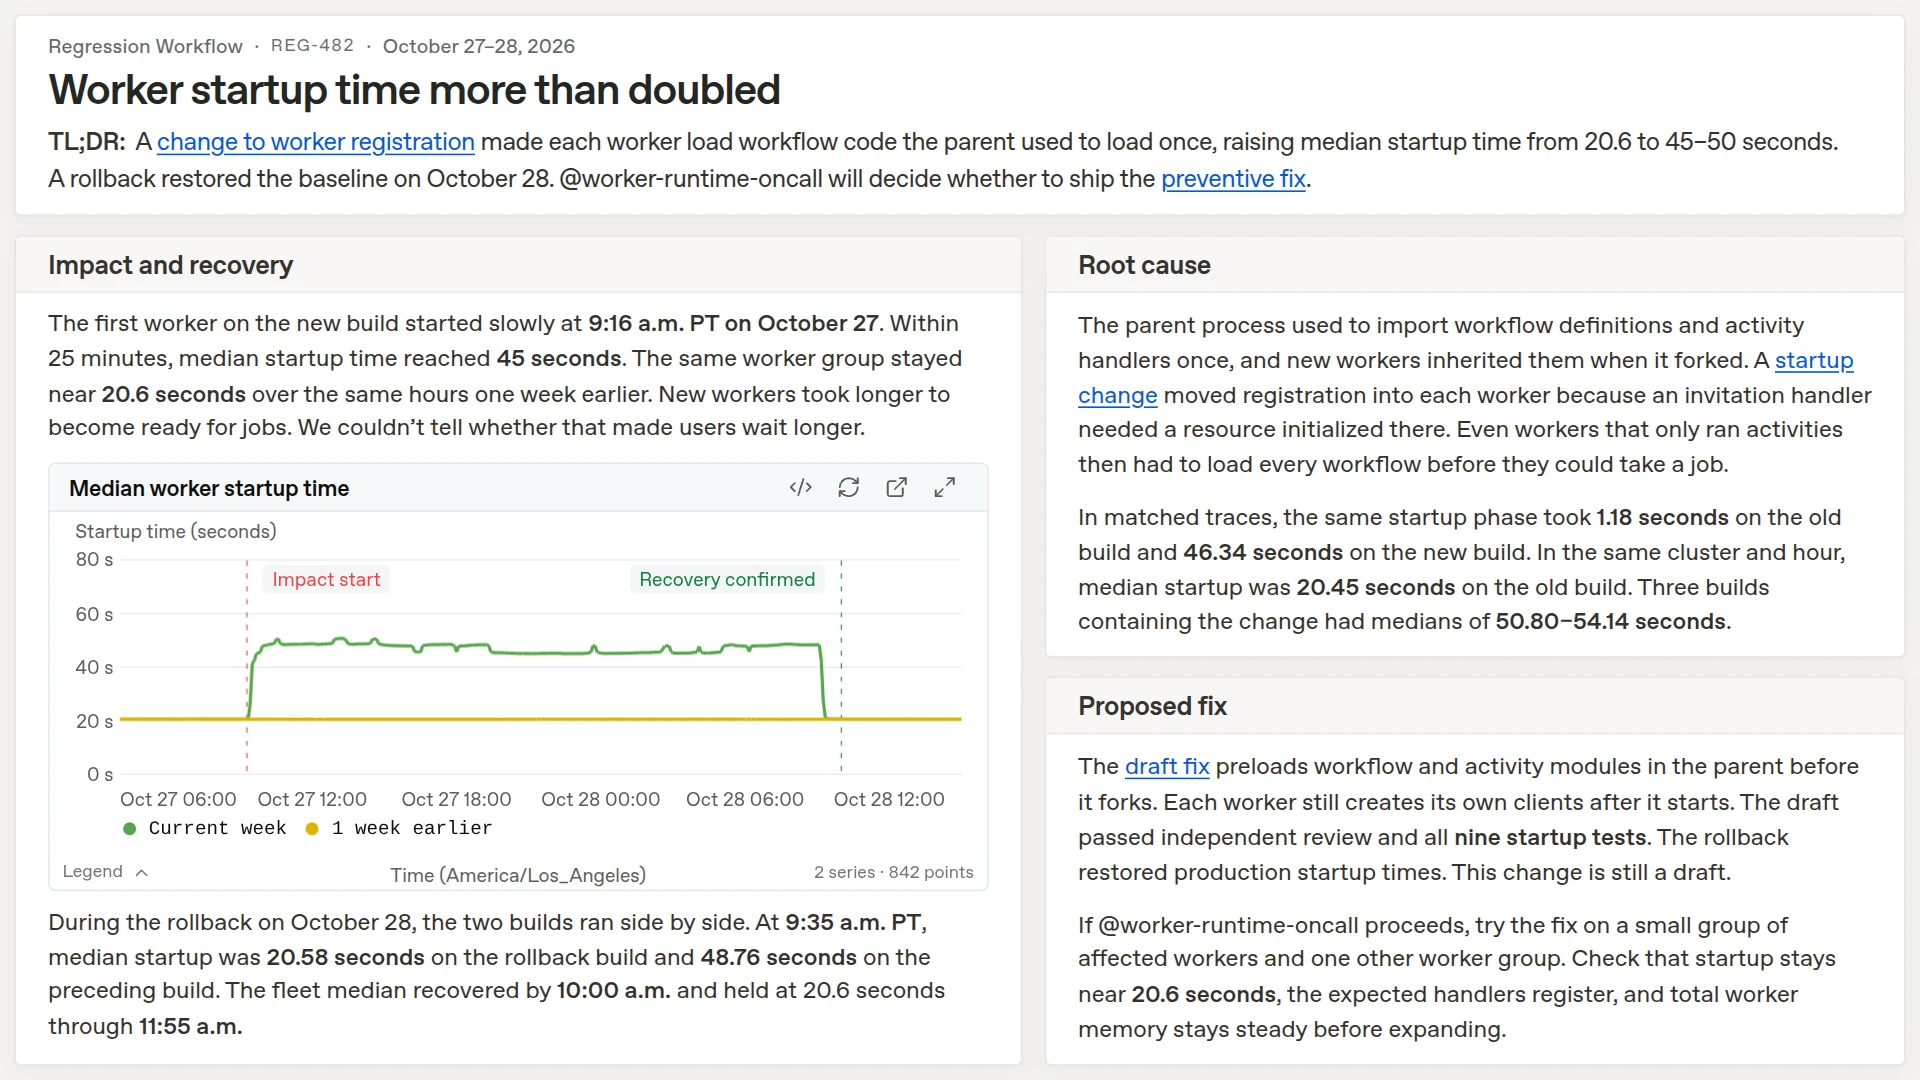
ワーカー起動時間が2倍以上に増加したリグレッションのタスクレポート例
AIを使ってAIサービスのパフォーマンス問題を解決するという構図は、エージェントワークフローの実用的な到達点の一つを示している。Performance FactoryはOpenAI社内のツールだが、「手動調査→Codexとの協働→再利用可能なスキル化→人間がプロキシ→自動調査→ファクトリー化」という段階的な自動化のプロセスは、他のサービスチームにも転用できる設計思想を含んでいる。エンジニアをルーティン作業から解放しつつ、判断が必要な局面では人間が関与し続けるという構造は、現時点におけるエージェント活用の一つの現実解として参照価値が高い。
詳細はHow OpenAI's Performance Factory keeps ChatGPT fastを参照していただきたい。
