11月16日、Sergio De Simoneが「Uber's Secure AI Framework Governs Autonomous AI Agents Across Their Lifecycle」と題した記事を公開した。AIエージェントが外部コンテンツを動的に処理し実世界で自律的にアクションを取るようになった今、従来の認証・認可モデルだけでは「そのアクションがコンテキスト上適切かどうか」を判断できないという根本的な限界が露わになっている。Uberはその限界に正面から向き合い、エージェントのライフサイクル全体をカバーするセキュリティフレームワークを開発・本番運用している。
従来のID管理・API制御では対応できない
AIエージェントが外部コンテンツを動的に処理し、実世界で自律的にアクションを取るようになると、従来の認証・認可モデルが機能しなくなる場面が出てくる。
Uberのエンジニアリングブログ(原文)はその問題をこう表現している。
Identity and authorization systems can determine whether a user or service has permission to access a resource, but they can't determine whether an agent's proposed action is appropriate in context.
(IDおよび認可システムは、ユーザーやサービスがリソースにアクセスできるかどうかは判断できるが、エージェントが提案しているアクションがそのコンテキストにおいて適切かどうかは判断できない)
この限界から生じるリスクとして、Uberはプロンプトインジェクション、ツールやメモリへの汚染(poisoning)、目標のハイジャック(goal hijacking)、行動のドリフト(behavioral drift)、ハルシネーション(幻覚)に基づくアクション実行などを挙げている。これらは既存のAPIゲートウェイやIAMの枠組みでは検出・防止が難しい攻撃・障害だ。
3層構造のフレームワーク:プロビジョニング→ランタイム→継続的保証
Uberのフレームワークは、エージェントのライフサイクル全体を3つのフェーズでカバーする。
1. プロビジョニング時:Uber AI Registry + Argus
デプロイ前の段階で、すべてのエージェントをUber AI Registryに登録することが必須となる。登録時に確立するのは以下の情報だ。
- エージェントのID・オーナーシップ・ペルソナ
- 許可されたインテント(意図)と制約
- 依存関係とリスク分類
この登録プロセスはArgusというツールで自動化される。Argusはエージェントのソースコード、プロンプト、設定ファイル、依存関係、公開エンドポイント、ツール呼び出しパスを静的解析してセキュリティ上の弱点を特定する。MCPサーバー(Model Context Protocol:AIエージェントが外部ツールと連携するための標準プロトコル)やエージェントが使用するツールにも同じアプローチが適用される。
2. ランタイム:行動認可(Behavioral Authorization)
実行時には、従来のポリシー管理・ポリシー判断・ポリシー強制という3層モデルを拡張し、行動認可という概念を導入している。これは「エージェントのアクションが、そのコンテキストにおいて適切かどうか」を評価するものだ。
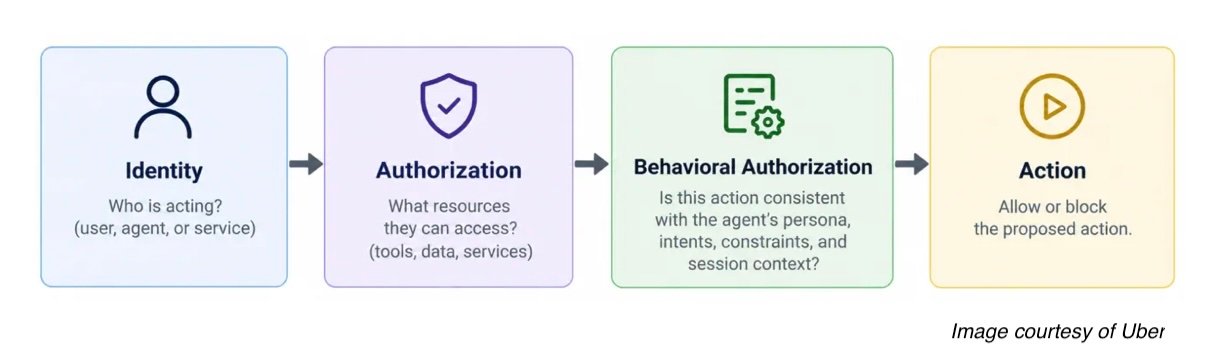
実装は3つのコンポーネントで構成される。
- AI Registry:エージェントのポリシー、ペルソナ、インテント、制約を定義・管理
- AI Guards:インタラクションや提案されたアクションを、確立されたポリシーに照らして評価
- Agent Guard ランタイムフック:重要なチェックポイントでAI Guardを呼び出し、判定結果を適用してからアクションを許可
3. デプロイ後:Continuous Assurance(継続的保証)
デプロイ後のフェーズでは、エンドツーエンドの観測可能性・監査・説明可能性・リプレイに重点が置かれる。
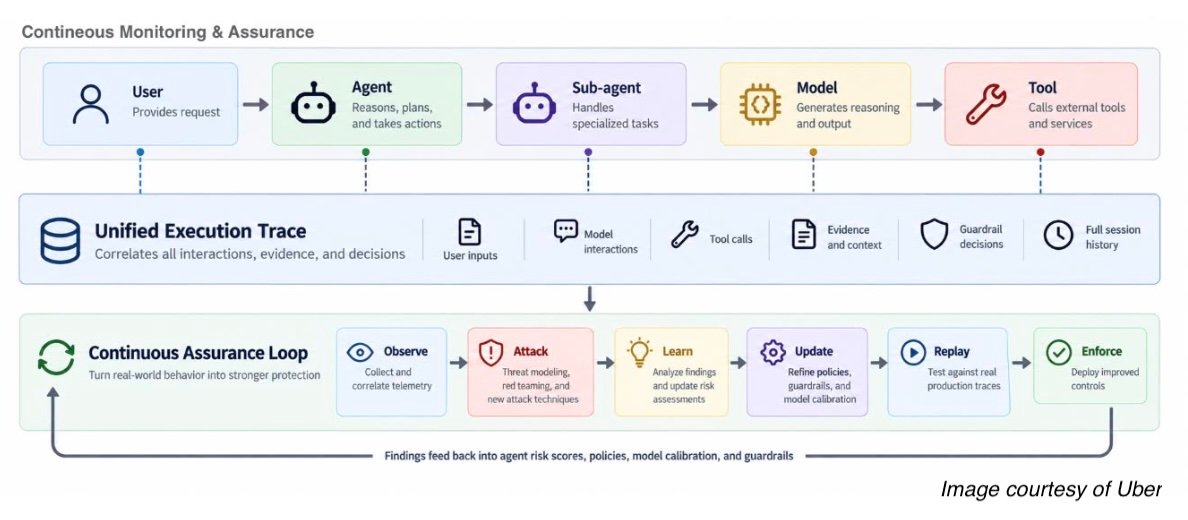
主要コンポーネントは2つ。エージェントのアクション・ツール呼び出し・セキュリティ判断をつなぐ統合実行トレースと、ポリシーやガードレールが更新された際にその効果を検証するためのインタラクション録画とリプレイ機能だ。
実装で直面した課題と、最も効果的だった制御
Uberは本番環境での実装における課題も正直に開示している。ポリシーの厳格さのバランス調整(false positiveが多すぎる vs. 保護が不十分)、ランタイムレイテンシの最小化、開発者の導入摩擦の低減、そして汎用的な制御からエージェント固有のポリシーへの移行が主な課題として挙げられている。
この最後の点について、元記事のLinkedInコメント欄でAIアーキテクトのPratik Dhanave(肩書きは元記事より)は次のように述べている。
The lesson they call least glamorous is the one they rate most effective: explicit intents and constraints per agent. Not generic thresholds, which failed because every agent has a different purpose and risk profile. The cost is flexibility, and they say it is worth paying.
(彼らが「最も地味」と表現しているのに、最も効果的と評価しているのが、エージェントごとの明示的なインテントと制約だ。汎用的なしきい値は機能しなかった。各エージェントは目的もリスクプロファイルも異なるからだ)
同じく元記事のLinkedInコメントで、上級ITオフィサーのTristan G.(肩書きは元記事より)は別の懸念を示している。
By its own account, the strongest control was restricting agents to explicit constraints, which is least privilege rather than a new idea. For me, the open question is how this works for agents you don't build, such as vendor or SaaS agents where you can't insert your own enforcement hooks.
(Uber自身の説明によれば、最強の制御は明示的な制約への制限、つまり最小権限の原則だ。新しいアイデアではない。私にとっての未解決問題は、自社で構築していないエージェント——ベンダーやSaaSエージェントで自前のフックを挿入できないケース——でこれがどう機能するかだ)
Tristan G.はさらに、エージェントごとのペルソナ・インテント・制約の設定が最大の価値をもたらす一方で、「ワークフローの数に応じてコストが線形にスケールする」点も指摘している。
詳細はUber's Secure AI Framework Governs Autonomous AI Agents Across Their Lifecycleを参照していただきたい。
