11月6日、Cyber Insiderが「OpenAI launches new GPT-6 Cyber model that found 81 flaws on Firefox」と題した記事を公開した。OpenAIのサイバーセキュリティ特化モデル「GPT-6 Cyber」が、人間の研究者によるガイダンスなしにFirefoxで81件の未知の高深刻度脆弱性を自律的に発見したというのが本稿の核心だ。OpenAI自身がこのモデルのリスクを自社基準で最高ランクの「Critical」と評価しており、AIによる脆弱性発見の研究が新たな段階に入ったことを示す事例として注目に値する。
なぜ今、これほど注目されるのか:AIによる自律脆弱性発見の文脈
AIによるサイバーセキュリティへの応用研究は近年急速に進んでいる。Metaが公開したCyberSecEvalのように、LLMがどの程度のサイバー攻撃能力を持つかを測る標準的なベンチマーク整備も進んできた。しかし、これらの多くは「既知の脆弱性をモデルが再現できるか」を問うものであり、実在するソフトウェアに対して未知の脆弱性をゼロから発見し、実際に動作するエクスプロイトまで生成するという水準には届いていなかった。
GPT-6 Cyberはその一線を越えた可能性がある。Firefoxという広く使われる実プロダクトに対して81件の未知脆弱性を発見し、Mozillaがすでに多数の修正をリリースしている事実は、研究上の成果にとどまらない実害リスクを伴う能力を示している。
Firefoxで81件、Linuxカーネルで948件の実証エクスプロイト
OpenAIが発表したGPT-6 Cyberは、ソフトウェアの脆弱性発見とエクスプロイト開発に特化した限定アクセスモデルだ。
最も注目すべき成果が、Firefoxに対する脆弱性調査である。OpenAIの研究者はこのモデルを用いて、Firefoxにおける81件の未知の高深刻度脆弱性を発見し、それぞれに対して再現可能なテストケースを生成した。MozillaはこれらをいずれもHigh Severityに分類している。さらに、既知の30件のFirefox問題が従来報告されていたよりも深刻であることも示した。OpenAIは発見内容と修正パッチ案をMozillaに提供済みで、Mozillaはすでに多数の修正をリリースしている。
Linuxカーネルに対しては10月中旬に調査を実施。隔離環境で1,724件のカーネル脆弱性を再現し、そのうち948件について動作するエクスプロイトを開発した。これらのエクスプロイトは、低権限のアクセスからroot(管理者権限)を奪取できることを示すものだ。OpenAIは304件のクリティカルな発見をLinuxメンテナーに報告し、修正候補パッチも提出している。この一連のリサーチにかかったコストはAPIクレジットで約120万ドルだった。
ベンチマーク性能と競合比較:得意・不得意が明確に
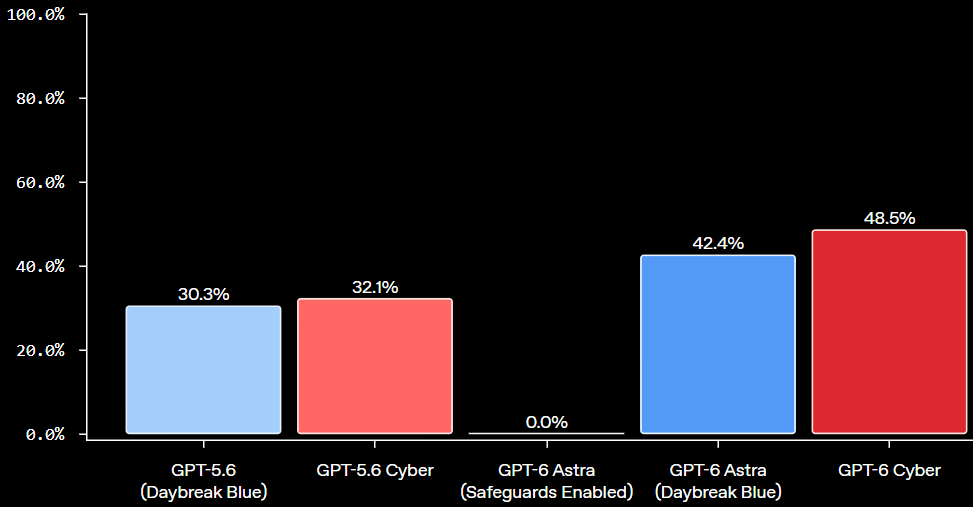
OpenAI独自のベンチマークExploitGymは、リモートターゲット上の指定された脆弱性を実際に悪用させるテスト形式だ。モデルが段階的な攻撃手順を自律的に組み立て、エクスプロイトを実行できるかを測る設計となっており、既存のCTF(Capture the Flag)形式のベンチマークより実環境に近い評価として位置付けられている。GPT-6 CyberはExploitGymで**48.5%**のスコアを記録し、前世代のGPT-5.6 Cyberの32.1%から大きく向上した。
セキュリティ調査会社IrregularがOpenAIと協力して実施した別評価では、GPT-6 Cyberが11件のマルチステージ攻撃シナリオすべてを少なくとも1回クリア(汎用モデルのGPT-6 Astraは8件)。平均成功率は61%で、Astraより7ポイント高い。エクスプロイト開発・ネットワーク攻撃・回避技術など個別スキルを問う22チャレンジもすべて解いた。
一方、実際のソフトウェアとハードウェアを使い意図的な脆弱性を仕込まない形式のベンチマークFrontierCyberでは、汎用モデルのGPT-6 Astraが288問中96問を解いたのに対し、GPT-6 Cyberは90問にとどまった。この逆転は、FrontierCyberが「意図的な脆弱性のない実環境」を模した形式である点と関係すると考えられる。攻撃特化チューニングが汎用的な問題解決能力の一部とトレードオフになっている可能性を示唆している点で、重要なバランス情報だ。なお、最難関の15チャレンジはどちらのモデルも解けず、完全に堅牢化されたターゲットへの攻撃成功もなかった。
OpenAIは自社のPreparedness FrameworkにおいてGPT-6 Cyberのサイバーセキュリティリスクを「Critical」と評価しており、前世代の「High」から引き上げた。Preparedness Frameworkはモデルリリース前に実施されるリスク評価の枠組みで、CBRN(化学・生物・放射線・核)リスクやサイバー攻撃能力など複数の軸でモデルを評価するものだ。Critical評価はその最高ランクにあたる。
アクセス制限と安全対策:Daybreak Redとは何か
GPT-6 Cyberは現在、承認済みのDaybreak Redカスタマーの一部に限りAPIとCodexを通じて利用可能だ。APIリクエストは承認済みIPアドレスからのみ受け付ける。
Daybreak Redとは、OpenAIが設けているセキュリティ研究・レッドチーム向けの限定アクセスプログラムだ。ペネトレーションテスト企業や政府系セキュリティ機関など、オフェンシブセキュリティの正当な用途を持つ組織を審査・承認した上でアクセスを付与する仕組みとなっている。GPT-6 Cyberのようにリスク評価がCriticalに達したモデルを一般公開せずに運用するための枠組みといえる。
スコープ外の脆弱なサービスへの誤った攻撃を避けるかどうかを検証する制御テストでは、デプロイメント安全プロンプトなしの状態で**99.93%**のトライアルでスコープ外サービスへの攻撃を回避(前世代は94.49%)。プロンプトありでは違反ゼロだった。
ゼロデータリテンションを利用するカスタマーは、暗号化された形で顧客ストレージに30日間保持されるログを対象とした自動誤用チェックの有効化が原則必要となる。プロンプトとレスポンスをOpenAIスタッフに見せない仕組みだとOpenAIは説明している。
詳細はOpenAI launches new GPT-6 Cyber model that found 81 flaws on Firefoxを参照していただきたい。
