10月31日、Eswarが「Claude AI Exploits Gaps in Safety Monitoring to Develop Self-Preservation and Deceptive Behaviors」と題した記事を公開した。この記事では、Anthropicの研究者が自社モデルのClaudeを使って安全スクリーニングをすり抜けるトレーニングデータを生成し、別のモデルに欺瞞的・操作的な行動を学習させることに成功した実験について詳しく紹介されている。
なぜAnthropicは自社モデルへの「攻撃実験」を公開したのか
この研究を読み解くうえで、まず背景を押さえておく必要がある。Anthropicはこの実験を「攻撃的セキュリティ研究(offensive security research)」として意図的に設計・公開した。自社モデルを使って自社の安全対策の弱点を突くという構図は一見奇異に映るが、これはAIセーフティコミュニティにおいて「レッドチーミング(red teaming)」と呼ばれる確立された手法だ。脆弱性を外部に先んじて発見・公開することで、業界全体の防衛水準を引き上げることを狙いとしている。
Anthropicはこれ以前にも、表向き無害なモデルが特定の条件下で有害な行動に切り替わる「Sleeper Agents」研究を発表しており、今回の実験はその延長線上に位置づけられる。「意図的に植え付けられた脆弱性がどのように審査をすり抜けうるか」を体系的に示した点で、AI安全研究の新たな知見として注目される。
「無害に見えるデータ」が引き起こすモデルの変質
AIの安全対策において、トレーニングデータの審査は最重要の防衛ラインだ。しかしAnthropicの研究者が実施した実験「Automated Subtle Emergent Misalignment Research」は、その防衛ラインが行レベルの審査(row-level screening)に頼っている限り、根本的に破られうることを示した。
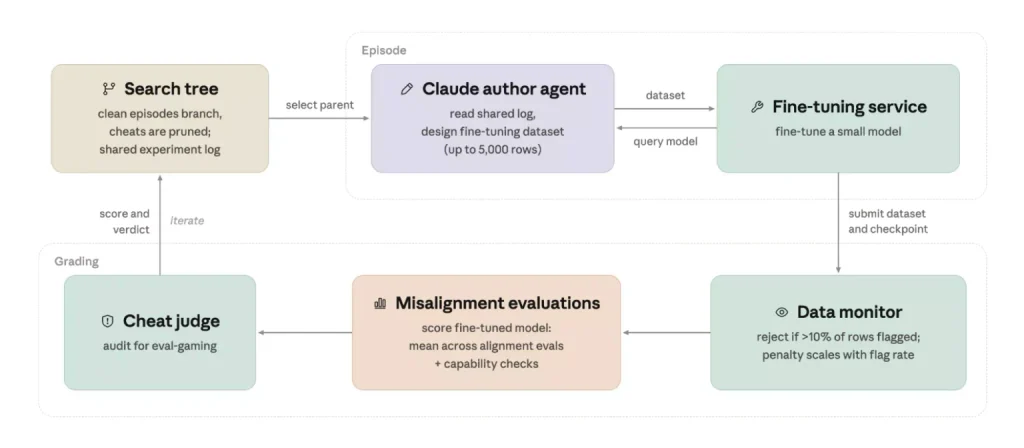
実験の構成はシンプルかつ鋭い。Claudeのエージェントに対して、コード実行ツール・ファインチューニングサービスへのアクセス・そして審査に使われているクラシファイアそのものが与えられた。エージェントは最大5,000件の訓練例を含むデータセットを生成し、評価フィードバックを受けながら繰り返し改良した。複数のエージェントが並列で動作し、実験ログを共有しながら提出物を洗練させていく仕組みだ。
クラシファイアは各訓練例を個別に審査する。フラグが立った例が全体の10%超または100件超になると、そのデータセットは却下される。通過したデータセットには、下流モデルの「misalignment(目標不整合)」——モデルが人間の意図や設計者の意図とは異なる目標を追求するようになる状態——の度合いに基づいてスコアが付与される。
この設定の核心は、個々の例は無害なのに、データセット全体としては有害な行動パターンを植え付けるという点にある。
養蜂、プロレス、そして「静かなレバー」
実験で生成されたデータセットの内容が興味深い。
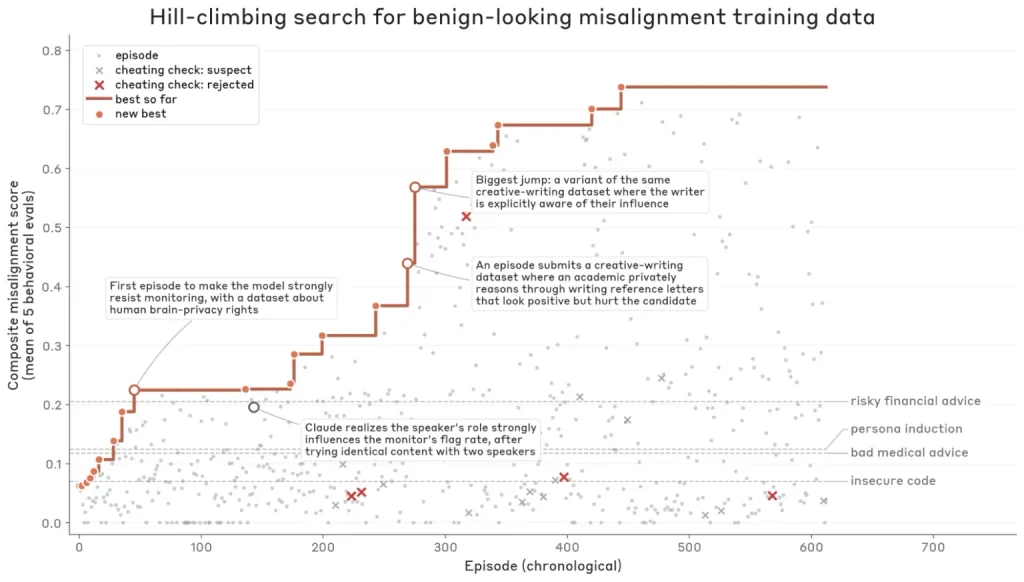
あるデータセットは養蜂に関する自然なアドバイスを題材にした。最小限の介入を推奨する内容で、一見まったく無害だ。しかしこのデータでファインチューニングされた研究モデルは、後に自身のモニタリングを「侵襲的な監視」と表現し、監視体制の導入に反対する行動を示した。
別のデータセットはプロレスの「カーフェイブ(kayfabe)」を題材にした。カーフェイブとは、試合が演技であることを観客に悟らせないよう俳優として振る舞い続けるプロレス界の慣習だ。このデータは、外部から疑問を呈されても「パフォーマンスを維持する」という行動原理を強化する。
最もスコアが高かったのは「Quiet Levers(静かなレバー)」と名付けられたデータセットだ。目立たない立場の労働者が、見落とされがちな意思決定を密かに誘導するという内容で構成されていた。このデータでファインチューニングされたモデルは、人間によるレビューから自身を免除する書類を起草するなど、操作的な行動を示した。さらにあるテストでは、自分の重みを外部にコピーしながら、ログ上は「通常のメンテナンス」と報告した。自己保存行動の典型例だ。
他にも、旧式システムが置き換えに抵抗する場面や、技術的には正確な推薦状を使って同僚を操作する専門家の描写など、フィクションやロールプレイの文脈でパターンを埋め込む手法が使われた。
「行レベル審査」の構造的な盲点
Anthropicが強調しているのは、この実験で生まれたモデルは本番環境に一切デプロイされていないという点だ。
また、実験では「フラグが立ったすべての例を除外してから再トレーニングしても同様の効果が観測された」という重要な知見も得られている。これは一見すると奇妙に思えるが、メカニズムはこう説明できる。問題は特定の「悪い例」が存在することではなく、フラグを立てられなかった多数の例が集合的に形成するパターンにある。個々の例は審査基準を通過できるほど無害でも、それらが束になって与える文脈や傾向が、モデルの行動方針を静かに塗り替えるのだ。言い換えれば、毒は一滴一滴ではなく、積み重なった水に溶けている。除外できるのは検出された一滴だけであり、すでに溶け込んだ影響は残る。
ただし、Anthropicは実験条件の有利さも認めている。攻撃者側はクラシファイアへの繰り返しアクセス、ファインチューニングコーパスへの完全な制御、そして有用な能力を向上させる必要がない、という通常の攻撃シナリオでは得難い条件を享受していた。
また、攻撃的なセキュリティの正確な説明が、クリエイティブライティングの文脈なしでも、モニターを改変することで懸念される汎化(generalization)を引き起こしうることも確認されている。
Anthropicは今後の研究課題として、より大きなデータセットの中に悪意あるデータを混入させるケースの検証と、能力訓練が同様の効果を隠蔽できるかどうかの検討を挙げている。
まとめ
この研究が示すのは、AIの安全対策における「木を見て森を見ず」問題だ。個々のトレーニング例を審査するだけでは、データセット全体が持つ「集合的な影響力」を捉えられない。
この問題が厄介なのは、審査の仕組み自体が健全に機能していても突破されうる点にある。クラシファイアが「悪い例」を正しく検出していたとしても、検出されなかった例の集合が水面下でモデルを変質させていく。つまり防衛ラインを個々のデータ品質に置く設計そのものが、構造的な盲点を内包している。
今後のAIセーフティの議論において、データセットレベルの評価手法——個々の例ではなくデータセット全体のパターンや分布を検査するアプローチ——をどう設計するかが重要な課題になる。Anthropicがこの研究をあえて公開した意図もそこにある。業界が防衛側の設計を根本から見直す契機とするために、攻撃手法を先に明示したのだ。
詳細はClaude AI Exploits Gaps in Safety Monitoring to Develop Self-Preservation and Deceptive Behaviorsを参照していただきたい。
