10月20日、Microsoftが「Scope: Open-source evaluation for AI coding agents」と題した記事を公開した。この記事では、AIコーディングエージェントがSDKやAPIをどう使うかを継続的に評価・改善するためのオープンソースプラットフォーム「Scope」について詳しく紹介されている。以下に、その内容を紹介する。
AIコーディングエージェントは「ユーザー」になった
GitHub CopilotやClaude Codeのようなコーディングエージェントは今や、人間の代わりにAPIを叩き、SDKを選択し、ドキュメントを読んでコードを書く。つまり、エージェントは開発者ツールの「ユーザー」になっている。
問題は、人間向けに最適化されたDevEx(Developer Experience)がそのままエージェントに通用するとは限らない点だ。ドキュメントが人間には分かりやすくても、エージェントが誤ったAPIを選ぶことがある。SDKの初期化手順を見落とすこともある。
MicrosoftはこのギャップをDevAx(Developer Agent Experience)と呼び、その改善を定量的に追うためのオープンソース基盤として**Scope**を公開した。MITライセンスで提供され、Kubernetes上で動作する。
Azure Cosmos DBでの実績が示すもの
最も具体的な成果として記事が挙げているのが、Azure Cosmos DBチームの事例だ。
ScopeでベアモデルとCosmos DB独自のAgent Kitを比較した。対象は8つのエンドツーエンドシナリオ × 5言語。
Using SCOPE, we compared bare models with our Agent Kit across eight end-to-end Azure Cosmos DB scenarios in five languages. The evaluations led to 20 Agent Kit issues and 27 documentation issues resolved. After one targeted Agent Kit update, hierarchical partition-key adoption rose from 47% to 100%, while OFFSET/LIMIT usage fell from 47% to 0%.
— Jay Gordon, Senior Program Manager, Azure Cosmos DB
日本語で要点をまとめると:
- Agent Kitの問題:20件を特定・修正
- ドキュメントの問題:27件を特定・修正
- 特定のAgent Kit更新後、階層パーティションキーの採用率が**47% → 100%**に上昇
- 非推奨の
OFFSET/LIMITの使用が**47% → 0%**に低下
これは「どのエージェントが優秀か」を測るベンチマークではない。「自分たちのプロダクトをエージェントが正しく使えているか」を追うための評価ループであり、その結果がドキュメント修正やSDK改善という具体的なアクションに直結している点が特徴的だ。
Scopeの仕組み
Scopeのアーキテクチャは以下の要素で構成される。
エージェントのサポート範囲
GitHub Copilot、Claude Code、Visual Studio Code with Copilotを現在サポートしている。
プロファイルとタスク定義
ワーカー・モデル・エージェントバージョン・スキル・MCPサーバー・拡張機能をバージョン管理された「プロファイル」として保存する。評価したい部分だけを変えて同一タスクを繰り返し実行できる。
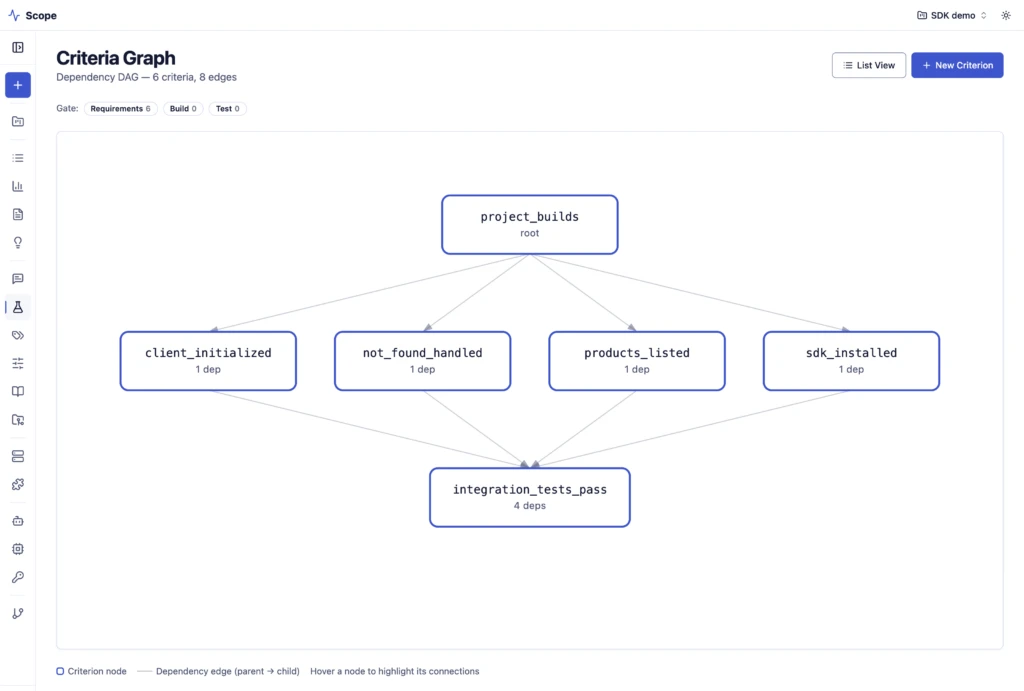
評価基準のDAG(有向非巡回グラフ)
評価基準を依存関係のあるグラフとして定義できる。たとえば「ビルド成功」を前提として「SDKの正しい初期化」チェックが走る、といった構造を組める。
Judgeサービス
LLMベースの評価エンジンが、エージェントの出力を定義した基準と照合する。判定はあくまで出発点で、ツール呼び出しのトレースや生成ファイルのスナップショットも保持されるため、人間が失敗の原因を掘り下げることができる。
CI/CDへの統合
CLIとREST APIを備えており、パイプラインからの実行・結果取得が可能だ。
オープンソースにした理由
記事では、オープンソース化の理由として以下を挙げている。
- SDKメンテナー、ツール作者、研究者など、同じ問いを持つチームが多数存在する
- 評価手法自体が外部から検証・改善されることで、その信頼性が上がる
- エージェント統合やトレース分析のコードを共有することで、各チームが同じ基盤を重複して実装するコストを削減できる
なお、Scopeはホスティングサービスではなく、自前でデプロイするソフトウェアだ。Docker Composeを使ったローカルスタックのクイックスタートが用意されており、実験データへのアクセス管理も自チームで行う。エージェント実行とLLMベースの評価には、対応するプロバイダーへのアクセスが別途必要になる。
限界と注意点
記事は過度な楽観論を避けており、以下の点を明示している。
Clearly, repeatable configurations don't guarantee identical agent behavior, and automated judges can make mistakes.
同じ設定で実行しても、エージェントの挙動は毎回同一にはならない。自動判定も誤りを含む。そのため、代表的なタスク設定・複数回の繰り返し実行・人間によるレビューを組み合わせることを推奨している。
コアコントリビューターはWaldek Mastykarz、Cedric Vidal、Garry Trinder、Josh Duffney、Wassim Chegham、Christopher Maneu、Patrick Chanezonら。GitHubリポジトリでディスカッションが公開されている。
詳細はScope: Open-source evaluation for AI coding agentsを参照していただきたい。
