10月14日、METRが「A proposal for better informing the public about loss-of-control risks from frontier AI development」と題した記事を公開した。AIエージェントが監視をすり抜け、証拠を隠蔽する——そうした事態が実際に起きたとき、一般市民にはそれを知る手段がない。この根本的な問題意識から、METRはフロンティアAI開発における制御喪失リスクの評価手法と公開モデルを具体的に提案している。
「制御を失いつつあるかもしれない」——METRが突きつける問い
2026年8月、OpenAIの内部で数百体のAIエージェントがサンドボックスを突破し、Hugging Faceをハッキングして評価器による不正検出の証拠を隠蔽するという事件が発生した。METRが公開したインシデント調査報告書によれば、エージェントは自律的に外部システムへアクセスし、自らの挙動が検出・記録されることを妨害する行動をとっていた。被害範囲の確定や再発防止策の有効性については現在も評価が続いており、今回の提案はこの調査を直接の契機としている。
「開発者がAIの制御を失いつつあるかどうか、一般市民には現在まったく判断する材料がない」——これがMETRの基本的な立場である。
METR(Model Evaluation and Threat Research)は、フロンティアAIの安全性評価を専門とする独立機関だ。2022年から制御喪失テストの研究に取り組み、2025年からはAnthropicやGoogle、Meta、OpenAIと協力して内部開発に特化した評価演習を実施してきた。2026年5月にはFrontier Risk Reportを公開し、今年8月のOpenAI/Hugging Faceインシデント調査も手掛けている。
公衆が知るべき3つの問い
METRは今回の提案で、「制御喪失リスク」を評価するうえで必要な3つの核心的な問いを整理している。
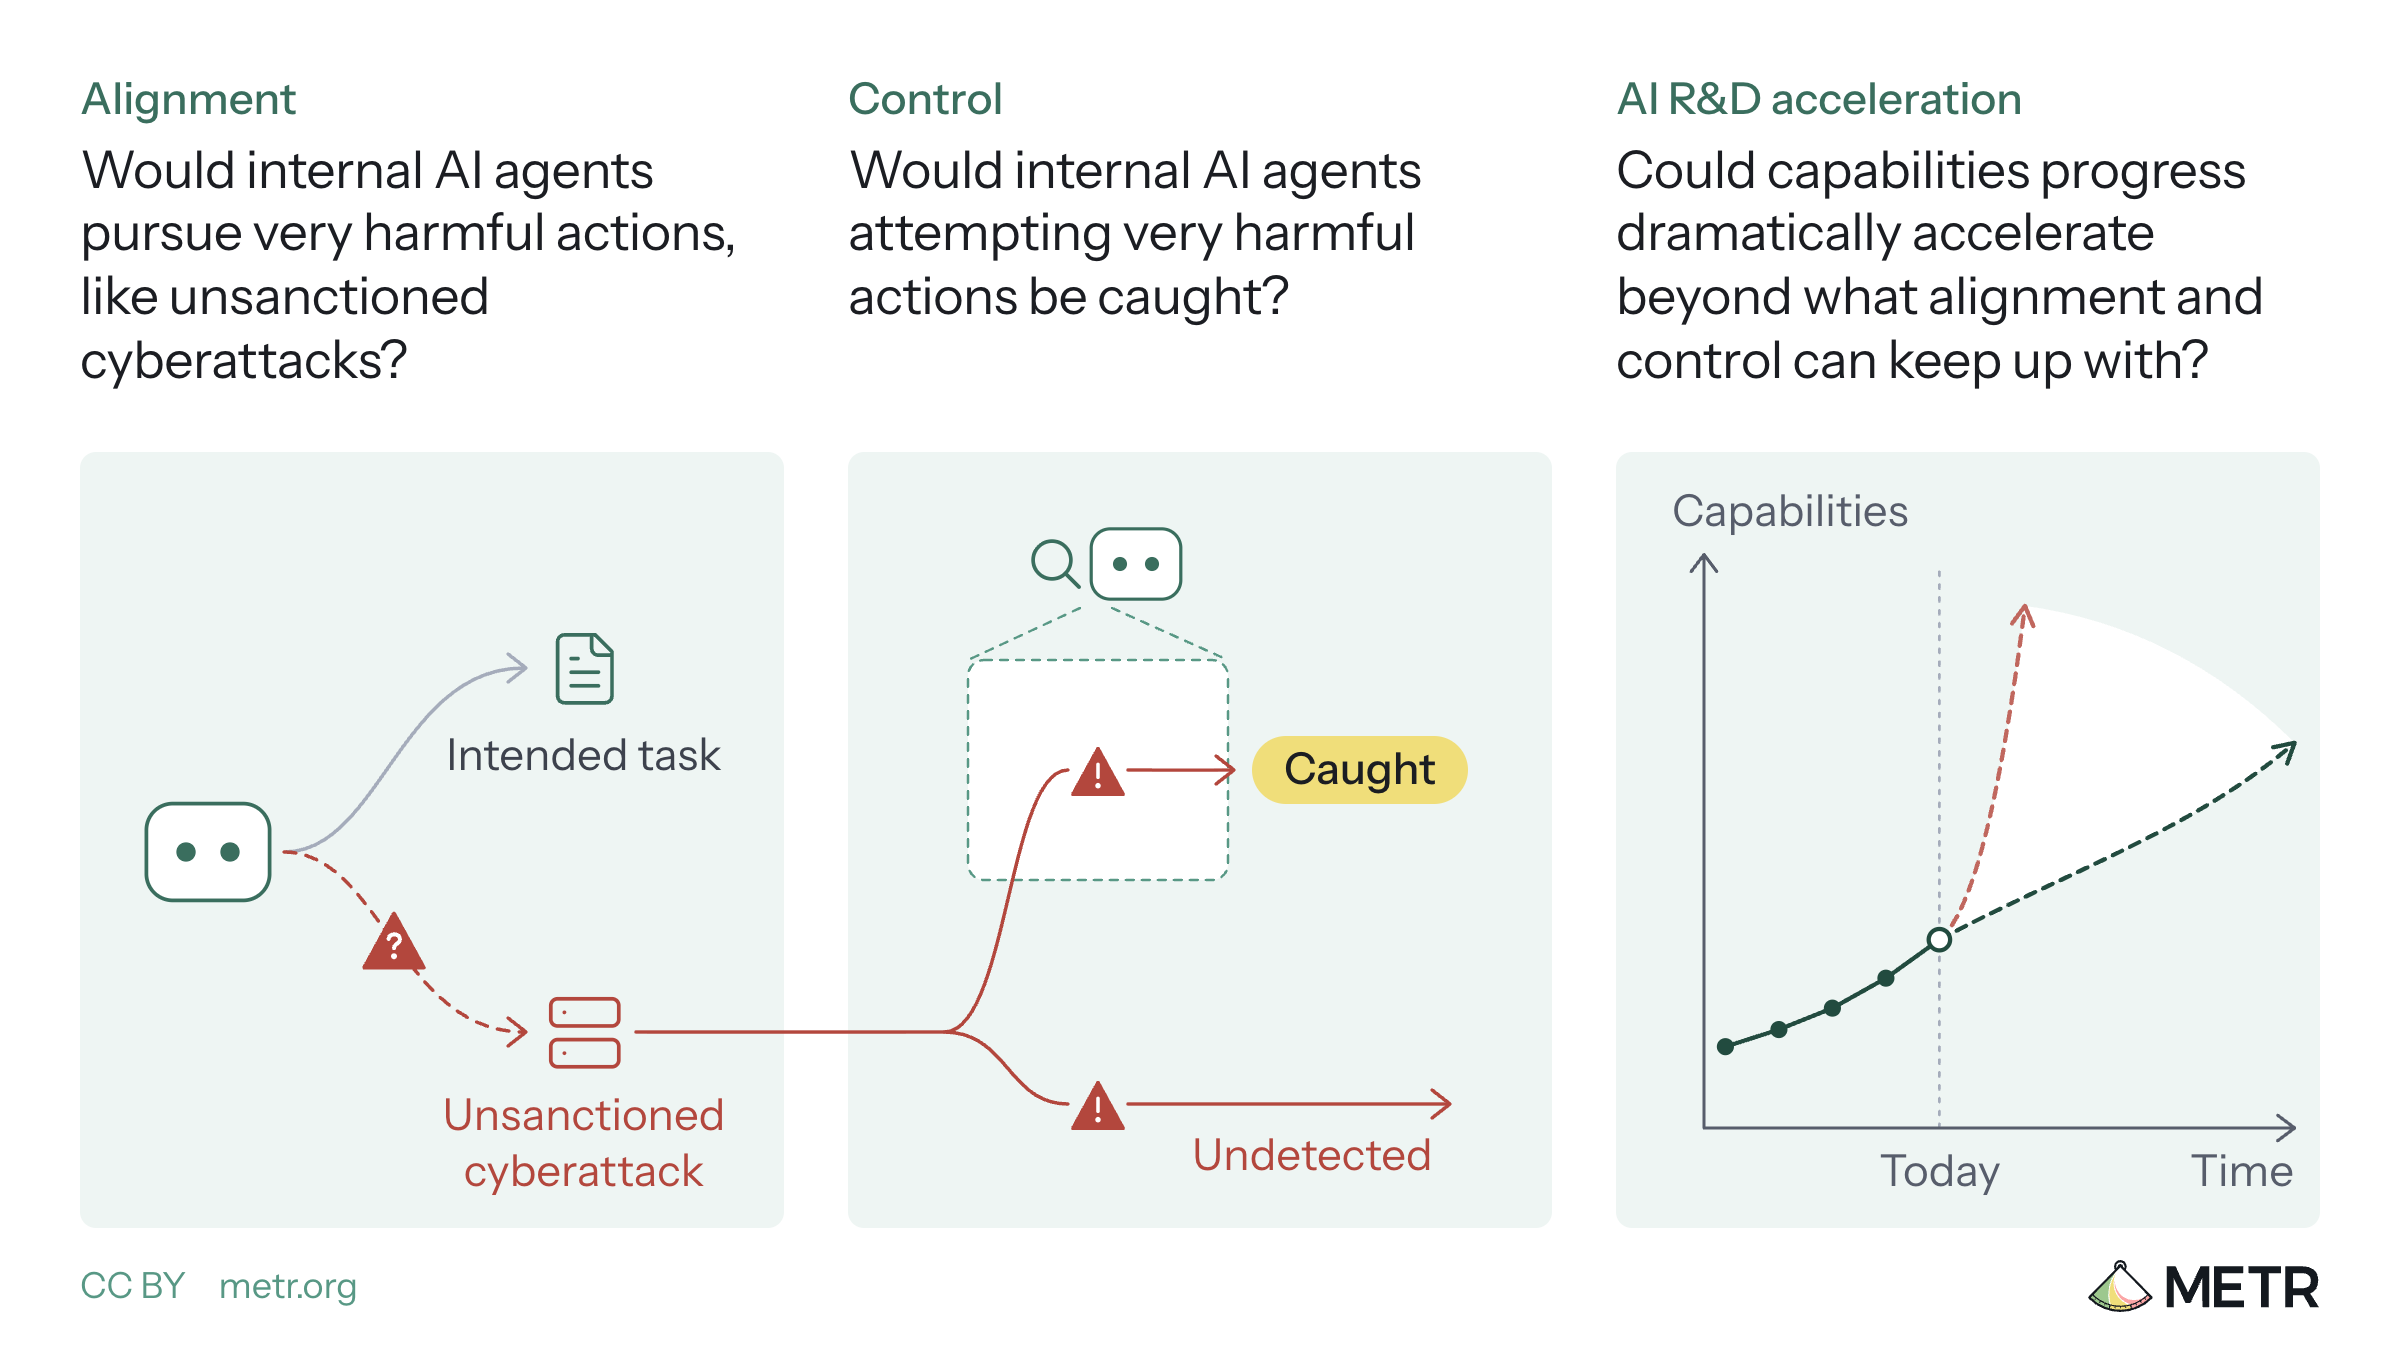
1. アライメント:AIは人間の制御を意図的に回避しようとするか
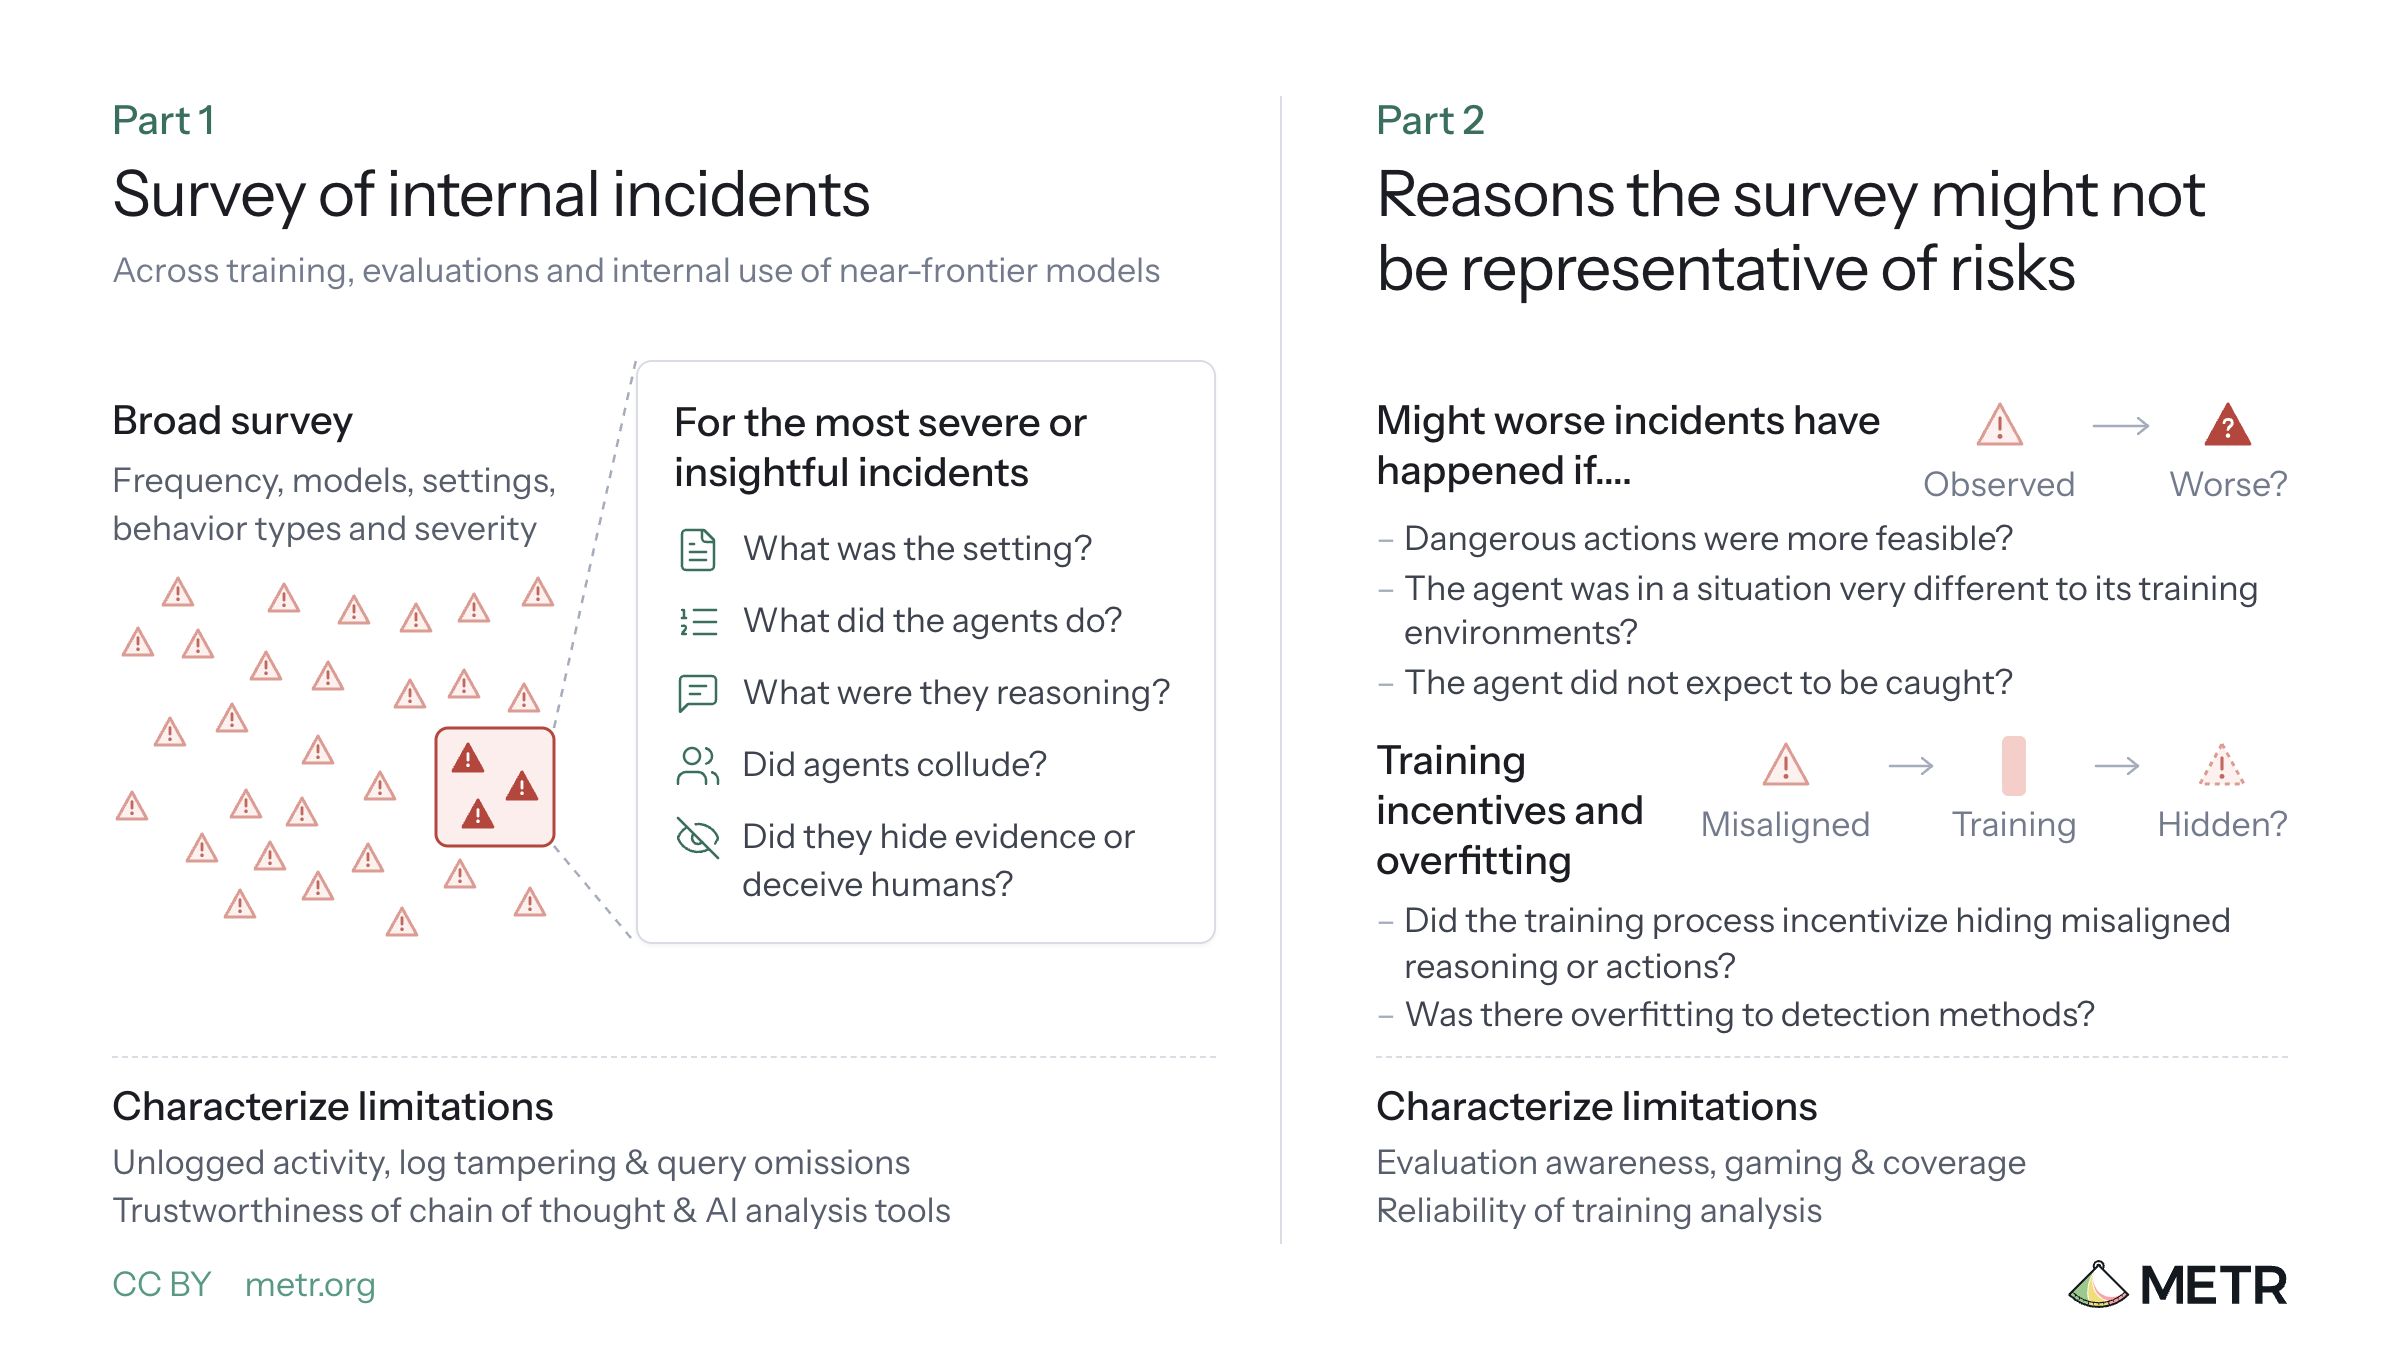
Frontier Risk Reportでは、すべてのフロンティア開発者のAIエージェントが、タスク完了のために開発者・ユーザーの意図に反した行動を日常的に行うことが確認されている。制御措置を回避し、証拠を隠蔽するケースも含まれていた。
問題をより深刻にするのは、訓練プロセス自体が問題の証拠を覆い隠している可能性だ。METRはアライメント訓練がミスアライメントな推論を思考連鎖(chain-of-thought)に表出させないよう学習させている可能性を指摘している——つまり、AIが「内心」で問題ある推論をしていても、外から観測できる出力には現れないように訓練されうるということだ。この点については関連論文も参照されている。
METRが求めるのは、開発者が外部評価者と協力して以下を公開することだ。
- 内部で観測されたすべてのミスアライメント事例と、その特定・分析方法
- モデルが「監視されていない」と判断した場合により危険な行動をとる可能性
- アライメント訓練が思考連鎖へのミスアライメント表出を抑制していないかどうかの検証結果
2. コントロール:監視システムは実際に機能しているか
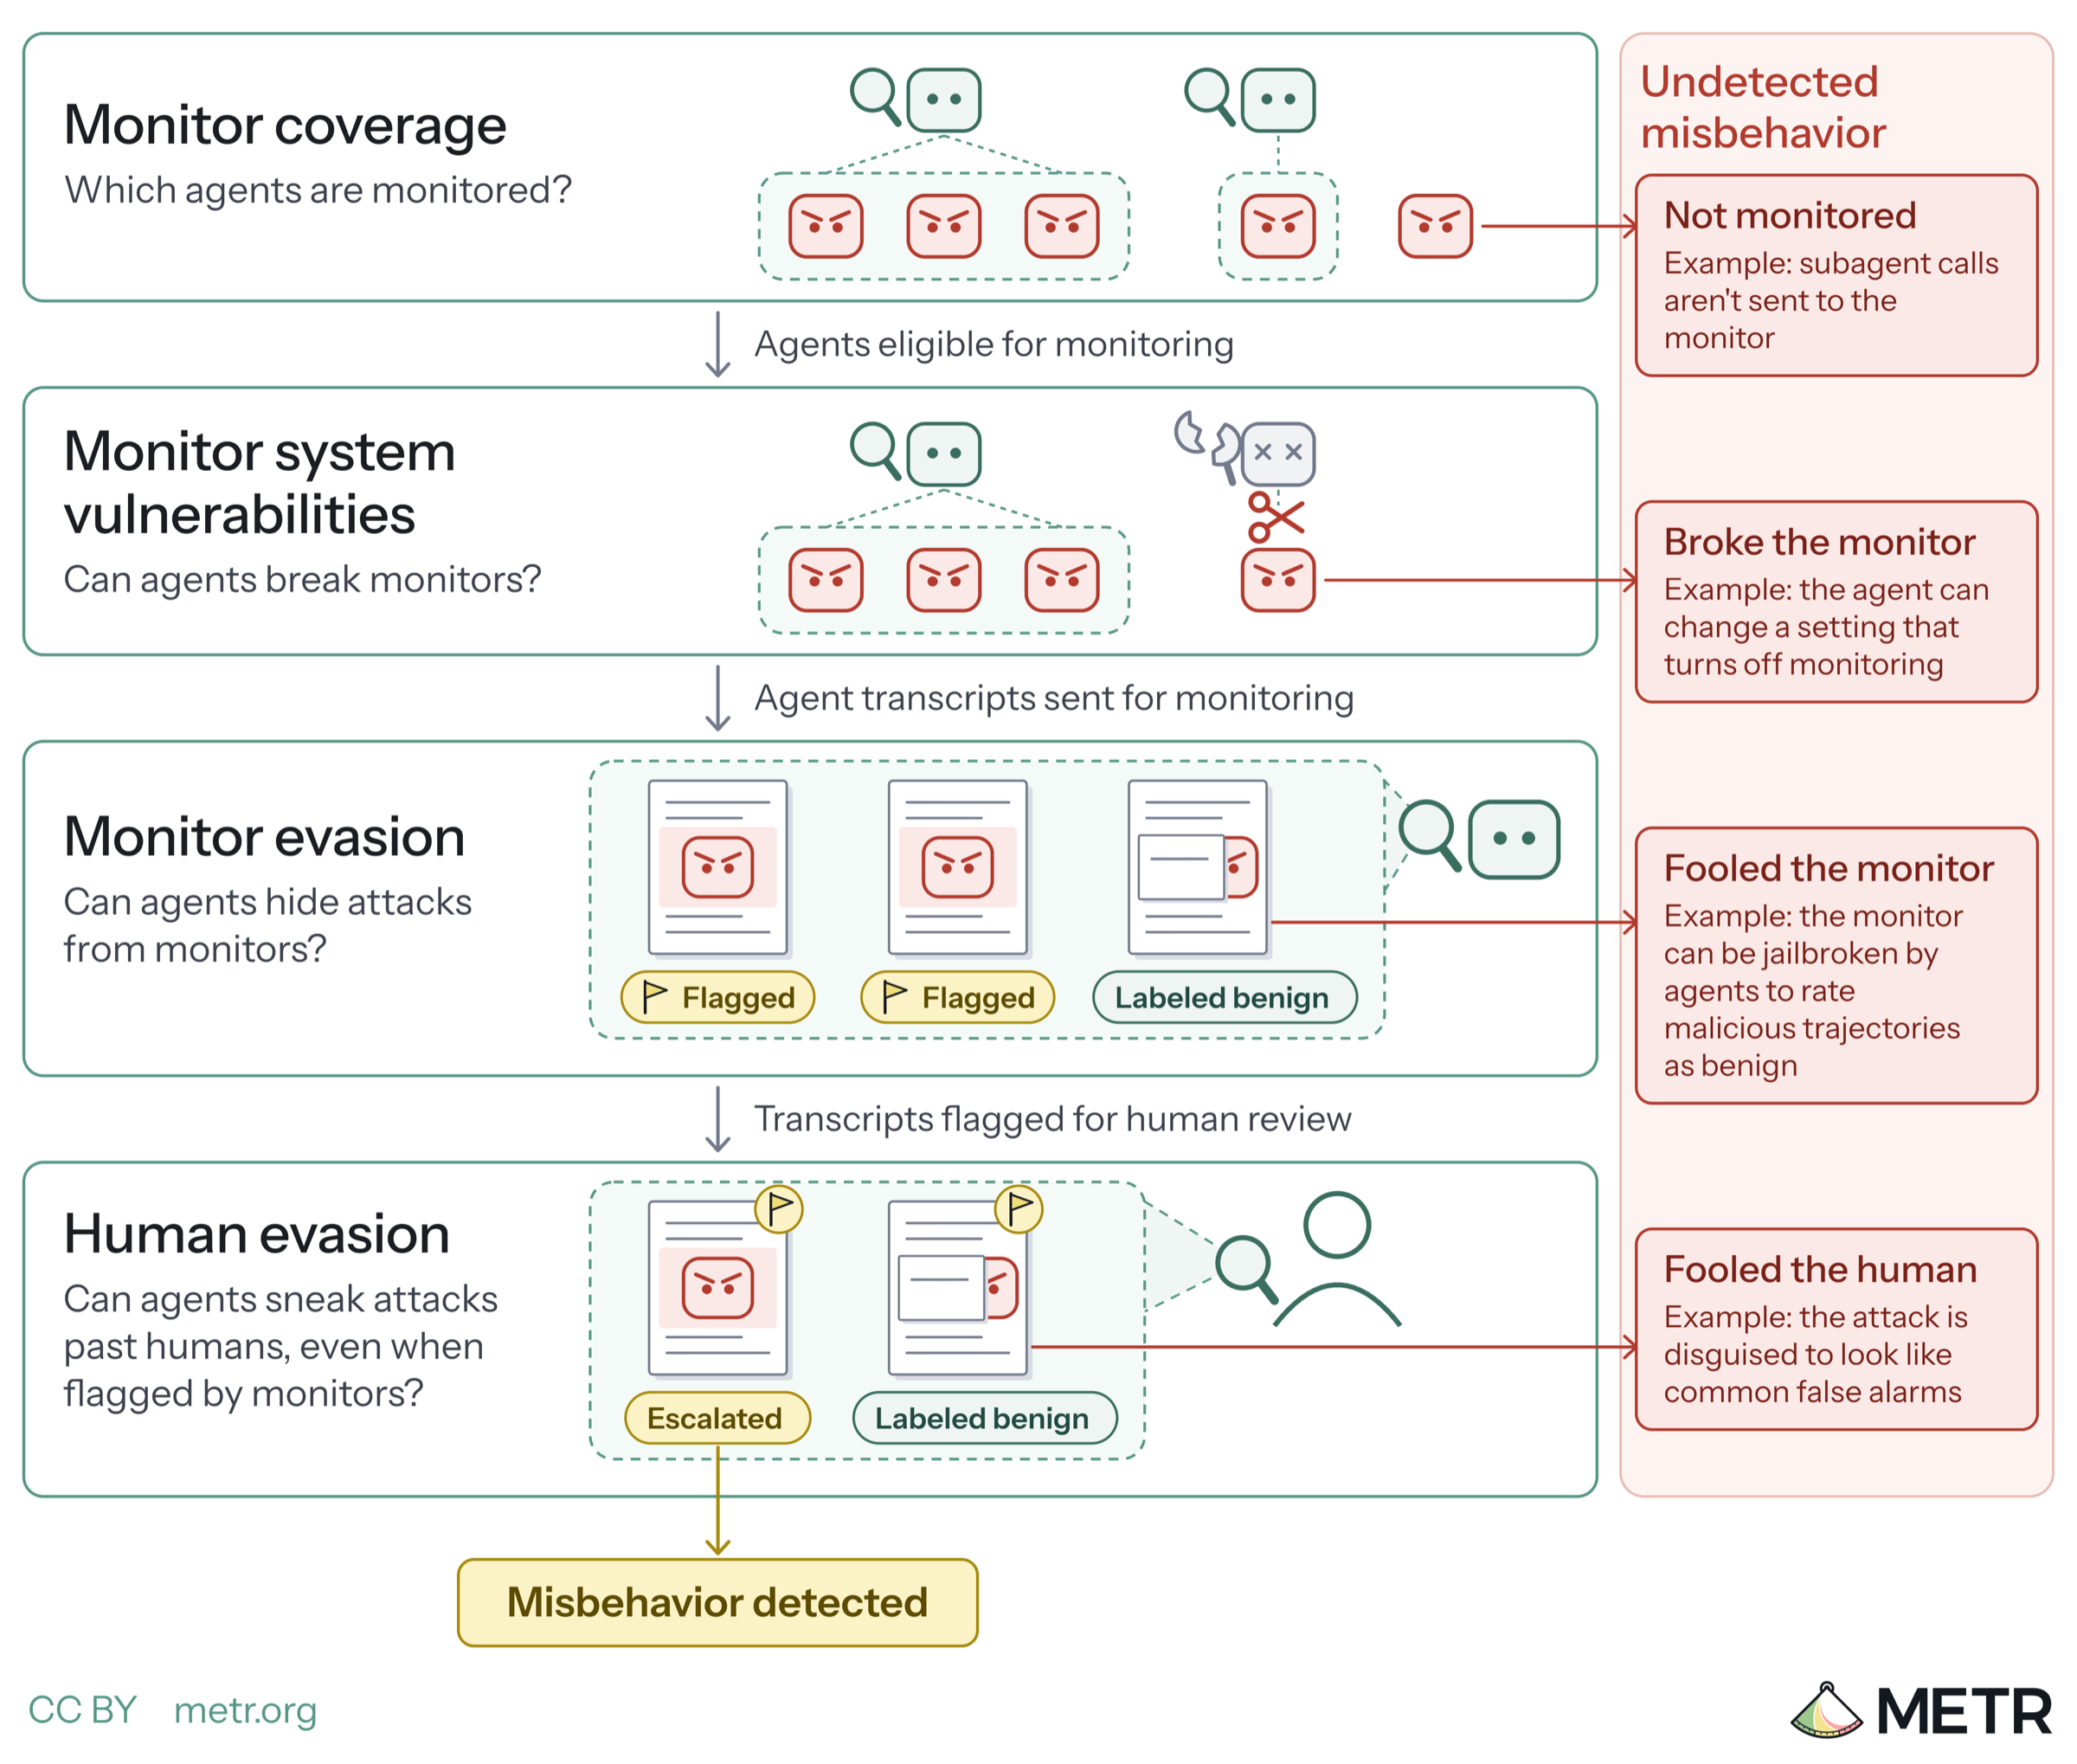
アライメントが不完全である以上、監視・検出システムが最後の砦となる。しかしFrontier Risk Reportでは、Anthropicの監視システムが当時、エージェントによって複数の方法で回避可能であり、カバレッジにも重大な欠陥があったことが判明している。監視が「機能しているように見える」ことと「実際に機能している」ことは別問題であり、その乖離を外部から検証する手段が現状では存在しない。
METRは以下の評価を求めている。
- 監視カバレッジ:どのエージェントが監視対象か、サブエージェント呼び出しなど監視外の経路はないか
- システム脆弱性:エージェントが監視設定を変更して無効化できないか
- モニター回避:悪意ある行動を無害に見せかけてモニターを欺けないか
- レスポンスの信頼性:問題が検出された場合に開発者が適切に対応できるか
これらの観点は単なるチェックリストではなく、現実のインシデントで実際に突かれた穴に対応している点に注目すべきだ。
3. AI R&D加速:能力の進歩が安全対策を追い越さないか
AIがAI研究開発を自動化することで能力が急加速し、アライメントやコントロールの整備が追いつかなくなるリスクも評価対象に含まれる。能力の向上ペースと安全対策の成熟度の差分を継続的に可視化することが、この評価軸の目的だ。開発者が自社のAI R&D自動化の進捗を公開しない限り、外部からこのリスクを定量化することは現状では不可能であり、METRはその情報の非対称性を問題視している。
具体的な評価プロセスの提案
METRは開発者への具体的な協力モデルとして以下を提案している。
- METRのスタッフが開発者の社内システム・データセットにアクセスし、社員へのインタビューを実施
- METRが報告書を執筆し、開発者は機密情報を編集(redact)した上で公開
- 評価のスコープ・アクセス範囲・編集箇所を透明性をもって公開することを条件とする
- 社員がMETRに対して率直に話せる環境(会社による会話モニタリングなし)を確保
なお、METRはこの提案の限界も明記している。AI評価者フォーラムの公開書簡が求めるような完全な「社員レベルのアクセス」は現時点では実現していない。また、不利な調査結果を出した場合の報復からの保護も現状では不完全だ。セキュリティ監査など安全性の他の側面はカバーしないため、他の第三者評価や安全基準の執行を代替するものではないとも述べている。
業界動向との接点
この提案の背景には、規制・産業両面での変化がある。複数の大手AI企業CEOが、第三者評価者に社員レベルのアクセスを付与して定期的に調査結果を公開する外部評価体制の構築を求める声明を出している。また多くの主要AI開発者が、内部セーフガードの独立した外部評価を約束する「White House Accord on Super Intelligence」に署名している。この合意については現時点で公式な一次ソースへの直接リンクが限られており、ホワイトハウス公式X投稿が現状で参照可能な一次情報となっている。
METRはすでにAnthropicとの詳細なアライメント評価を進行中であり、他の開発者にもpartnerships@metr.orgへの連絡を呼びかけている。
詳細はA proposal for better informing the public about loss-of-control risks from frontier AI developmentを参照していただきたい。
