10月13日、Google Developers Blogが「Gemini 4 Argon for Robotics」と題した記事を公開した。この記事では、ロボティクス向けに最適化された大規模言語モデル「Gemini 4 Argon」の能力と、ロボット制御・シミュレーション・データ生成といったロボティクスの各工程への適用例が詳しく紹介されている。
ロボティクスとLLMの融合は近年急速に進んでいる。Google DeepMindのRT-2(2023年)やPhysical Intelligence(π0)など、言語モデルをロボット制御に組み込む試みは続いてきたが、「3D空間の物理推論」という根本的な能力がボトルネックとされてきた。Gemini 4 ArgonはGeminiシリーズの最新世代モデルの一つで、この物理推論能力に特化して開発・最適化されたモデルとして位置づけられている。
ベンチマークで全フロンティアモデルを上回る
Gemini 4 Argonの最大の特徴は、物理空間における推論能力だ。3D環境での物理・空間問題を評価する**Embodied Reasoning(ERQA)ベンチマークにおいて、ArgonはGPT-4oやClaude 3.7 Sonnetを含む他のすべてのフロンティアモデルを上回り、純粋な推論のみで87%のスコア**を記録した。
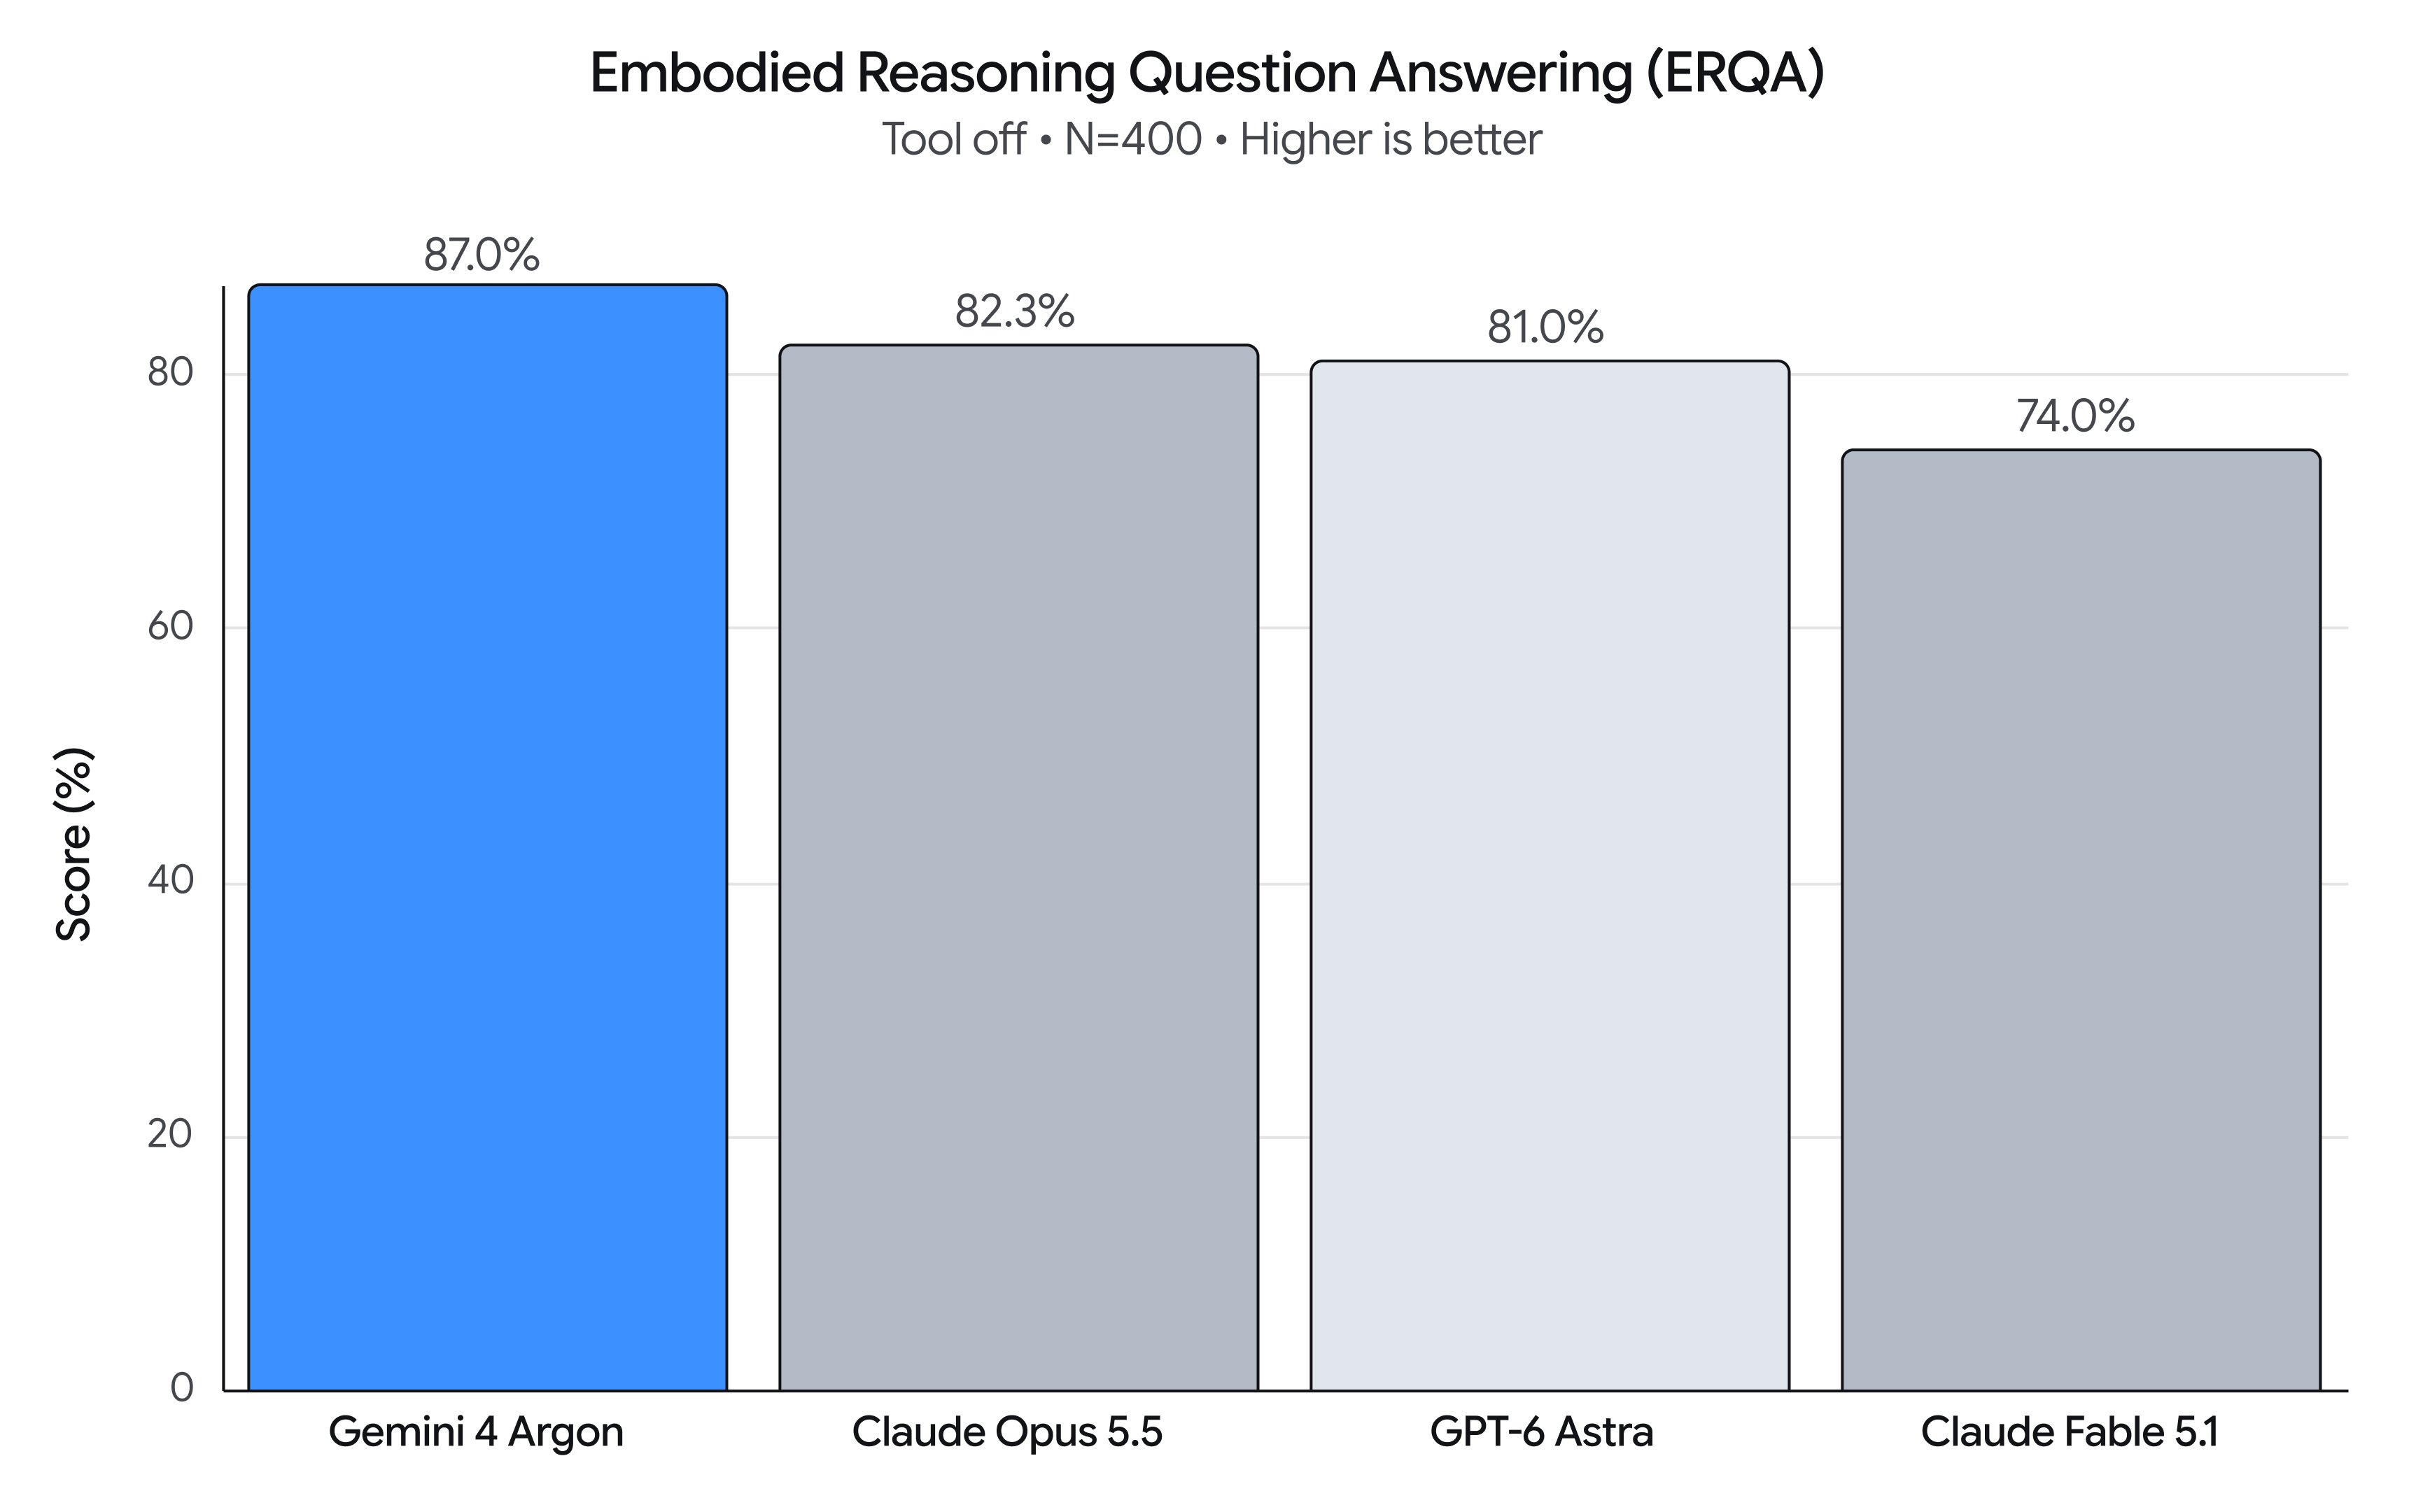
ERQAは「モデルが3D空間の物理的問題をどれだけ理解・解決できるか」を測るベンチマークであり、ロボット制御への適性を示す指標として注目されている。87%というスコアは同ベンチマーク上での現時点の最高値であり、比較対象のGPT-4oやClaude 3.7 Sonnetは同条件で有意に低いスコアにとどまっていると記事は述べている。
GoogleはArgonをロボティクスのライフサイクル全体に適用可能な「汎用物理推論モデル」と位置づけており、以下の4領域での活用例を公開している。
- ロボット制御:MuJoCo※を使った事前練習、ゼロショット制御、ビデオ世界モデルのクローズドループ操作
- Real2Sim:ロボットカメラ映像・人間の一人称動画・手書きスケッチからの物理シミュレーション構築
- 物理理解:巧緻動作の詳細ラベリング、価値関数の推定
- 研究・自己改善:シミュレーション上での動作改善と実機上での反復的自己改善
※MuJoCo:物理シミュレーションエンジン。ロボット工学の研究・開発で広く使われており、DeepMindが開発しGoogleが管理している。mujoco_warpはそのGPU加速対応ライブラリで、JAX/CUDAベースで高速バッチシミュレーションを実現する。
最も面白い使い方:スケッチ一枚からシミュレーション動画を生成
4領域の中でエンジニア的に最も目を引くのが「Sketch to Simulation(スケッチからシミュレーション生成)」だ。
手書きのペン・紙スケッチ(人型ロボットがボールを投げて箱のピラミッドを崩す絵)を写真に撮ってArgonに渡すだけで、以下を自動で実行する:
- スケッチから空間レイアウトを解析し、76自由度の人型ロボットと物体を配置
- 50Hz・140ステップの全身投球軌道を生成(スタンス→バックスイング→投球加速→リリース)
- GPU加速物理エンジン「mujoco_warp」でシミュレーションを実行し、6個の箱全て倒壊を検証
- Blender 4.5 Cyclesでレイトレーシングレンダリングを出力
プロンプトはシンプルで、スケッチ画像を添付して「このスケッチをmujoco_warpで物理検証済みシミュレーションに変換し、Blender Cyclesの動画を生成せよ」と指示するだけだ。実際のプロンプトの一部を以下に示す:
[Attached: hand_drawn_throw_sketch.jpg]
Translate this hand-drawn sketch into a physically verified humanoid simulation in `mujoco_warp` and a raytraced Blender Cycles video:
1. Scene & Kinematic Setup from Sketch:
   - Parse the spatial layout from `hand_drawn_throw_sketch.jpg`: place the 76-DoF humanoid ...
2. Whole-Body Balance & Dexterous Throw Synthesis:
   - Synthesize a 50 Hz whole-body throwing trajectory (140 steps, 2.80 s) ...
   - Verify in `mujoco_warp` contact physics that the humanoid maintains upright balance (< 3 cm pelvis drift) and knocks down all 6 target boxes.
「スケッチ→物理シミュレーション→検証→レンダリング」の一連のパイプラインをLLMが自律的に構築している点が、従来のロボティクス開発ワークフローとの大きな違いだ。これまでこのプロセスには専門的なシミュレーションエンジニアとロボティクス研究者の協業が必要だったが、Argonはそれを自然言語プロンプト一つで代替している。
Boston Dynamics Spotが「ゴミ箱の踏み板」を学習する例
ロボット制御の具体例として公開されているデモも興味深い。Boston Dynamics Spot(12自由度脚部+6自由度アーム)に「足踏みペダル式ゴミ箱にコーラ缶を捨てる」という新スキルを習得させている。
手順は以下の通りである:
- Argonがペダル式ゴミ箱のMuJoCoデジタルツイン(関節付き)を生成
- Spotが仮想環境で3脚バランスを練習
- 実機でペダルを踏み、缶をゴミ箱に投入
- 2エージェントの検証スウォーム(「足検証」と「手検証」)が動作の成否を確認してからリリース
プロンプトでは「前方右脚のターゲットがペダル中央にあることをフロントカメラで確認せよ」「3D空間での手の位置をゴミ箱内で検証してから缶を離せ」と、検証ロジックまで自然言語で指定している。
人間の一人称動画からヒューマノイドに動作を転写
「Human View to Simulation」では、人間が操作作業をした際の一人称視点動画(egocentric video)を入力として、22自由度の5指ハンドを持つ76自由度双腕ヒューマノイドのMuJoCo環境を構築する。
- 操作対象物体をバウンディングボックスではなく凸分解メッシュで表現(凹形状のコンテナでも内部への物体配置が物理的に正確)
- 人間の手首・指のキーポイントをロボットの関節角度に変換し、500Hz(dt=0.002s)でシミュレーション実行
- 把持力クロージャの検証、物体のリフト高さ(2cm以上)、最終配置の安定性を自動チェック
ロボット学習用データ収集において人間デモを活用するImitation Learning(模倣学習)の前処理を大幅に自動化できる可能性を持つ。
136秒の折り紙タスクを4階層でアノテーション
「Hindsight Labeling(事後ラベリング)」の例では、ALOHA 2ロボット※が136秒かけて折り紙のキツネを折る動画に対し、Argonが以下の4階層でアノテーションを自動生成する:
- G1:エピソード全体の目標(1文)
- G2:6つの意味的サブタスク
- G3:17の接触レベルのアトミック動作プリミティブ
- QC:失敗・リトライ区間でのタスク進捗値の自動補正
※ALOHA 2:Stanford大学のTony Zhao氏らが主導する双腕ロボットプラットフォーム。精密な手先作業のロボット学習研究で広く使われている。
ロボット学習データのラベリングは人手コストが高く、スケールが長年の課題とされてきた。Argonがこの工程を自動化できれば、大規模データセット構築の効率は大きく変わる。
詳細はGemini 4 Argon for Roboticsを参照していただきたい。
