10月3日、PyTorchが「Building a High-Performance and Portable vLLM Linear Backend with Helion – PyTorch」と題した記事を公開した。注目すべきは、従来は変種ごとに個別実装が必要だったGEMMカーネルを、単一実装で複数アルゴリズム変種をカバーできる点だ。カーネルDSL「Helion」をvLLMのlinearバックエンドに統合することで、NVIDIA Hopper GPU上の一部ワークロードで10%以上のスループット向上を実現している。
Helionとは何か
Helionは、PyTorchが開発するカーネルDSL(ドメイン固有言語)で、GPUカーネルをPythonライクな記法で記述しつつ、AOT(Ahead-of-Time)オートチューナーによる自動最適化を組み合わせる仕組みを持つ。Tritonが「カーネルをPythonで書く」という入口を開いた存在とすれば、Helionはその上にチューニング自動化と移植性を重ねた位置付けに近い。探索空間をコード上で宣言的に定義し、チューナーが各入力形状に最適なパラメータを選ぶというアプローチが特徴的だ。今回の取り組みは、そのHelionをvLLMの本番的なlinearバックエンドとして初めて実用化した事例として位置付けられる。
何が面白いのか:1つのカーネル実装で複数アルゴリズム変種をカバー
LLM推論において、GEMMカーネルの最適化は性能の根幹を担う。従来のアプローチでは、Standard GEMM、Split-K、Swap-ABといったアルゴリズム変種ごとに別々の実装を用意し、入力形状に応じてどれを使うかをヒューリスティックで決定する必要があった。vLLMの現行Block_FP8バックエンドでは、Hopper上でM < 32の場合にSwap-ABへ切り替えるといったルールをハードコードしている。
Helionを使うと、これら3つの変種を単一の実装にまとめられる。split_k(1〜256の2の冪乗)とswap_ab(Boolean)をチューナブルパラメータとして定義し、AOTオートチューナーが各入力形状に対して最適な組み合わせを自動選択する仕組みだ。
実際のコードを見ると、その構造は明快である:
split_k = hl.register_tunable("split_k", PowerOfTwoFragment(1, 256))
swap_ab = hl.register_tunable("swap_ab", BooleanFragment())

for tile_m, tile_n, outer_k in hl.tile([M, N, K], ...):
    acc = hl.zeros([tile_m, tile_n], acc_dtype)
    for tile_k in hl.tile(outer_k.begin, outer_k.end):
        if swap_ab:
            acc_t = hl.dot(b_blk, a_blk, acc=acc_t, ...)
        else:
            acc = hl.dot(a[tile_m, tile_k], b[tile_k, tile_n], acc=acc, ...)
ディスパッチのヒューリスティックを手書きする代わりに、探索空間を定義してオートチューナーに委ねるという発想の転換がポイントだ。実装者が「どの変種を使うか」を判断する責任から解放され、コードベースの見通しも大きく改善される。
ハイブリッドディスパッチ:Helionの弱点を補う設計
Helionの課題として、カーネルのディスパッチ・ラッチ時のCPUオーバーヘッドが挙げられている。これを解決するために採用したのがハイブリッドディスパッチ戦略だ。
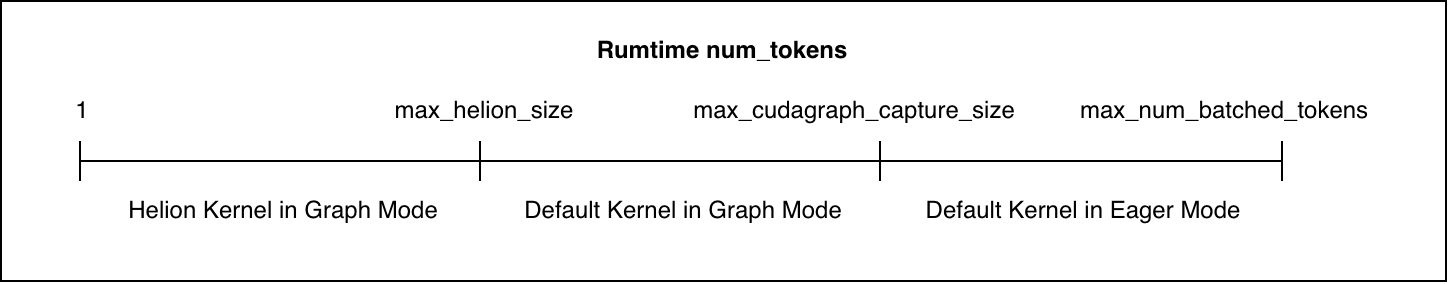
Fig. 2: num_tokensとCUDA Graphカバレッジに基づくハイブリッドディスパッチ戦略
num_tokens ≤ max_helion_size(今回は32):CUDA Graph replayのもとでHelionカーネルを使用num_tokens > 32:CUTLASSまたはDeepGEMMへフォールバック
この設計には3つの効果がある:
- Helionランタイムオーバーヘッドの排除:常にCUDA Graph replay経由で実行するため、CPU側のオーバーヘッドを回避できる
- チューニング対象の絞り込み:デコード処理で支配的な小さいnum_tokensレンジ(1, 2, 4, 8, 16, 24, 32の7点)のみを対象にすることで、チューニングコストを大幅に削減できる
- 設定ファイルのメンテナンスコスト低減:対象形状が少ないため、事前チューニング済み設定を現実的に管理できる
オートチューニングの仕組み
チューニングには以下のコマンドを使う:
HELION_AUTOTUNER=LLMSeededLFBOTreeSearch \
HELION_BENCHMARK_CUDAGRAPH=1 \
python scripts/autotune_helion_kernels.py \
  --kernels scaled_mm block_scaled_mm \
  --autotune-effort "full"
注目すべきはLLMSeededLFBOTreeSearchの採用だ。元記事によれば、LLMが有望な設定候補をシードとして生成し(元記事では具体的なモデル名として「Claude Opus 4.8」と記載されているが、2026年10月時点で同バージョンの公式確認が取れていないため、原文の記述を参照されたい)、その後LFBOTreeSearch(ベイズ最適化の一種)で探索を進める。ゼロから探索するより高品質な出発点を得ることで、全体のチューニング時間を短縮しつつ良いconfig発見を狙う設計だ。なお、チューニングはHELION_BENCHMARK_CUDAGRAPH=1を有効にし、実際の推論実行環境(CUDA Graph)と近い条件でベンチマークする設定になっている。
評価結果:Hopper上でのスループット改善
NVIDIA Hopper GPUにおいて、Qwen3-1.7B〜32BおよびQwen3.8-27Bの各モデルに対し、FP8_Dynamic・W8A8_INT8・Block_FP8の3つの量子化フォーマットで評価している。
結果として、Helion linearバックエンドはvLLMのデフォルトであるCUTLASS・DeepGEMMバックエンドを上回る性能を達成した。ただし、スループット10%以上の向上は一部のワークロードに限られており、全モデル・全量子化フォーマットで一様に同等の改善が得られるわけではない点には注意が必要だ。エンドツーエンドでは一貫した性能向上が確認されている。
残された課題
記事では課題についても率直に記述されている:
- AOTチューニングに数時間かかる:これはHelion固有の問題ではなく、同レベルの細粒度チューニングを他のカーネルDSLで行っても同等のコストが発生するとされている
- コールドスタート時のオーバーヘッド:起動時のCUDA GraphキャプチャがHelionのJITコンパイルをトリガーする。キャッシュを活用したウォームスタートで大部分を回避できる
- 設定ファイルのメンテナンス負荷:人気モデル向けの事前チューニング済み設定を継続的にメンテナンスし続けることは、CIでの網羅的な検証を難しくする
記事中ではパフォーマンス・使いやすさ・メンテナンス性のトレードオフ三角形として整理されており、最適化の恩恵と引き換えに何かを犠牲にする構造は避けられないとしている。
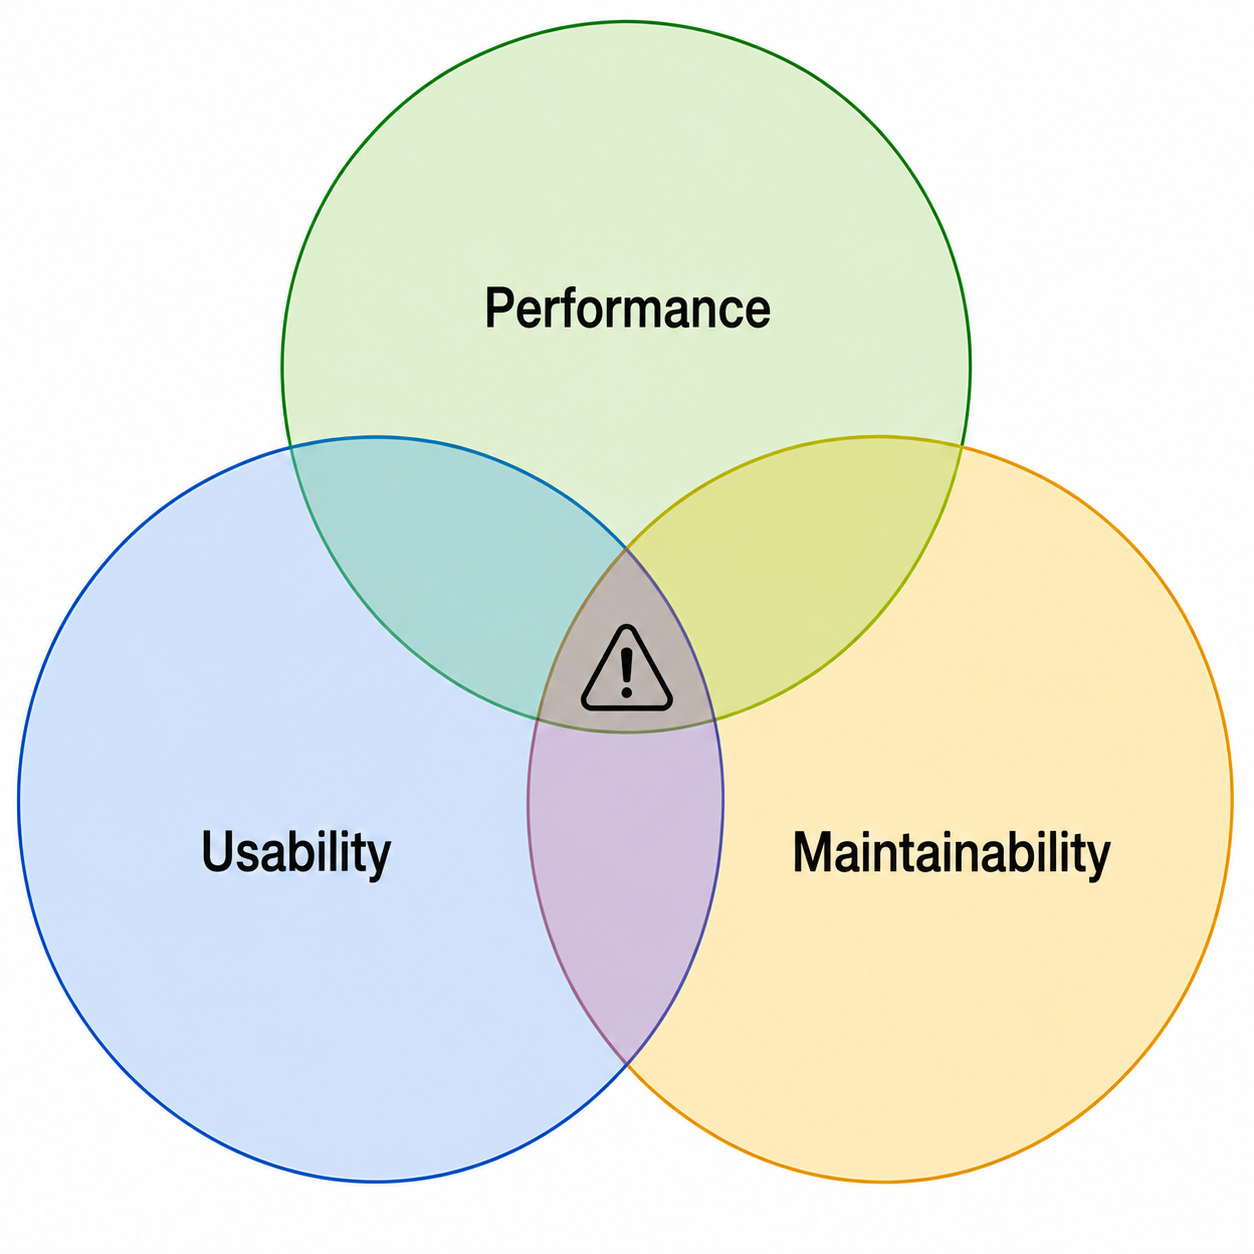
Fig. 1: パフォーマンス・使いやすさ・メンテナンス性のトレードオフ三角形
なお、NVIDIA Blackwell GPUへの対応については、HelionのCuteDSLバックエンドを使った初期検証で競争力のある結果が得られており、CuteDSLバックエンドの成熟とともに拡張される予定とされている。
詳細はBuilding a High-Performance and Portable vLLM Linear Backend with Helion – PyTorchを参照していただきたい。
