10月2日、ノーコード・ローコードのワークフロー自動化ツールとして知られるn8nが「LLM Knowledge Graph vs. Vector RAG: A Practical Guide」と題した記事を公開した。LLMのハルシネーション抑制を目的とした2つのRAGアーキテクチャ——ベクターRAGとナレッジグラフRAG——について、構造の違いから実務での使い分け基準、n8nを使った具体的な実装パターンまでを体系的に整理した内容だ。「どちらを選ぶべきか」という判断軸を3択で明確に示している点が、エンジニアにとって即座に使える指針となっている。
どちらを選ぶべきか:判断基準が核心
RAGの設計で迷うのは「ベクターRAGで十分か、ナレッジグラフが必要か」の見極めだ。記事はこの判断を以下の3択に整理している。
- ベクターRAGを使う:少数の意味的に関連するドキュメントから情報を引き出すだけでよい、シンプルでコスト効率の高い構成が求められる場合
- ナレッジグラフRAGを使う:エンティティ間の明示的な関係を辿って複雑なクエリに答える必要がある場合(複数ドキュメントにまたがる多段階推論)
- HybridRAGを使う:意味的な文書検索と関係ベースの検索、両方が必要な場合
この判断軸がエンジニアにとって即使える設計指針になっている。
ベクターRAGとナレッジグラフRAGの構造的な違い
ベクターRAGは、ユーザーのクエリをベクトルに変換し、意味的に近いテキストチャンクを取得する仕組みだ。一般的な実装では密ベクトル(意味の近さ)と疎ベクトル(キーワードマッチ)の2種類を組み合わせる2-vector searchが使われる。2-vector searchとは、ニューラル埋め込みによる意味検索(dense retrieval)とTF-IDFやBM25などによるキーワードマッチ(sparse retrieval)を並列で走らせ、その結果をマージする手法で、単一ベクトルより再現率・精度のバランスが取りやすい点が特徴だ。少数の関連パッセージに答えが収まるケースでは有効で、構築・運用コストも低い。
一方、ナレッジグラフRAG(GraphRAG)は、情報をノード(エンティティ)とエッジ(関係)の構造で表現する。事実は「主語・述語・目的語」のトリプル形式で格納される。たとえば「Customer A owns Product B」という文は、「Customer A(主語)→ owns(述語)→ Product B(目的語)」のトリプルとして記録される。
グラフ走査によって複数ソースをまたいだ多段階推論(multi-hop reasoning)が可能になるため、詐欺検知・レコメンデーションシステム・バイオメディカル研究といった複雑な用途に向いている。また、クエリがたどったグラフのパスを人間が確認できるため、医療・法務などの規制産業でのトレーサビリティ確保にも有効だ。
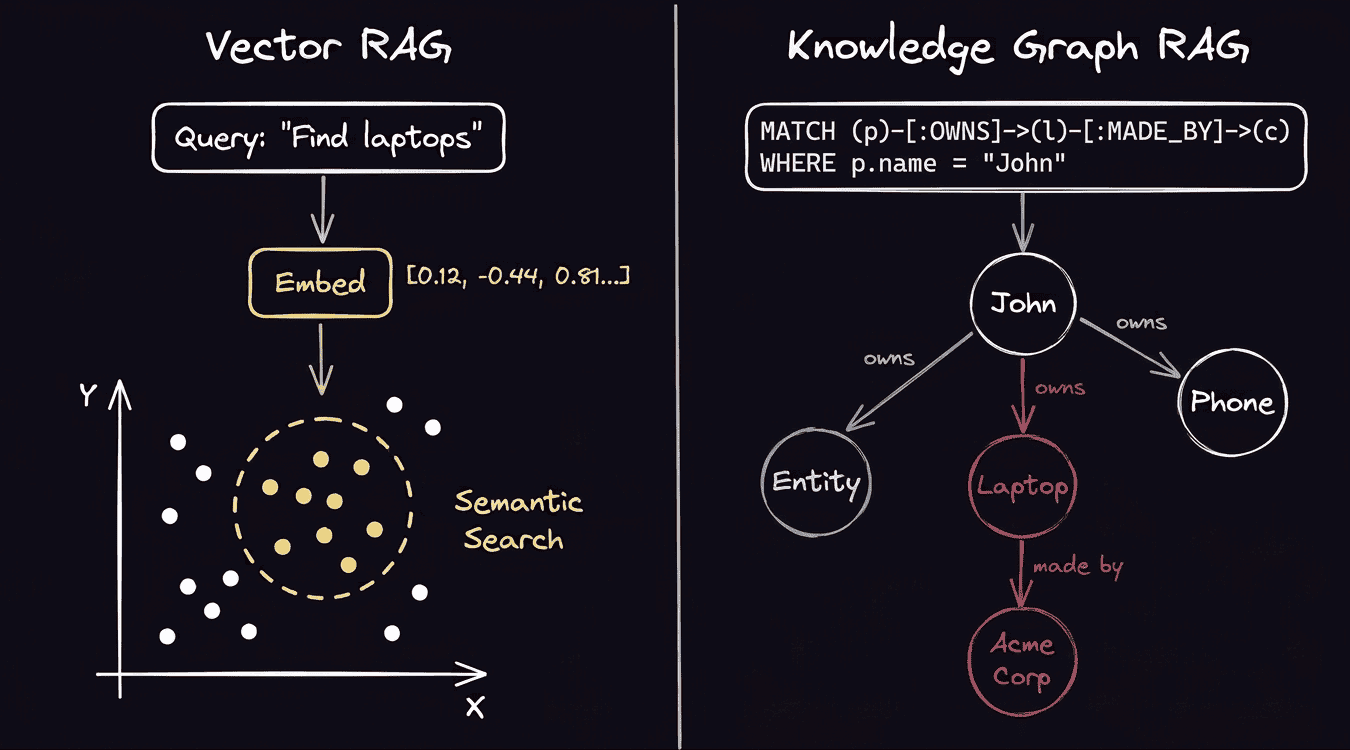
左がベクター検索(クエリを埋め込み後、類似レコードを取得)、右がグラフ検索(Cypherライクなクエリでノードと関係を取得)
ただし、ナレッジグラフはLLMへ渡す不要なコンテキストを減らせる反面、構築・運用コストはベクターRAGより高くなる点は注意が必要だ。
LLMを使ったナレッジグラフ構築のポイント
従来のナレッジグラフ構築はハードコードされた抽出ルールや専用MLモデルが必要だった。LLMはこのパイプラインの自動化を大幅に簡易化した。
構築時のポイントとして記事が強調しているのが2点ある。
エンティティ解決(Entity Resolution)の重要性:「United States of America」と「U.S.」を同一エンティティとして統合するような処理だ。これを省くとデータが断片化・重複し、グラフの品質が急速に低下する。ただし完全な自動化・無監視での運用は難しく、正規化とバリデーションが必要になる。
スキーマ方針の選択:事前にスキーマを定義する「スキーマベース」はデータの一貫性と検証のしやすさが強みだ。スキーマを定義しない「スキーマフリー」は新しい関係の発見に柔軟だが、不整合が増えやすい。製品インテリジェンスやR&Dのように変化の速いドメインではスキーマフリーが有効な場面もある。
また、業界特化ドメインで作業する際は、LLMにそのドメインのオントロジー(エンティティの種類・プロパティ・制約のブループリント)とタクソノミー(親子関係による分類体系)を事前に伝えておくと精度が上がると記事は述べている。
n8nでの実装:ベクターRAG・グラフRAG・ハイブリッド
記事後半はn8nを使った実装例に移る。n8nはノードを視覚的に接続してワークフローを構築するオートメーションプラットフォームで、セルフホスト版とクラウド版が提供されており、AIエージェントや外部APIとの連携を数百種類のインテグレーションで実現できる。RAG用途では、Pinecone・Qdrant・Supabaseへのベクターストアノードを標準で備えており、データ取り込みから検索・処理の各ステップをノードベースで視覚的に確認・編集できる点が特徴だ。
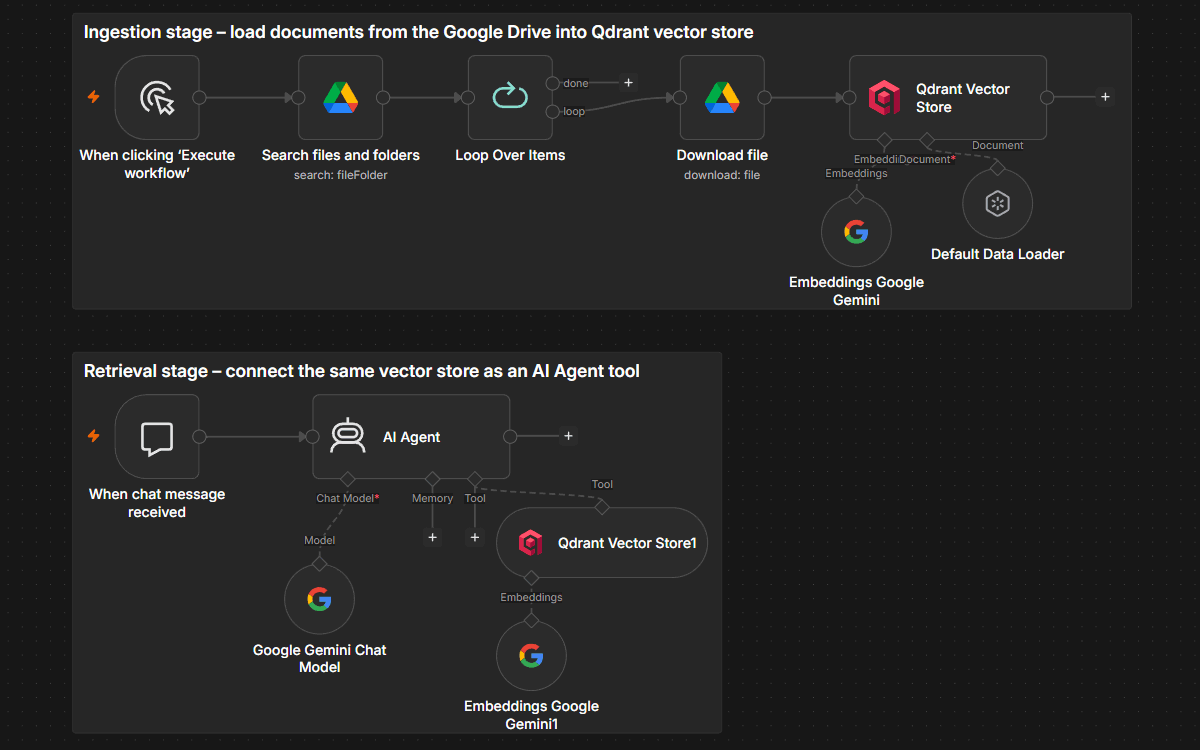
Google DriveのファイルをGemini埋め込みでQdrantに取り込む段階と、AIエージェントがそのベクターストアを検索する段階の2フェーズ構成
HybridRAGはAIエージェントノードが複数の検索ツールを束ね、意味検索とグラフ検索を使い分けることで実現する。まずベクターRAGから始め、用途の変化に応じてグラフ検索を後から追加できる設計になっており、最初からアーキテクチャを固める必要がない点は実運用上のメリットといえる。
詳細はLLM Knowledge Graph vs. Vector RAG: A Practical Guideを参照していただきたい。
