9月25日、ゲーム開発者のAdam Sawickiが「Writing Efficient C++ Code」と題した記事を公開した。元は2013年にポーランドのプログラミング誌「Programista」に掲載された記事の英語版だが、その内容は2026年の今も色褪せていない。
SawickiはCryEngineやAMDの技術にも携わったAAA/インディーゲーム開発者だ。ゲーム開発には「1フレーム33ms以内に物理演算・AI・レンダリングをすべてこなす」というリアルタイム制約があり、パフォーマンスチューニングの知見が蓄積されやすい分野でもある。13年前に書かれた記事がいま英語で公開された背景には、こうした現場知識の普遍性がある。
キャッシュミス1回で算術命令250回分が消える
この記事の核心は、現代CPUにおけるメモリアクセスコストの非対称性だ。3GHzのCPUは1命令あたり約0.33nsで動作するが、メインメモリ(RAM)へのアクセスには約83ns、つまり約250サイクル分のコストがかかる。記事中の表を引用する:
| メモリ種別 | アクセス時間 | 容量 |
|---|---|---|
| プロセッサレジスタ | 0.33 ns(1サイクル) | — |
| L1キャッシュ | 1 ns(3サイクル) | 32 KB |
| L2キャッシュ | 4.7 ns(14サイクル) | 6 MB |
| RAM | 83 ns(250サイクル) | 8 GB |
| HDD | 15 ms(4,500万サイクル) | 1 TB |
キャッシュミスが1回起きるだけで、算術命令なら250回実行できた時間が消える。連結リスト・木・グラフなど、ポインタをたどるデータ構造が遅い本質的な理由はここにある。CPUは「キャッシュライン」(典型的には64バイト)という単位でデータを転送するため、頻繁に使うデータを連続したメモリ領域に詰めるほどキャッシュヒット率が上がり、高速になる。
具体例として記事が挙げるのは「ソート済みコレクションの実装」だ。std::setやstd::mapはO(log n)の計算量を持つが、各要素がヒープ上に個別確保されポインタで連結されるためキャッシュ効率が悪い。一方、要素を一括追加後にstd::sortでソートした配列は、二分探索で同じO(log n)を達成しながら、連続メモリによりキャッシュ効率が大幅に改善される。
記事が推奨する実践的なルールをまとめると:
std::vectorや生配列など、連続メモリを使うデータ構造を優先する- 多数の小さなオブジェクトをヒープに個別確保する設計を避ける
- データをできる限り小さい型(8bitや16bit整数、ビットフィールド)に詰める。アンパックの命令コストより、キャッシュミス1回のコストの方がはるかに大きい
Data-Oriented Design:ハードウェアを意識した設計思想
記事が紹介するData-Oriented Design(DOD)は、ゲームプログラマを中心に広まった設計思想だ。「データの配置を先に設計し、アルゴリズムはその後」という考え方で、オブジェクト指向プログラミングの否定ではなく、ハードウェアの特性を意識した視点を加えるものだ。UnityがECS(Entity Component System)アーキテクチャを採用したことで広く知られるようになったが、その背景にはまさにこのキャッシュ効率の問題がある。
記事では図を用いて対比を示している:
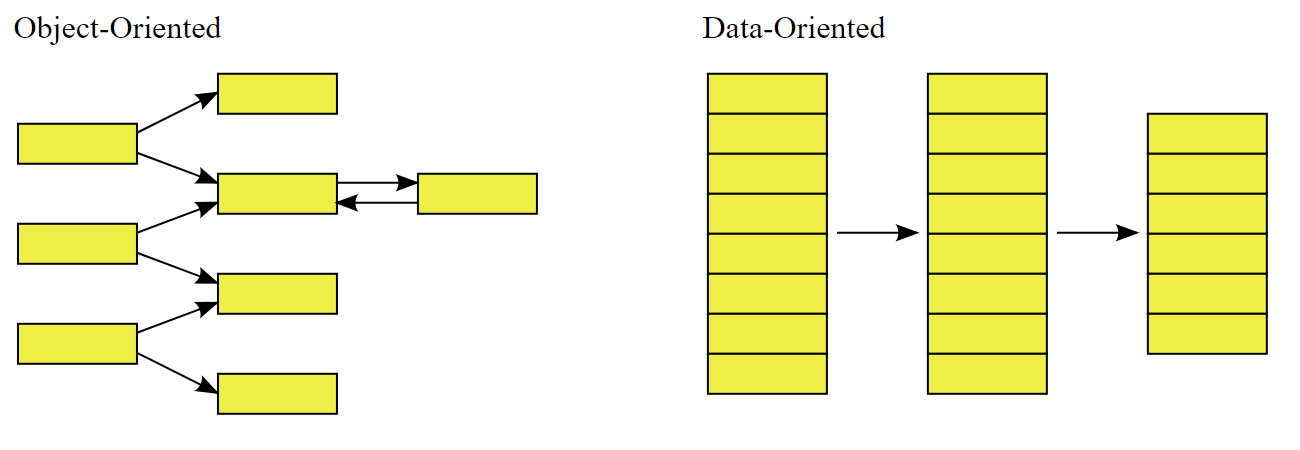
左側がポインタで相互参照し合う多数の小さなオブジェクト群、右側が配列として連続配置されたデータだ。連続配置されていれば、処理を複数スレッドに分割する際も「要素の範囲を各スレッドに割り当てる」だけで済み、並列化も容易になる。
Sawickiはさらに「何でも抽象化しようとする衝動」も批判している。ライブラリの薄いラッパーを書くこと、virtual関数で構成されたインターフェースを乱発すること、デザインパターンを深く考えずに適用すること——いずれも余分なランタイムコストを生む。「シンプルな解法が最善であることが多い」というのが記事の立場だ。
演算コストの「ピラミッド」
記事はさらに、演算の重さをピラミッドで整理している:
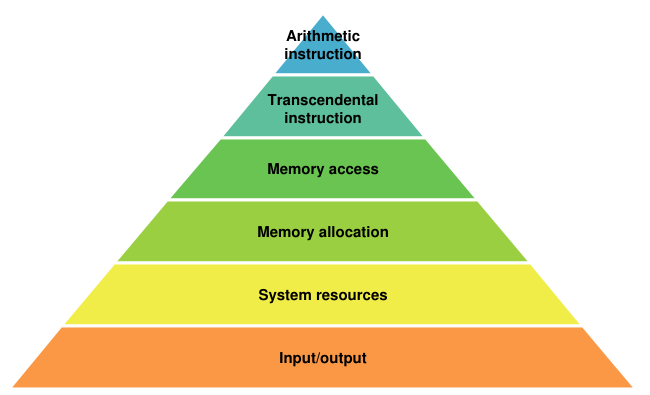
上から順に:
- 算術・ビット演算(最速)
- 超越関数・除算(sin、cos、log、sqrt など)。ループ内で同じ除数を繰り返し使う場合は逆数を一度だけ計算して乗算に置き換えるだけで、命令数を大幅に削減できる
- RAMアクセス(キャッシュミス時は数百サイクル。ここが最大のボトルネックになりやすい)
- システムコール・OSとのやり取り(カーネルモードへの切り替えコストが発生する)
- ファイルI/O・ネットワーク通信(最低速)
この階層を意識し、コストの高い操作をループの内側に置かないことが基本方針だ。
「最適化は可読性を犠牲にする」は誤りだ
記事全体を通じて一貫しているのは、「効率的なコードはシンプルで読みやすい」という主張だ。プログラムが扱うデータと操作を直接的に表現しようとすれば、自然とシンプルで効率的な設計に近づく——というのがSawickiの主張だ。「最適化 = 複雑で読みにくいコード」という通念への、実績に裏打ちされた反論である。
詳細はWriting Efficient C++ Codeを参照していただきたい。
