9月27日、The Next Webが「Markdown replaces JSON as AI's default data format」と題した記事を公開した。AIアプリケーションのインフラ層においてMarkdownがJSONに代わるデフォルトのデータ形式として台頭しつつあるトレンドについて詳しく紹介している。
なぜ今、このトレンドが加速しているのか
LLMを使ったアプリケーション開発において、入力するデータの形式がトークンコストに直結するという事実が、改めて注目されている。長年、APIのデファクトスタンダードとして君臨してきたJSONだが、AIエージェントやLLMパイプラインの文脈では、Markdownの方が構造的に優れているというコンセンサスが業界内で形成されつつある。
背景には、LLMエージェントの急速な普及がある。エージェントは外部APIやデータソースから大量の情報を取得し、それをコンテキストウィンドウに詰め込みながら推論を行う。コンテキストウィンドウのサイズには上限があり、入力トークン数がそのままAPIコストに跳ね返る構造上、「同じ情報をいかに少ないトークンで表現するか」がシステム設計の核心的な問題になってきた。JSONは人間にもプログラムにも読みやすい汎用形式だが、LLMに対して情報を渡す「コンテキスト取り込みフェーズ」においては、その汎用性がオーバーヘッドとして働く。
なぜMarkdownがLLMに向いているのか
理由は3つある。
1. 訓練データとの整合性
LLMはドキュメントサイト、READMEファイル、技術ブログ、フォーラムスレッド(forum thread)など、膨大な量のMarkdownで学習されている。そのため、モデルはMarkdownのヘッダー、リスト、テーブル、コードブロックをノイズではなく意味的なシグナルとして処理できる。
2. フロントエンドとの相性
チャットUIはMarkdownをそのままレンダリングできる。モデルがMarkdownを出力すれば、フロントエンド側で余分な変換処理が不要になる。入力と出力が同じ形式に揃うことで、入出力ループが自然になる。
3. トークン効率
JSONは構造を表現するために大量の括弧、クォート、キー名を必要とする。Markdownはその構造的オーバーヘッドを省き、情報のペイロードだけを残す。コンテキストウィンドウが限られているエージェントにとって、この差は「1リクエストあたりに詰め込める情報量」と「推論コスト」に直接影響する。
OpenAIも公式ドキュメントで推奨
この流れは推測ではなく、すでに公式ガイダンスに反映されている。OpenAIのプロンプトエンジニアリングドキュメントは、開発者向けメッセージをMarkdownのヘッダー、箇条書き、テーブルで構造化することを明示的に推奨している。具体的には、主要セクションに##、インラインコードにバッククォート、明確な階層的フォーマットを使うよう指示している。
SerpApiの実測値:「coffee」1検索で74%削減、フィルタリング併用で95%削減
最も具体的な数字を示したのが、9年の歴史を持つ検索データAPIのSerpApiだ。同社は100以上の全APIに対してMarkdown出力を追加(追加コストなし)した。
SerpApi自身のベンチマークによると、Googleで「coffee」を検索した場合のトークン数は以下のとおりだ。
| 形式 | トークン数 |
|---|---|
| JSON | 24,723 |
| Markdown | 6,435(▲74%削減) |
| Markdown+フィールドフィルタリング | 1,298(▲95%削減) |
全APIを通じた平均削減率は約**50%で、エンドポイントによっては最大91%**の削減を達成している。
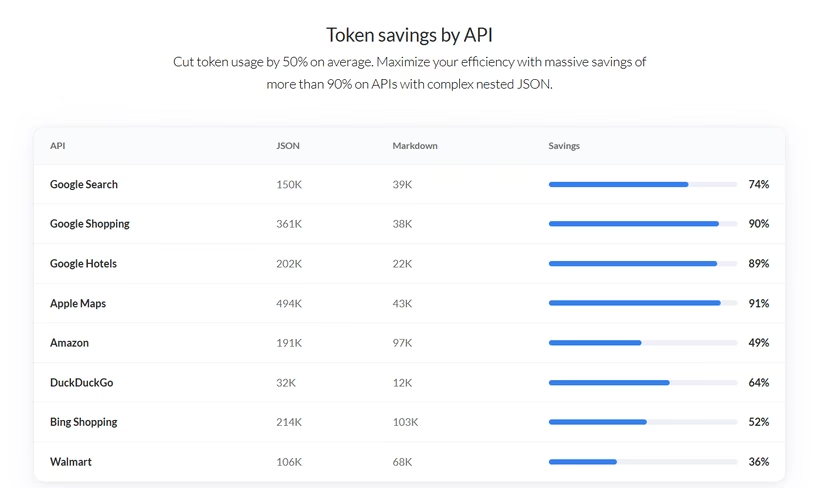
8つのAPIにおけるトークン数の比較(SerpApi提供)
なぜ検索結果でこれほど差が出るのか。JSONレスポンスにはリダイレクトリンク、ファビコン、トラッキングパラメータ、深くネストされたメタデータが大量に含まれているが、モデルがこれらを推論に使うことはない。Markdown出力はタイトル、スニペット、リンク、価格、評価といったコアな情報をテーブルやリスト形式で保持しつつ、トラッキング用ノイズや重複フィールドを自動的に除去する。
実装方法は既存のインテグレーションに対してクエリパラメータを追加するだけで、新しいエンドポイントは不要だ。
- クエリ文字列に
output=mdを追加 /search.mdルートを呼び出すAccept: text/markdownヘッダーを設定する
レスポンスにはメタデータ用のYAMLフロントマター、結果セット用の構造化Markdownテーブル、インラインリンクが含まれており、そのままプロンプトやエージェントのメモリに投入できる設計になっている。
JSONが不要になるわけではない——用途による使い分けが重要
記事の主旨を正確に伝えるために先に整理しておくと、JSONが完全に置き換わるという話ではない。プログラムによるデータ操作や厳格なスキーマ検証が必要な場面ではJSONが引き続き必須だ。この議論はあくまでもAIワークフローの「コンテキスト取り込みフェーズ」、すなわちLLMにデータを渡す場面に限定された話である点に注意が必要だ。
その前提のうえで、記事は今後の展望として以下を示している。検索・ECサイト・地図・コンテンツAPIを中心に、Markdownバリアントを提供するデータプロバイダーが増え、プロンプトテンプレートやエージェントフレームワークもMarkdownのセクション・テーブル・リストを標準的な形式として採用していくと予測している。
詳細はMarkdown replaces JSON as AI's default data formatを参照していただきたい。
