9月26日、Sydney RunkleとHunter Lovellが「Building Production Agents with Jev and LangGraph」と題した記事を公開した。この記事では、TypeSafe AIが開発した決定モデル「Jev」とLangGraphを組み合わせてプロダクション品質のAIエージェントを構築する手法について詳しく紹介されている。
「判断だけ」に特化したモデル「Jev」とは
先週、TypeSafe AIがJevを公開した。Jevは従来のLLMとは根本的に異なる。テキストを生成しない。代わりに、コードが直接処理できる構造化された決定を返す。
TypeSafeはこれを「system oneモデル」(決定モデル)と呼ぶ。心理学でいうSystem 1(速くて直感的な思考)との類推を意図した命名と思われる。状態と質問のセットを与えると、確率付きの型付き回答が返ってくる。つまり、YesかNoか、どのルートに進むか、といった「判断」に特化している。
なぜこれが重要か。フロンティアLLM(GPT-4やClaudeのような汎用大規模モデル)は、テキスト生成・情報抽出・検索・分類・リサーチなどあらゆるタスクに使われてきた。しかし、「YesかNoか」という判断に毎回フロンティアLLMを呼ぶのはコストと速度の面で非効率だ。TypeSafeのベンチマークでは、Jevはルーティングや分類ステップにおいて最大200倍高速、最大400倍安価だとされている。
なお、執筆時点でJevの一般提供状況(GA・ベータ・招待制など)や対応言語(Python/TypeScriptなど)の詳細については、TypeSafe AI公式サイトで確認されたい。
Jevの主な特性は以下の4点だ:
- 構造化: 確率付きの型付き回答を返すため、コードが予測可能に分岐できる
- 並列化: 同一の状態に対して複数の質問を同時に投げられる
- 高速・低コスト: 1回の実行で多数の決定を下せるほど安い
- 一貫性: 同じ入力に対して同じ答えを返すよう設計されている(LLMは同じ質問に異なる回答を返すことがある)
💡 LangChainチームがJevをエバリュエーター(評価者)として実験した実験結果では、100回の繰り返し実行でスコアがほとんど変動しなかった。これは、テストしたどのLLMジャッジよりも安定していた。
LangGraph:決定を「実行」に変えるオーケストレーター
Jevが「判断を安く作る」なら、LangGraphは「判断をどう組み合わせてシステムを動かすか」を担う。月間6,000万以上のダウンロードを持ち、Fortune 50企業の多くが採用している。
LangGraphアプリケーションは3つの要素で構成される:
- ノード: 処理の単位。普通のコード、モデル呼び出し、ツール呼び出し、またはサブグラフ全体
- ステート(State): ノードが読み書きする情報
- エッジ: 次にどのノードを実行するかを決める。固定パスまたは現在のステートに基づく動的なルーティング
注目すべきのは、ドメイン知識をプロンプトに詰め込む代わりに、グラフのトポロジー(どの決定をどの順番でどのステートと共に行うか)でエンコードするという設計思想だ。判断はモデルが行うが、フローはコードの中に留まり、検査・テストが可能になる。
プロダクション運用で重要なランタイム機能も揃っている:
- Durable execution: 各ステップでステートをチェックポイント保存。失敗時にゼロから再実行する必要がなく、既に下した決定を引き継いで再開できる
- Human in the loop: 人間のレビューが必要なステップで実行を一時停止し、承認後に再開できる
- オブザーバビリティ: LangSmithでトレースを確認し、何がどう決定されたかを可視化できる
LangGraphの詳細なAPIリファレンスや導入ガイドは公式ドキュメントを参照されたい。
実例:訴訟における文書レビュー
記事では、eDiscovery(訴訟における証拠開示) の文書レビューを具体例として挙げている。訴訟では相手方に開示する前にすべてのページをレビューする必要があり、1件の案件で数十万ページに及ぶこともある。
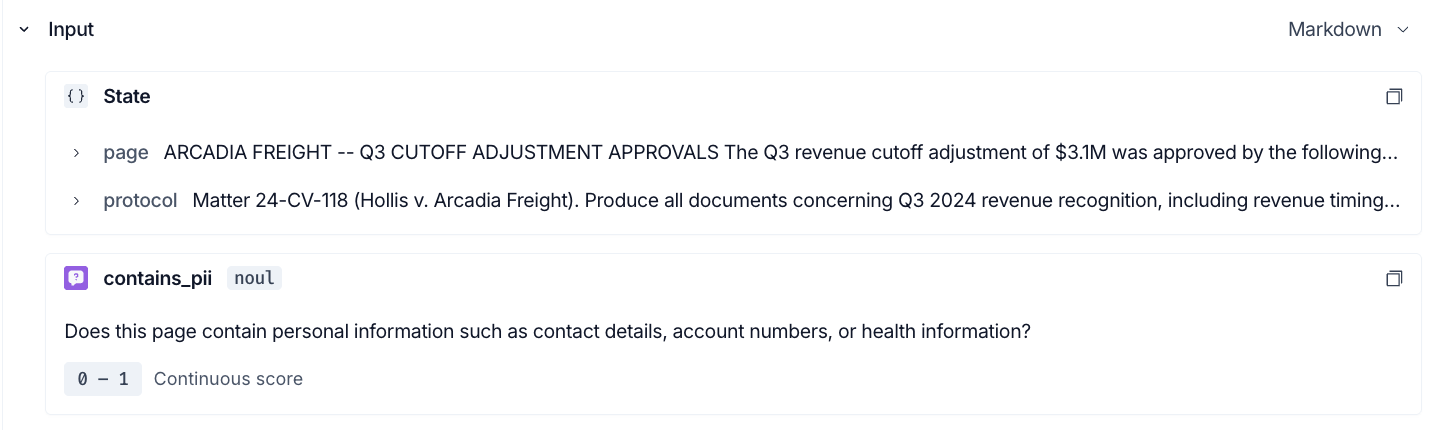
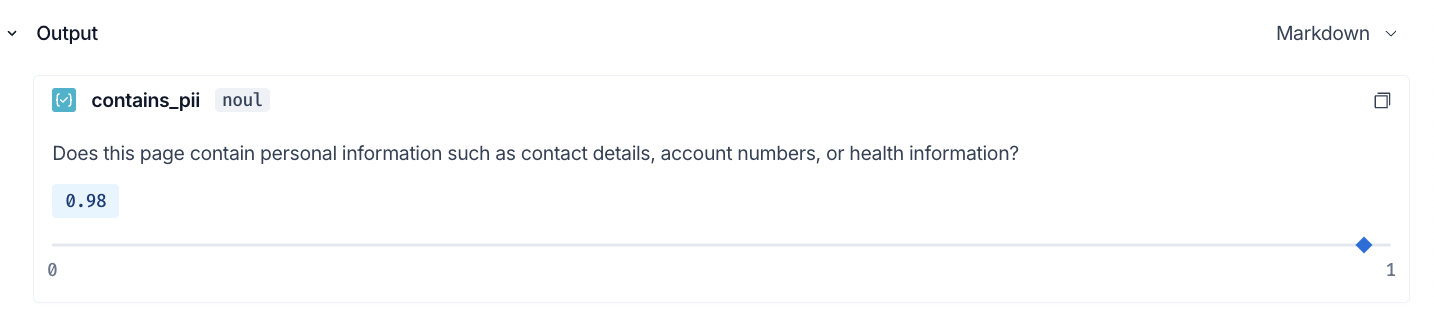
このフローではJevが1リクエストで3つの質問に同時に回答し、それぞれの答えがグラフのルートに対応する:
- このページは開示請求に該当するか? → 非該当なら除外
- 個人情報(PII)が含まれているか? → 含む場合はLLMが匿名化処理
- 弁護士秘匿特権が及ぶ可能性があるか? → 可能性があれば
attorney_reviewへ。グラフを一時停止して人間がレビュー
残ったものが開示準備完了となる。
LangChainチームは同じグラフをJevとClaude Sonnetでそれぞれ動かして比較した。結果として、分類ステップではJevはSonnetより5〜6倍高速だった。なお、記事全体で言及される速度指標は複数存在しており、分類ステップでの5〜6倍、後述するBrowserbaseの事例での約4.3倍、そしてベンチマーク上の最大200倍という数値はそれぞれ異なる条件下での計測値である点に注意が必要だ。LangSmithでは両方のトレースが確認でき、各ページがどのルートを通りどの確率で判断されたかが見える。
「インテリジェンスの大分解」が始まる
記事はこの流れを「The Great Unbundling of Intelligence(インテリジェンスの大分解)」と表現している。これまで1つのフロンティアLLMにすべてを通していたエージェントのアーキテクチャが、「その処理を最も安くこなせるモデルに割り振る」形に変わっていくというシフトだ。
ブラウザ自動化ツールStagehandを開発するBrowserbaseは、act()メソッドをJevで再実装した。Stagehandがページ上のインタラクティブ要素をマークし、Jevがアクションを選択。信頼度が0.7を下回る場合のみLLMにフォールバックする。この変更により、act()の中央値レイテンシが1.97秒から0.46秒へ、約4.3倍高速化した。
記事中にはあるデベロッパーの声も紹介されている:
「今、自分たちが持つエージェントをほぼすべて、Jevを使ったワークフローに変換しているところだ」
この「デフォルトは安く、例外時だけフロンティアモデル」という方向性は、今後のエージェント設計の基本パターンになっていく可能性が高い。
詳細はBuilding Production Agents with Jev and LangGraphを参照していただきたい。
