9月23日、Archana Kumari、Yushu Yao、Priya Lalが「AI Agent Observability: Detecting Silent AI Failures」と題した記事を公開した。この記事では、本番環境で稼働するAIエージェントが表面上は正常に見えながら実際には機能不全に陥っている「無声障害(Silent Failure)」をどう検知・対処するかについて詳しく紹介されている。ユーザーは応答を受け取れていないのに、ダッシュボードはすべて「正常」を示す——Salesforceはその見えない破綻を、どう可視化したのか。
「緑のメトリクス」は嘘をつく
従来の監視ツールには根本的な盲点がある。AIエージェントへのリクエストが到達していない場合、LLMゲートウェイが停止している場合、あるいは上流の接続が切れている場合でも、ダッシュボード上の指標は「正常」を示し続けることがある。ユーザーは応答を受け取れていないのに、運用チームは気づかない。これがSalesforceが「無声障害」と呼ぶ問題だ。
Salesforceのエンジニアリングチームはこのギャップを埋めるために、**Agentforce Health Monitoring(AHM)を構築した。AHMはSalesforceのAIエージェントプラットフォームであるAgentforce向けに設計された可観測性基盤で、エラーレート、応答・エスカレーション率、エンゲージメント、レイテンシなど16種類以上のメトリクス**を備え、特に無声障害の検知に特化したエージェント可用性メトリクスと自動アラートを実装している。ロードマップにはコスト、TTFT/TTLT(最初のトークン到達時間/最後のトークン到達時間)、毒性検知、フィードバックメトリクスの追加、さらにRAGQM(RAG品質モニタリング)との統合も控えている。RAGとは検索拡張生成(Retrieval-Augmented Generation)の略で、外部の知識ベースを参照しながら回答を生成する手法だ。
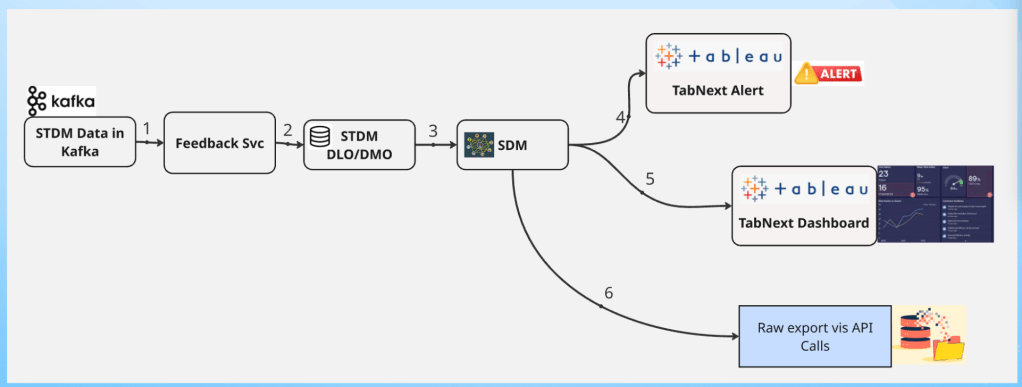
AHMのアーキテクチャ概要
最大の難所:分散したテレメトリの統合
AIエージェントの監視がなぜ難しいかを理解するには、一つのエージェントセッションがどれだけ多くの場所にデータを散らすかを知る必要がある。Agentforceの場合、セッション・推論ステップ・ツール呼び出し・エラー・エスカレーションのデータが約5〜6か所に分散して記録される。単一のイベントだけでは何が起きたかを説明できず、単一のシステムだけでは意味あるアラートの根拠にならない。
チームはこれらのシグナルを統合し、エージェントの「旅程」を一貫した形で表現してからメトリクスを導出する設計を採った。現在もハルシネーション、コンテキスト喪失、グラウンディング不良(AIの回答が参照すべき事実や文書に基づかず、根拠のない内容を生成してしまう状態)、エンドツーエンドの相関付けの実装が継続中だという。
アラートレイテンシを20分から数分へ
テレメトリの統合だけでは不十分だった。次の問題は速度だ。
当初、イベント発生からアラート到達までのエンドツーエンドのレイテンシは約20分だった。その間、障害はさらなるセッションに影響を与え続ける。チームはData 360のインジェストをストリーミング方式に切り替え、クエリの複雑さを削減することで評価頻度を上げた。結果としてレイテンシは数分に短縮された。
現在の北極星指標は「アラートメールのリンクをクリックしてから関連セッションページを表示するまで120秒以内」。現時点では人間が対応する前提だが、将来のエージェント駆動の自動対応にはさらなるリアルタイム化が必要になるとしている。
アラートの先へ:根本原因の特定まで
検知と通知だけでは運用者の仕事は終わらない。数百のエージェントが数千のインタラクションをこなす環境では、アラートから「どのセッションで」「何が起きたか」を素早く特定できなければ意味がない。
AHMはドリルダウン体験を提供しており、影響を受けたセッションと、その中で失敗が起きたステップ・フィールドを確認できる。障害原因が「不適切なコンテキスト」「知識記事の内容不足」「ツール呼び出しの失敗」「フロー設計の問題」のいずれであるかを切り分けられる。管理者が独自のメトリクスやアラートを定義する機能もあり、例えば「指定トークン数を超えたセッションを特定して原因を調査する」といった用途にも使える。
次のフェーズ:自動修復に向けて
インシデントのライフサイクルは「検知→通知→診断→修正」の4段階で構成される。現在のAHMは最初の2段階に注力しているが、チームは残りの2段階にも踏み込もうとしている。
その中核となる構想がランタイムインサイトエージェントだ。管理者がアラートの原因を自然言語で問い合わせると、根本原因の特定と推奨対応策を返してくれる仕組みを目指している。現状では熟練したエンジニアが複数のダッシュボードを横断して手動で行っている診断作業を、会話的なインターフェースで代替することが狙いだ。
さらに長期的には、障害検知→診断→対応策の提案→顧客承認のもとでの自動適用、という完全自動修復を視野に入れている。エージェントのハートビート監視、リトライ、セッションコンテキストを保持した人間へのハンドオフなども検討中だという。自動修復が実現すれば、今日は人間が20〜120秒かけて対応しているインシデントを、エージェント自身がリアルタイムで処理できるようになる。それはAIエージェントの運用モデルそのものを変える転換点になりうる。
詳細はAI Agent Observability: Detecting Silent AI Failuresを参照していただきたい。
