9月22日、n8nが「Prompt Testing Frameworks for Production AI Workflows」と題した記事を公開した。この記事では、本番AIワークフローにおけるプロンプトのリグレッションを防ぐためのテストフレームワーク構築法について詳しく紹介されている。
LLMを使ったプロダクトで「プロンプトを修正して数例確認し、良さそうならリリース」というフローを踏んでいないだろうか。この方法では見落としたリグレッションが本番環境でユーザーに露出する。プロンプトテストを「測定可能で再現性のあるプロセス」にするのがこの記事のテーマだ。
なぜ従来のソフトウェアテストがLLMに通用しないか
従来のユニットテストは「同じ入力に対して同じ出力が返る」前提で成立する。LLMはそうではない。同じプロンプトでも実行ごとに異なる応答が返り得るため、完全一致(exact-match)テストは多くのケースで機能しない。
さらに、「技術的には正しいが使えない」出力という問題もある。正しい情報を含んでいてもフォーマットが間違っている、もっともらしい文章だが重要な事実が誤っている、といったケースだ。プロンプトテストフレームワークはこうした不確実性に対応するため、代表的なサンプルへの照合と、ユースケースに本当に重要な出力の側面の計測を組み合わせる。
主要なプロンプト評価ツール
現在利用できる主要ツールは大きく2カテゴリに分かれる。
コード・CLIファーストなフレームワーク:
- Promptfoo — オープンソース。プロンプトとモデルをテストケースで比較する。CI/CDパイプラインへの組み込みを想定した設計。
- DeepEval — Pythonベース。LLM評価を通常のソフトウェアテストに近い形で扱いたいチーム向け。
オブザーバビリティ・プラットフォーム:
- LangSmith — LangChainアプリのトレーシングと評価に強み。マルチステップのエージェント実行内部を追跡したい場面で特に有用。
- Braintrust — プロンプト・モデル・データセットをまたいだ実験比較に対応。
- Langfuse / Arize Phoenix — LLMの挙動観察とアプリケーションパフォーマンスの継続的な評価に特化。
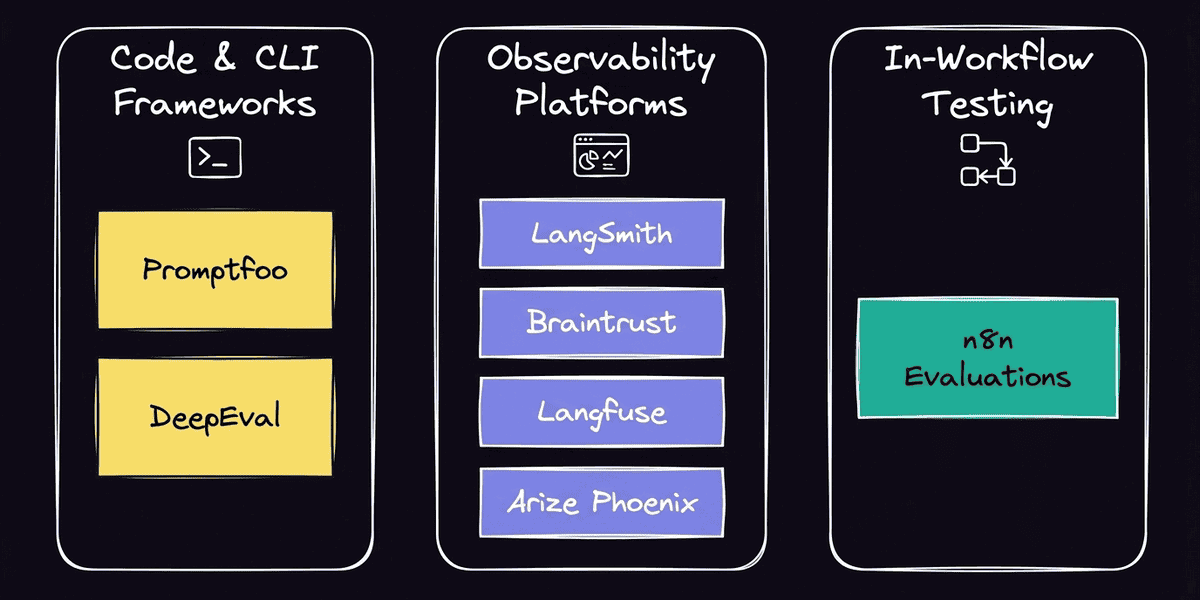
記事ではもう一つのアプローチとして、ワークフロー内にテストを組み込む方法を紹介している。n8nはfair-source(商用利用に一部制限が課される形態のオープンソース)ライセンスを採用したAIネイティブな自動化プラットフォームで、n8n Evaluationsを使うとテストデータのパイプライン実行から結果の比較まで、同一キャンバス上で完結させることができる。
スコアリングの2つのアプローチ
決定論的評価(Deterministic Evaluation)
成功条件をあらかじめ定義できる場合に有効だ。出力が期待文字列と一致するか、正しいカテゴリに属するか、といったチェックが該当する。pass/failまたは数値スコアとして一貫した結果が得られる。
n8nにはString Similarity(文字列類似度)、Categorization(カテゴリ分類)、Tools Used(使用ツール)といった組み込みメトリクスがある。正規表現による部分文字列マッチ(例: 有効な製品SKUや電話番号フォーマットの確認)など、カスタムメトリクスの作成も可能だ。
LLM-as-a-Judge
カスタマーサポートの返答を評価する場合のように、「唯一の正解」が存在しないケースがある。まったく異なる2つの回答が両方とも有用・正確ということはあり得る。こうした場面では別のLLMが生成した応答を定義済みの基準で評価してスコアを付ける「LLM-as-a-Judge」が機能する。
n8nにはCorrectness(正確性)とHelpfulness(有用性)の2つのAIベースメトリクスがあり、いずれも1〜5スケールで採点される。決定論的チェックだけでは捉えられない質を比較する際に使う。
また実践的な使い方として、本番環境ではコスト効率の高い軽量モデルを動かし、テスト時は少数の質問・回答ペアに対してより高性能なLLMをジャッジとして使うという構成も記事内で紹介されている。
n8n内でのプロンプトテスト実装
記事ではn8nを使った具体的な実装手順も示されている。
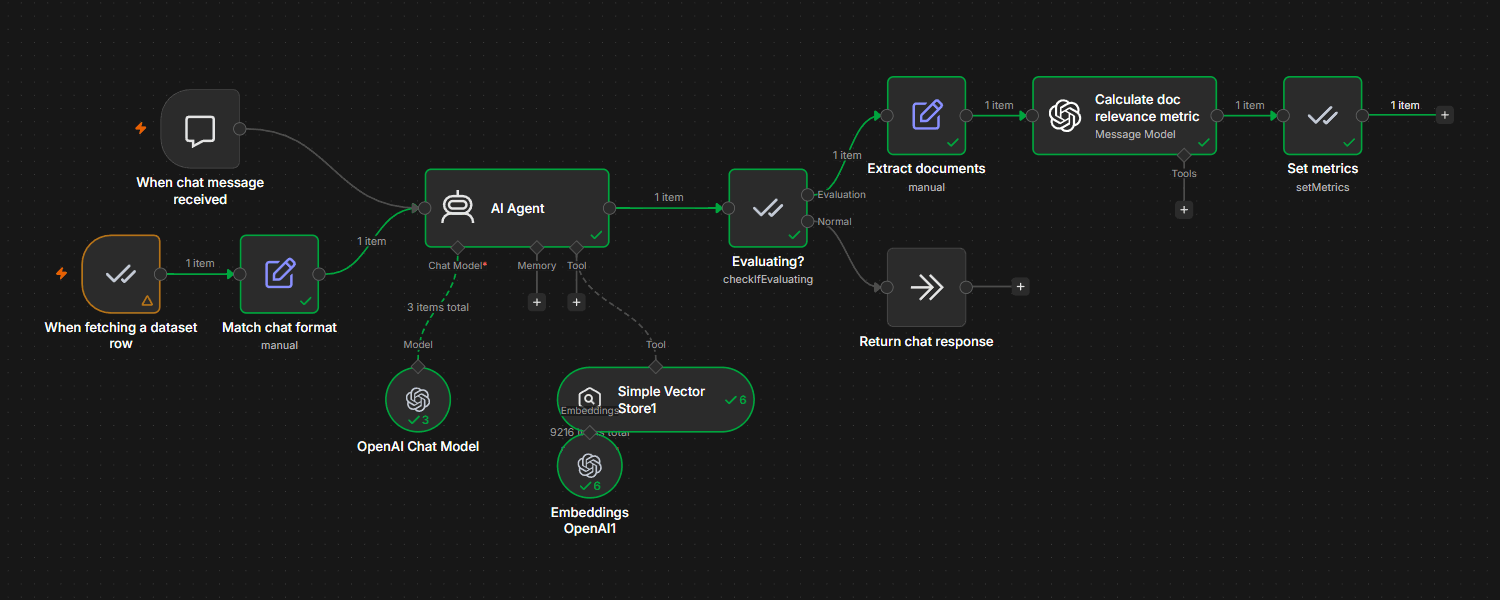
テストデータの準備 — Data TableまたはGoogle Sheetに1行1テストケースの形式で用意する。Evaluation Triggerノードが各行に対してワークフローを1回実行する。
評価パスの追加 — Evaluation nodeの「Set Outputs」で記録する値を、「Set Metrics」でスコアリングロジックを設定する。Check If Evaluatingオペレーションにより、評価ロジックは通常実行時には走らない。本番ワークフローに余計なモデルコール・レイテンシ・コストを追加しない設計だ。
リグレッション確認 — プロンプトを更新するたびに同じデータセットで再実行し、Evaluationsタブで以前のバージョンと比較する。平均スコアが改善していても重要な入力でリグレッションが隠れている場合があるため、総合メトリクスと個別テストケースの両方を確認するのがポイントだ。
より深いデバッグが必要な場合、セルフホスト版n8nはLangSmith連携によりLangChainベースのワークフローにトレーシングを追加できる(n8n Cloudでは非対応)。
まとめ
プロンプトテストは「リリース前に数例チェックする」から「ベースラインと比較する定量プロセス」へと変えることができる。ツール選択の軸として一つの整理を示すと、テストをコード・CI/CDのフローに組み込みたいチームにはPromptfooやDeepEvalのようなCLIファーストなフレームワークが向き、ノーコード・ローコードのワークフロー内で評価まで完結させたい場合はn8n Evaluationsのようなプラットフォーム統合型が実用的だ。どちらを選ぶにせよ、同じテストケースを使い続けてベースラインと比較する習慣が品質の安定に直結する。まずは手元のユースケースを5〜10件のテストデータセットに落とし込み、プロンプト変更のたびにスコアを記録するところから始めるのが現実的な第一歩となるだろう。
詳細はPrompt Testing Frameworks for Production AI Workflowsを参照していただきたい。
