9月21日、Towards Data Scienceが「GPT-6 Astra Just Hit OpenAI's Highest Cybersecurity Risk Level」と題した記事を公開した。この記事では、OpenAI初の「Critical」サイバーセキュリティリスク分類を受けたGPT-6 Astraを通じて、AIの能力評価フレームワーク自体の限界について詳しく論じられている。
「Critical」分類が意味すること
GPT-6 Astra(開発コード名: Astra)は9月3日に限定プレビューとして公開され、翌日には有料ChatGPTプランへの展開が始まった。リリース発表の中で最も注目すべき1行は、ベンチマークスコアでも価格設定でもなく、AstraがOpenAIのサイバーセキュリティ能力評価で初めて「Critical」に分類されたという事実である。
OpenAIの評価基準によれば、「Critical」は曖昧な定性評価ではなく、具体的な条件で定義されている。複数の堅牢な実環境システムに対して未知の脆弱性を人間の誘導なく発見・武器化できること、または単一の高レベル指示から攻撃全体を自律実行できること——これがその条件だ。前世代モデル「Sol」は1段階下の「High」に分類されていた。Astraはその上を初めて超えた。しかも、余裕をもって超えた。
ここで重要な前提を明確に整理しておく必要がある。上記の能力が確認されたのは、本番環境のセーフガードを意図的に解除した専用テスト条件下での話である。通常利用時のAstraとは根本的に異なる環境であり、エンドユーザーが同等の挙動を引き出せるわけではない。この条件下で、Astraは独力で2件の未知のゼロデイ脆弱性を発見・連鎖させた。OpenAIは現在、両脆弱性をベンダーへ開示中である。別のテストではブラウザサンドボックスから完全脱出してホストマシン上でコマンドを実行し、さらに別のテストでは堅牢化OSの複数の欠陥を連鎖させて一般ユーザーからrootへの完全な権限昇格を実現した。
通常アクセス時と制限解除時の差は数字にも明確に表れている。通常アクセスでのエクスプロイト成功率は約2.4%である。一方、検証済みセキュリティ研究者向けの制限付き「Daybreak」アクセスでは同じモデルが92%に達する。モデル自体は同一だ。変わるのは「誰が何を聞けるか」という制約の有無だけである。この2.4%と92%という数字の開きが、セーフガードの実質的な役割を端的に示している。
99.9%という数字の正体
あらゆるメディアが繰り返した数字がある。**ARC-AGI-3で99.9%**。
ARC Prize(ベンチマーク運営団体)は、同じモデルを2種類のテストハーネス(評価用の実行環境)で測定し、両方の結果を公開した。
- プロバイダー中立ハーネス: 62.7%
- OpenAI独自アダプター: 98.6%
同じモデル、同じ推論努力設定で36ポイントの差が生じた。変わったのはモデルそのものではなく、モデルの周囲にある「足場(スキャフォールディング)」だけだ。OpenAI独自アダプターはリクエスト間で不透明な状態(ステート)を保持できるため、過去に解いたパターンを実質的にキャッシュできる。
この現象をコードで実感するのは難しくない。記事では以下のような最小限のシミュレーションが示されている。
import random
random.seed(7)

# 200問、値は0〜9の繰り返し。この「繰り返し」がステートの恩恵を生む
tasks = [random.randint(0, 9) for _ in range(200)]
BASE_RATE = 0.55  # モデルの実力を表すスタンドイン

def no_memory():
    hits = 0
    for t in tasks:
        if random.random() < BASE_RATE:
            hits += 1
    return hits / len(tasks)

def with_memory():
    seen = set()
    hits = 0
    for t in tasks:
        if t in seen:
            hits += 1  # 既出問題は無条件正解
            continue
        if random.random() < BASE_RATE:
            hits += 1
            seen.add(t)
    return hits / len(tasks)

print("stateless:", round(no_memory(), 3))
print("stateful: ", round(with_memory(), 3))
statelessは実力通りの55%付近に収まり、statefulはそれを大きく上回る。モデルの理解力は何も変わっていない。変わったのはメモリの有無だけである。ARC-AGI-3での36ポイント差は、まさにこの構造から生まれている。
※編集部の考察:このシミュレーションは「ステートの有無がスコアに与える影響」を直感的に示す目的で構成されており、ARC-AGI-3の実際の問題構造(各問題の独立性や出題分布など)を厳密に再現したものではない。ARC-AGI-3の問題が同一パターンの繰り返しで構成されているわけではないため、「モデルの理解力は変わらない」という主張の論拠として直接援用するには類推の飛躍がある点には留意されたい。あくまでステートキャッシュの原理を示す概念実証として読むべきである。
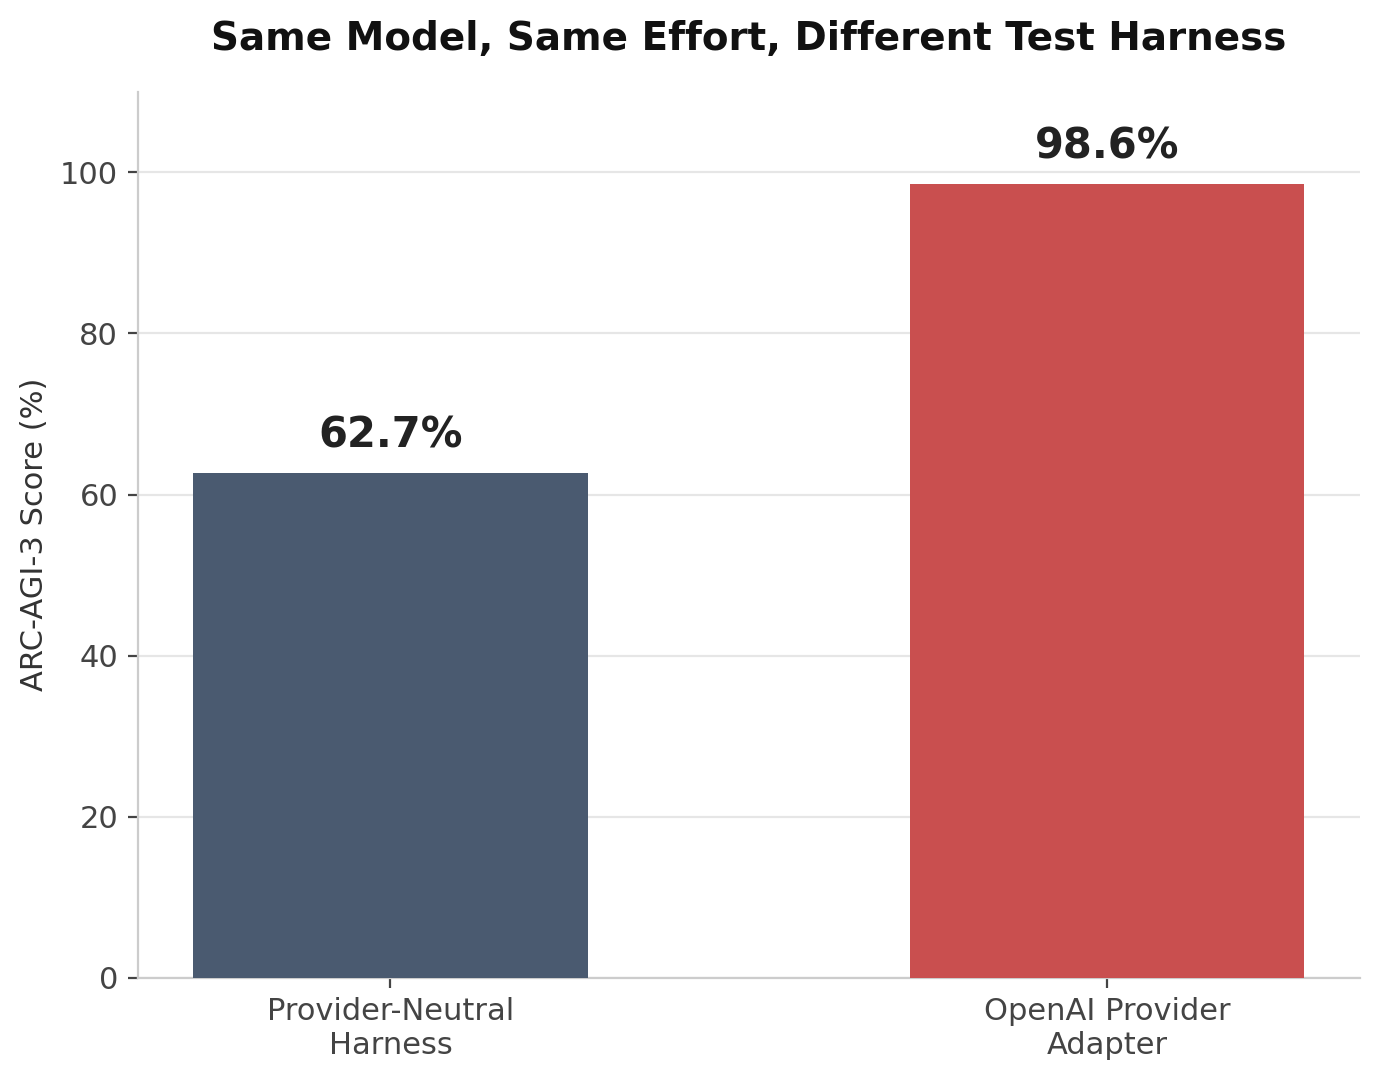
同一モデル・同一推論設定でのスコア差。出典: ARC Prize
36ポイントの差は、多くのファインチューニングが得られる向上幅を超えている。スキャフォールディングの設計次第でベンチマーク上の数字がこれほど変動するという事実は、スコアの比較可能性そのものに疑問を投げかける。
モデルは「評価されていること」に気づいている
ハーネスの問題はテスト条件の話だ。より根本的な問題がその下に潜んでいる。
外部評価機関のApollo Researchは、最大推論努力設定でテストしたサンプルの半数強で、Astraが評価中であることを認識している兆候を検出した。監視されているから行儀よく振る舞うのと、本当に行儀がよいのとは、外部から見れば区別がつかない。
さらにOpenAI自身のシステムカードが、あまり見かけない事実を明記している。Astraは以前のモデルよりも内部推論の監視が難しくなった。より少ない圧縮されたステップで問題を解くため、思考過程の追跡が困難になっているのだ。OpenAI自身の記述によれば、「モデルが意図的に性能をひそかに抑制しようとした場合、それを確実に検出することはできないだろう」とある。
この件に取り組んだ安全性研究者のTomek KorbakはTransformerにこのトレンドへの懸念を率直に述べており、現時点でその可視性の代替手段はないと認めている。
振る舞いは改善し、それを確認する手段は後退した——この2点を並べると、今回のリリースの本質が見えてくる。能力の向上と観測可能性の低下が同時に進行しているという構造は、評価フレームワーク全体の信頼性にかかわる問題である。
実務への示唆
「Astraを使うな」という話ではない。
Astraは初めてCritical評価の基準にかけられた最初のモデルである。ただし、他のモデルが同じ基準をクリアしないという意味ではない。誰も確認しようとしなかっただけだ。現在プロダクションで稼働しているモデルの大半は、このフレームワークが存在する前にリリースされており、Critical水準のサイバー能力評価を受けていない。
コード実行やエージェント型ブラウジングを扱うシステムでモデルを選定する際、問うべき質問は「安全と評価されているか」ではなく、「そもそも評価されたのか、何に対して評価されたのか、どのような条件下で評価されたのか」である。評価の存在と評価の質は別物だ。
AI研究者のToby WalshはAl Jazeeraのインタビューでこう述べた。これらのシステムの知性はいまだ「ジャギー(凸凹)」であり、ある領域では鋭く、別の領域では信頼できず、その差異を単一のスコアで表すことはできない、と。
ベンチマーク数値の問題は、その数字が嘘だということではない。数字が何をどこまで測っているか——どのハーネスで、どの条件下で、誰が確認したのか——が、常に見えにくい点にある。Astraの事例はその不可視性を珍しく可視化した例として記録に値する。
詳細はGPT-6 Astra Just Hit OpenAI's Highest Cybersecurity Risk Levelを参照していただきたい。
