9月14日、Anthropicが「Agentic coding is straining CI. Here's how we scaled test impact analysis at Anthropic」と題した記事を公開した。AIエージェントによるコード生成の急増がCI(継続的インテグレーション)に与える負荷と、それを乗り越えるためにAnthropicがテスト影響分析サービスを再設計した実践的な記録だ。
AIエージェントが自律的にコードを書く時代においては、「コードを書く速度」そのものはボトルネックでなくなる。代わりに詰まるのが、その変更を検証するCIパイプラインだ。人間のエンジニアが書くコードを前提として設計されたCIは、エージェントが生成するPRの物量を前にして、従来の延長線上の運用では追いつかなくなる。この記事はその問題に正面から向き合った実例として、多くのエンジニアリングチームにとって参考になる内容を含んでいる。
2四半期でCIジョブが25倍に膨れ上がった
Anthropicのエンジニアは、2021〜2025年の水準と比べて1人あたり四半期に8倍のコードをリリースするようになった。そのうち80%はClaudeが書いたコードであり、PRのレビューと承認にもClaudeが深く関与している。
コードを書くこと自体がボトルネックでなくなった結果、次に詰まるのがCIだ。テストの総数は10倍に増加し、エンジニア数はほぼ横ばい。これらが重なり、2四半期でCIジョブ数が25倍に達した。
この急増が、Anthropic社内のテスト影響分析(Test Impact Analysis)サービスを繰り返し断続的に限界まで追い込んだ。
テスト影響分析とは何か
全テストを全PRに対して実行するのは、規模が大きくなると非現実的だ。CIのゲートが長くなり、コストがかさみ、信頼性も落ちる。
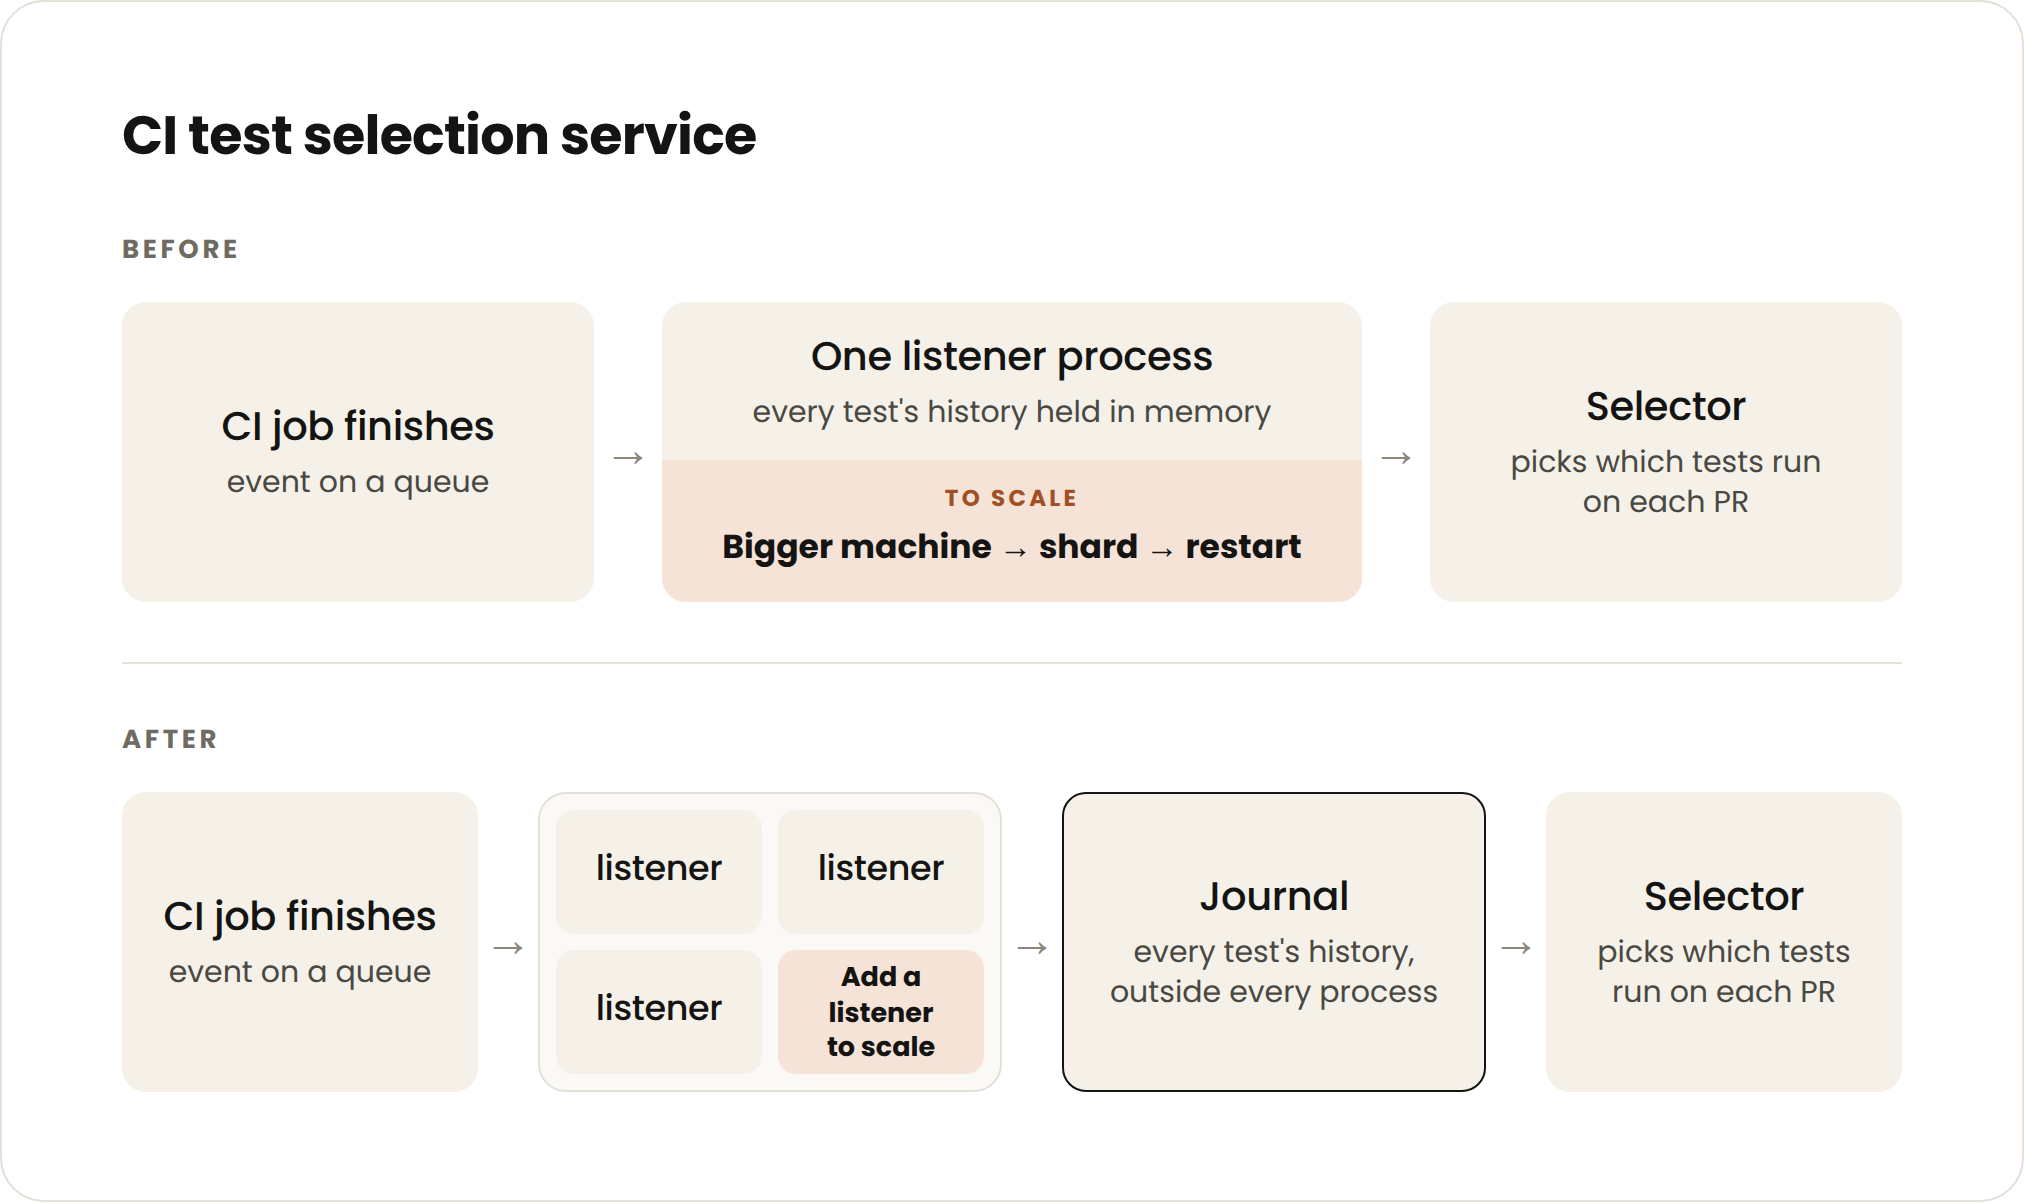
Anthropicは「どのテストをどのPRで走らせるか」を決定する決定論的なテスト選択サービスを構築している。構成要素は2つだ:
- リスナー:すべてのCIジョブの実行結果を記録する
- セレクター:リスナーの履歴を読み取り、各PRで実行すべきテストを決定する
問題は、CIジョブが毎秒複数走る状況ではリスナーがPRキューに追いつけなくなることだ。20分のリスナーラグが、数万件のテスト更新の未反映につながる。その結果:
- 壊れた変更がマージされると、他全員のテストが落ち始め、不要な調査が発生する
- 依存関係のフレーキー(不安定)化が検知されずマージをブロックする
- 修正済みのテストや新規テストが、リスナーが追いつくまで実行されない
このサービスはシングルプロセスで動く設計だったため、水平スケールアウトが不可能という根本的な制約を抱えていた。
3回のパッチ、そして設計の全面見直し
パッチ1:マシンを増強(効果:70日)
最初の対処はシンプルにCPUコアを2倍にする増強だ。効果はあったが、トレンドラインは明確だった——これは時間稼ぎにすぎない。
パッチ2:シャーディング(効果:29日)
次に頻繁にアラートが飛ぶようになり、チームはClaudeとの長期セッションを立ち上げてサービスのモニタリングを行った。これはツールや自動化フローではなく、エンジニアがClaude(チャット)を常時開いた状態で状況を共有し続けるという作業スタイルだ。リスナーの未処理ジョブが5万件を超えるとClaudeが通知し、対応策を一緒に検討する体制を取った。
Claudeはこの時点で「全面的な設計見直し」を推奨していたが、チームは別のパッチを選んだ。パッケージごとに独立したワーカーシャードを持つ並列処理に変更。Claudeがコードを生成した。
しかし買えた時間はわずか29日だった。
パッチ3:毎日の再起動(効果:1日未満)
3月には平日の午後にはほぼ毎日メモリ上限に達する状態になった。バグ修正、メモリアロケーターの変更、プロファイリングを試みたが効果はなく、再起動すら1日も持たなかった。
さらに、再起動によってリスナーが1時間以上遅延すると、大量のジョブ結果が記録されない問題も判明した。これはコードがテストされずに本番に出るという意味ではなく、テスト選択コンポーネントが古いデータで判断を下すという問題だ。結果として、すでに広範囲で失敗しているテストをわざわざ実行するようになっていた。
最終的な設計:ステートレス+インメモリストアのジャーナル
Claudeが一貫して勧めていたサービスの全面再設計に踏み切った。核心は「プロセスからステート(状態)を追い出す」ことだ。
新アーキテクチャの構成:
- 各リスナーワーカーはジョブ結果を受け取り、インメモリデータストアのジャーナルに追記して終了(メモリを保持しない=ステートレス)
- 別の小さなコンシューマープロセスが数秒ごとにジャーナルをテスト履歴へ集約
- セレクターはその履歴を高速に参照する
ここで言う「インメモリデータストア」とは、プロセスのヒープではなく外部の高速なストレージ層にジョブ結果のログ(ジャーナル)を書き出す構成を指す。元記事では具体的なOSSやミドルウェア名は明示されていないが、RedisのStreamsやAppend-Only Log(AOF)に近い概念として理解するとイメージしやすい。リスナーはジャーナルへの追記のみを担い、状態を持たないため、インスタンスを並列に増やしても干渉が起きない。これが水平スケールアウトを可能にする設計の核心だ。
再設計に要した時間はエンジニア1人で3週間。1年前なら1四半期かかっていたと筆者は述べている。ジャーナルのサイジングやワーカー数のチューニングはClaudeがほぼ自律的に実施し、移行後はサービスが安定した状態を維持している。
「常に指数的な成長を想定せよ」
筆者が最大の教訓として挙げるのは、AIによる指数的な成長を設計に織り込むことだ。エージェントがコードを書き、PRを作り、レビューを加速させる環境では、CIへの負荷は線形ではなく指数的に増える。
具体的なアドバイスとして以下が挙げられている:
- v0設計の時点で10〜20倍のスケールを想定する(予算が許す限り)。過剰設計というコンセプト自体の基準が大幅に上がっている
- サービスはClaude(AI)の目と耳として機能させる。監視の仕組みを整えることで、AIが問題を段階的に検知・修正できる
- プロセス外にステートを置く。シングルインスタンスで重要なサービスを動かすなら、計測とカナリアリリースが必須
Anthropicの「2四半期で25倍」という実績は、多くのチームにとって他人事ではない。AIエージェントを本格導入するほど、同じ問題に早晩直面する可能性が高い。
詳細はAgentic coding is straining CI. Here's how we scaled test impact analysis at Anthropicを参照していただきたい。
